运行图文输入模型的 llama.cpp 更改了 LFM2 系列的图像分块和尺寸计算。提示令牌数和请求耗时会随图像尺寸减少或增加,需要重新检查既有评估和时间预算。对比基准是 Transformers 库的 Python 图像处理代码。
3 项核心变更
拉伸分块。大图会被分成 512x512 分块和一张小尺寸全图预览。此前大多保持宽高比并用黑色填充空白,现在全部拉伸以适应分块网格。在 PR #30261 对 LFM2.5-VL-450M 和 1024x768 图像的测量中,与 Transformers 不同的分块像素值比例从 97.5% 降至 0。
按 Python 的方式计算布局。恰好为一半时向偶数舍入,并提高了小数计算精度。在宽高各为 1~4096 的范围内,此前有 31,926 种尺寸的预览尺寸或分块网格不同,现在已与参考代码一致。400x600 的预览从 416x608 变为 384x608,720x1600 的网格从 2x5 变为 2x4 个分块。
仅修改 LFM2 代码。变更仅适用于 LFM2 预处理,其他模型路径保持不变。测试新增了基于 Transformers 数值的 4 个缩略图尺寸用例和 4 个网格用例。旧代码未通过这些测试中 13 项检查中的 6 项。
数据表现
PR #30261 作者将 master 50e3e3e48 和修改版与 Python 参考代码进行了比较。概率比较对象不同的两组应分开看。
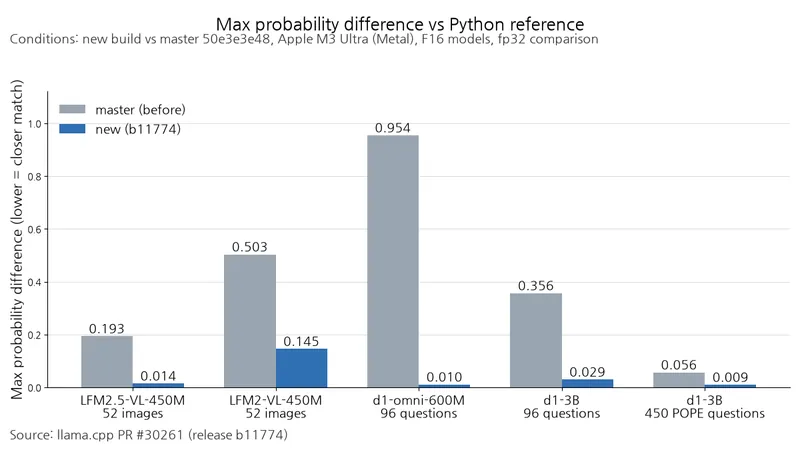
表:LFM2 系列相对于 Python 参考实现的最大概率差和提示长度不匹配情况
条件:依据 PR #30261 测量,比较 master 50e3e3e48 与修改版,Apple M3 Ultra(Metal),F16 模型,fp32 对比。以 Transformers 排名前 20 的下一令牌为基准。
单位:概率差为比例,不匹配项数为个
| 模型·测试集 | 最大概率差 · master | 最大概率差 · 修改版 | 提示长度不匹配项 · master → 修改版 |
|---|---|---|---|
| LFM2.5-VL-450M, 52张 | 0.193 | 0.014 | 14 → 0 |
| LFM2-VL-450M, 52张 | 0.503 | 0.145 | 14 → 0 |
表:d1 系列相对于 Python 参考实现的最大概率差和提示长度不匹配情况
条件:依据 PR #30261 测量,比较 master 50e3e3e48 与修改版,Apple M3 Ultra(Metal),F16 模型,fp32 对比。以全部候选答案为基准。
单位:概率差为比例,不匹配项数为个
| 模型·测试集 | 最大概率差 · master | 最大概率差 · 修改版 | 提示长度不匹配项 · master → 修改版 |
|---|---|---|---|
| d1-omni-600M, 96题 | 0.954 | 0.010 | 42 → 0 |
| d1-3B, 96题 | 0.356 | 0.029 | 36 → 6 |
| d1-3B, 450 POPE 题目 | 0.056 | 0.009 | 5 → 0 |
五种模型与测试组合中,有四种消除了提示长度不匹配。LFM2-VL-450M 残留的概率差是由于公开的 mmproj 缺少缩放设置,因而使用线性插值。在像参考代码一样指定 bicubic 的比较中,差值为 0.444 → 0.003。
测量中,令牌数与请求耗时的变化方向一致。
表:不同图像尺寸的提示令牌数和总请求耗时变化
条件:依据 PR #30261 测量,比较 master 50e3e3e48 与修改版,F16,-np 1,H100 GPU(CUDA) 和 30 核 Xeon 8358(CPU)。
单位:令牌为个,请求耗时变化为 %
| 图像 | 提示令牌 · master → 修改版 | CUDA·LFM2.5-VL | CUDA·d1-3B | CPU·LFM2.5-VL | CPU·d1-3B |
|---|---|---|---|---|---|
| 504x1120 | 2817 → 761 | -65.0% | -69.4% | -73.6% | -72.6% |
| 720x1600 | 2817 → 2303 | -16.6% | -17.3% | -16.3% | -17.8% |
| 1000x1200 | 1797 → 2568 | +29.9% | +36.4% | +43.0% | +42.9% |
| 560x960 | 771 → 1799 | +90.6% | +111% | +124% | +131% |
请求耗时与令牌数的变化方向一致。504x1120 的令牌大幅减少,耗时也大幅下降;560x960 的令牌增加,耗时也增加。640x480·1024x768·2000x1500·3024x4032 的令牌数不变,CUDA 耗时变化为 -2.8%~+0.8%,CPU 则在噪声范围内。关于图像拉伸开销,PR 作者在 LFM2.5-VL·CUDA 构建中的测量显示,1024x768 图像预处理耗时从 31.0ms 降至 25.9ms。
升级方法
在 b11774 中,可通过 -hf 加载 LFM2 模型。
llama-server -hf LiquidAI/LFM2.5-VL-450M-GGUF:F16 --port 8080 &在布局发生变化的尺寸中,27,834 种的令牌数最多减少 2,048 个,4,092 种则增加。增量大多低于 100 个,但有 523 种增加了 256~1,024 个。
d1-3B 自带的运行器会先缩小超过 1 百万像素的图像,与处理完整图像的参考代码不同,因此 96 题中仍有 6 项长度不匹配。发生变化的 6 项中,3 项变差(最大概率差 0.019 → 0.029),3 项改善。
对谁重要
此前的 PR #27057 将分块判定依据从边长改为像素面积。此次则对齐了分块内容以及网格和预览尺寸的计算。
如果你正在用 llama.cpp 运行 LFM2 系列,可以升级至 b11774,用相同图像对照 Transformers 的输出,并根据不同图像尺寸的令牌数变化重新计算请求时间预算。