이미지와 텍스트를 함께 받는 모델을 실행하는 llama.cpp가 LFM2 계열의 이미지 분할·크기 계산을 바꿨다. 이미지 크기에 따라 프롬프트 토큰 수와 요청 시간이 줄거나 늘어, 기존 평가와 시간 예산을 다시 확인해야 한다. 비교 기준은 Transformers 라이브러리의 파이썬 이미지 처리 코드다.
핵심 변경 3가지
타일을 늘린다. 큰 이미지는 512x512 타일과 작은 전체 미리보기로 나뉜다. 기존에는 대부분 비율을 유지하고 빈 곳을 검게 채웠지만, 이제 모두 타일 격자에 맞춰 늘린다. PR #30261의 LFM2.5-VL-450M·1024x768 이미지 측정에서 Transformers와 다른 타일 픽셀 값은 97.5%에서 0으로 줄었다.
레이아웃을 파이썬처럼 계산한다. 정확히 절반이면 짝수 쪽으로 반올림하고 소수 계산 정밀도를 높였다. 가로·세로 각각 1~4096 범위에서 31,926개 크기의 미리보기 크기나 타일 격자가 달랐는데, 이제 참조 코드와 일치한다. 400x600 미리보기는 416x608에서 384x608로, 720x1600의 격자는 2x5에서 2x4타일로 바뀐다.
LFM2 코드만 건드렸다. 변경은 LFM2 전처리에만 적용됐고 다른 모델 경로는 그대로다. 테스트에는 Transformers 값 기준 썸네일 크기 4건과 그리드 4건이 새로 들어갔다. 이전 코드는 이 테스트의 13개 검사 중 6개를 실패했다.
숫자로 보면
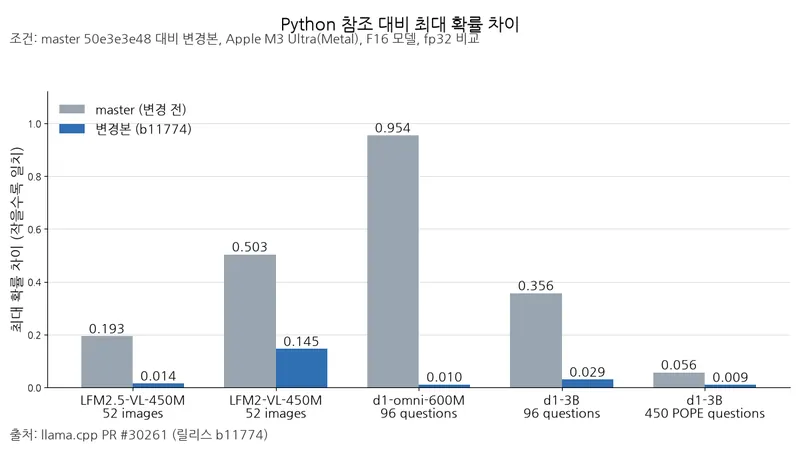
PR #30261 작성자는 master 50e3e3e48과 변경본을 파이썬 참조 코드와 비교했다. 확률 비교 대상이 다른 두 집단은 나눠 봐야 한다.
표: LFM2 계열의 파이썬 참조 구현 대비 최대 확률 차이와 프롬프트 길이 불일치
조건: PR #30261 측정 기준, master 50e3e3e48 대비 변경본, Apple M3 Ultra(Metal), F16 모델, fp32 비교. Transformers 상위 20개 다음 토큰 기준.
단위: 확률 차이는 비율, 불일치 항목 수는 개
| 모델·테스트 세트 | 최대 확률 차이 · master | 최대 확률 차이 · 변경본 | 프롬프트 길이 달라진 항목 · master → 변경본 |
|---|---|---|---|
| LFM2.5-VL-450M, 52장 | 0.193 | 0.014 | 14 → 0 |
| LFM2-VL-450M, 52장 | 0.503 | 0.145 | 14 → 0 |
표: d1 계열의 파이썬 참조 구현 대비 최대 확률 차이와 프롬프트 길이 불일치
조건: PR #30261 측정 기준, master 50e3e3e48 대비 변경본, Apple M3 Ultra(Metal), F16 모델, fp32 비교. 답 후보 전체 기준.
단위: 확률 차이는 비율, 불일치 항목 수는 개
| 모델·테스트 세트 | 최대 확률 차이 · master | 최대 확률 차이 · 변경본 | 프롬프트 길이 달라진 항목 · master → 변경본 |
|---|---|---|---|
| d1-omni-600M, 96문항 | 0.954 | 0.010 | 42 → 0 |
| d1-3B, 96문항 | 0.356 | 0.029 | 36 → 6 |
| d1-3B, 450 POPE 문항 | 0.056 | 0.009 | 5 → 0 |
다섯 모델·테스트 조합 중 네 조합에서 프롬프트 길이 불일치가 사라졌다. LFM2-VL-450M에 남은 확률 차이는 공개 mmproj의 크기 조절 설정이 빠져 선형 보간을 쓰기 때문이다. 참조 코드처럼 bicubic으로 지정한 비교에서는 0.444 → 0.003이었다.
측정에서는 토큰 수와 요청 시간이 같은 방향으로 변했다.
표: 이미지 크기별 프롬프트 토큰 수와 전체 요청 시간 변화
조건: PR #30261 측정 기준, master 50e3e3e48 대비 변경본, F16, -np 1, H100 GPU(CUDA)와 30코어 Xeon 8358(CPU).
단위: 토큰은 개, 요청 시간 변화는 %
| 이미지 | 프롬프트 토큰 · master → 변경본 | CUDA·LFM2.5-VL | CUDA·d1-3B | CPU·LFM2.5-VL | CPU·d1-3B |
|---|---|---|---|---|---|
| 504x1120 | 2817 → 761 | -65.0% | -69.4% | -73.6% | -72.6% |
| 720x1600 | 2817 → 2303 | -16.6% | -17.3% | -16.3% | -17.8% |
| 1000x1200 | 1797 → 2568 | +29.9% | +36.4% | +43.0% | +42.9% |
| 560x960 | 771 → 1799 | +90.6% | +111% | +124% | +131% |
요청 시간 변화는 토큰 수 변화와 방향이 같았다. 504x1120은 토큰이 크게 줄면서 요청 시간도 크게 떨어졌고, 560x960은 토큰이 늘면서 시간이 늘었다. 640x480·1024x768·2000x1500·3024x4032는 토큰 수가 그대로여서 CUDA 기준 -2.8%~+0.8%, CPU 기준 노이즈 범위였다. 이미지를 늘리는 비용은 PR 작성자의 LFM2.5-VL·CUDA 빌드 측정에서 1024x768 이미지 전처리 시간이 31.0ms에서 25.9ms로 줄었다.
업그레이드 방법
b11774에서 LFM2 모델은 -hf로 불러올 수 있다.
llama-server -hf LiquidAI/LFM2.5-VL-450M-GGUF:F16 --port 8080 &레이아웃이 바뀐 크기 가운데 27,834개는 토큰이 최대 2,048개 줄고, 4,092개는 늘었다. 증가분은 대부분 100개 미만이지만 523개는 256~1,024개 늘었다.
d1-3B 자체 러너는 1메가픽셀 초과 이미지를 먼저 축소하므로 전체 이미지를 처리하는 참조 코드와 달라, 96문항 중 6건의 길이 불일치가 남았다. 바뀐 6개 항목 중 3개는 악화(최대 확률 차이 0.019 → 0.029), 3개는 개선됐다.
누구에게 중요한가
앞선 PR #27057은 타일링 판정을 변 길이에서 픽셀 면적 기준으로 바꿨다. 이번에는 타일 내용과 격자·미리보기 크기 계산을 맞췄다.
지금 LFM2 계열을 llama.cpp로 돌리고 있다면 b11774로 올려 같은 이미지를 Transformers 출력과 맞춰 보고, 이미지 크기별 토큰 수 변화만큼 요청 시간 예산을 다시 계산하면 된다.