在单台 AMD Strix Halo 上运行本地语言模型及辅助任务的 halogen-flash-server 于 2026年10月20日发布了 0.18.12。项目公告称,已加载的辅助模型启动等待时间缩短,并可进行合并多张照片的编辑。Flash 检查点(模型权重文件)保持不变。
四图编辑与 NPU 启动等待缩短
多图编辑。现在可同时发送多张图片,进行将一张照片中的物体放入另一张照片等编辑。/v1/images/edits 现可接收 1~4 个 image 部分,提示词按发送顺序用 "image 1"、"image 2" 等指代图片。该功能请求来自 GitHub 议题 #179,提出者希望将一张照片中的物体放到另一张照片中。
NPU 启动等待缩短。所有 NPU 模型文件包均已通过快速启动路径重新发布。项目公告称,已加载(warm)状态下的请求加快了约 2%(1024x1024 图像)~36%(照片问答),答案保持不变。新文件需要 0.18.12 或更高版本。
减少缓存复制时的 GPU 停顿。默认情况下,副本会经过暂存缓冲区,即固定不移动的中间空间。主机移动与 GPU 关联的内存时,所有 GPU 工作队列都会暂停;在项目测试中,新路径将这部分损失时间减半。
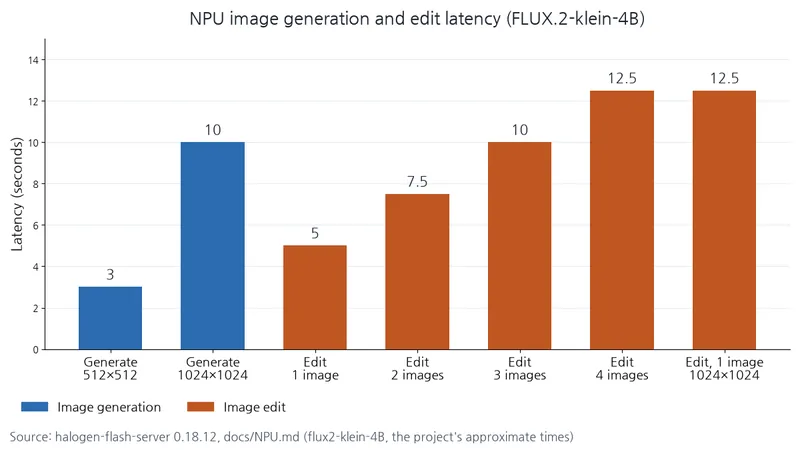
表:NPU 图像生成与编辑耗时
条件:编辑输出为 512×512,仅在输入一张照片时可指定 1024×1024
单位:秒(项目文档给出的近似值)
| NPU 图像任务 (flux2-klein-4b) | 耗时 |
|---|---|
| 图像生成 512×512 | 약 3 |
| 图像生成 1024×1024 | 약 10 |
| 图像编辑,512×512(1张照片) | 약 5 |
| 图像编辑,512×512(2张照片) | 약 7.5 |
| 图像编辑,512×512(3张照片) | 약 10 |
| 图像编辑,512×512(4张照片) | 약 12.5 |
| 图像编辑,1024×1024(1张照片) | 약 12.5 |
这些是项目文档(docs/NPU.md)中的近似值,每增加一张照片,耗时均匀增加,最多输入四张。不支持 mask,因此局部修改需要用提示词描述。
同机提示词处理与生成速度小幅提升
项目在两台 Ryzen AI Max+ 395(128GB)上各加载一个模型,以默认设置(启用缓存、关闭推理过程生成)进行测量。bench 使用预先生成候选 token 并一同验证的草稿机制,以及每步选择最可能 token 的贪心方式,测试了 10 个提示词。平均生成速度为 v2 64.0→66.1 tok/s、ht43 65.1→66.1 tok/s。
表:v2 提示词处理速度,0.18.11 与 0.18.12
条件:v2,约 85W 持续封装功耗,同机同会话 A/B
单位:token/秒
| 测量条件 | v2 0.18.11 | v2 0.18.12 |
|---|---|---|
| 关闭缓存,8,192 token | 1,833 | 1,877 |
| 关闭缓存,32,768 token | 1,783 | 1,822 |
| 启用缓存(冷启动),8,192 token | 1,746 | 1,787 |
| 启用缓存(冷启动),32,768 token | 1,808 | 1,849 |
表:ht43 提示词处理速度,0.18.11 与 0.18.12
条件:ht43,约 120W 默认设置,同机同会话 A/B
单位:token/秒
| 测量条件 | ht43 0.18.11 | ht43 0.18.12 |
|---|---|---|
| 关闭缓存,8,192 token | 1,762 | 1,835 |
| 关闭缓存,32,768 token | 1,808 | 1,865 |
| 启用缓存(冷启动),8,192 token | 1,743 | 1,815 |
| 启用缓存(冷启动),32,768 token | 1,809 | 1,864 |
提示词处理速度提高约 2.1~4.2%,生成速度方面,v2 提高约 3.3%,ht43 提高约 1.5%。发布说明将同时验证多个草稿阶段的工作量减少列为改进内容。各表仅比较同一台机器的跨版本变化。
使用新镜像标签更新 NPU 文件
0.18.12 镜像中的 HALOGEN_DOWNLOAD 会下载新的 NPU 文件。下面是加载图像模型后合并两张照片的原文示例,请求将第二张照片中的猫放到第一张照片的长椅上。
curl -s localhost:8731/v1/images/edits -F model=flux2-klein-4b -F "image[]=@scene.png" -F "image[]=@cat.png" \
  -F prompt="put the cat from image 2 on the bench in image 1, matching its light" -F seed=7
有利于使用辅助任务的团队,但仍共享内存与功耗
在 Flash 模型旁搭配使用分类、嵌入、重排序、内容审核、流式防护、语音识别、图像生成与编辑的团队将最为受益。不过,NPU 实际工作时,Flash 模型会略微变慢。这是因为两个引擎共享内存总线和芯片的功耗预算。
据项目发布说明,在温度为 0 时,输出与 0.18.11 逐字节相同。
如需性能改进和新增的观测指标,可将镜像标签改为 0.18.12;若还要使用图像编辑,则在 HALOGEN_NPU_MODELS 中添加 flux2-klein-4b。