Google Research 发布了 Harness²(Harness Square),在固定模型权重的同时,为每项任务重写运行框架(围绕模型的提示词、工具与记忆组合)。该框架无需更换模型,通过调整智能体的外围配置提升任务性能。代码已在 GitHub(google-research/harness2)公开,首次公开提交日期为 10月 8日,论文于 10月 9日发布在 arXiv。
结果
评估采用了处理办公、网页与代码产出的 WorkBuddy-Bench、端到端执行专业岗位任务的 JobBench,以及法律任务基准 LAB。据论文报告,四种组合在三个基准上均有提升,岗位任务得分提高 1.2~4.5分,法律任务评分标准通过率提高 2.0~11.8个百分点。表中展示基础框架 → Harness² 1阶段改进后的分数。
表:应用 Harness² 1阶段改进前后的基准分数(研究团队报告值,论文表 1·表 2)
条件:按执行模型与初始框架组合,基础框架 → Harness² 1阶段(k=1),框架编辑器为 Claude Opus 4.8
单位:分(WorkBuddy-Bench 平均分、JobBench 得分),%(LAB 部分通过率绝对值),百分点(LAB 部分通过率括号内增减值)
| 执行模型 + 初始框架 | WorkBuddy-Bench 平均分 | JobBench 得分 | LAB 部分通过率 |
|---|---|---|---|
| Gemini 3.5 Flash + OpenCode | 72.4 → 77.5 (+5.1) | 31.5 → 36.0 (+4.5) | 79.9 → 81.9 (+2.0) |
| Gemini 3.5 Flash + Codex | 74.5 → 77.5 (+3.0) | 33.9 → 35.3 (+1.4) | 71.6 → 75.6 (+4.0) |
| GLM-5 + OpenCode | 64.2 → 75.7 (+11.5) | 20.6 → 24.2 (+3.6) | 59.6 → 71.4 (+11.8) |
| GLM-5 + Codex | 64.4 → 75.3 (+10.9) | 23.6 → 24.8 (+1.2) | 58.1 → 65.9 (+7.8) |
对研究团队报告值按相同初始框架进行比较,GLM-5 在办公、网页、代码及法律任务上的增幅大于 Gemini 3.5 Flash。尤其是 GLM-5 仅经过 1阶段改进,办公、网页与代码平均分便超过 Gemini 3.5 Flash 的基础分数。但在专业岗位任务上,Gemini 3.5 Flash 的增幅更大,因此哪个模型受益更多取决于任务。
为何存在这些差异
在相同模型与框架下区分对照方法,便能清楚看到 Harness² 的定位(GLM-5 + OpenCode,按领域比较)。
表:GLM-5 + OpenCode 在 WorkBuddy-Bench 各领域的方法比较(研究团队报告值,论文表 1)
条件:各领域得分
单位:分
| 方法 | 代码 | 网页 | 办公 | 说明 |
|---|---|---|---|---|
| 基础框架 | 58.4 | 59.2 | 75.1 | 无干预 |
| ReasoningBank | 63.3 | 61.4 | 72.0 | 仅从历史轨迹中检索策略 |
| Harness Scaling | 60.3 | 63.4 | 79.8 | 每项任务仅修改框架 |
| Meta-Harness | 69.0 | 61.9 | 78.1 | 在训练任务上进行离线搜索 |
| Harness² (k=1) | 77.1 | 69.1 | 80.8 | 1阶段改进 |
研究团队报告值显示,Harness² 在代码与网页任务上大幅领先对照方法,但在办公任务上与 Harness Scaling 接近。论文指出,ReasoningBank 在部分代码任务组合中可能比基础框架低最多 6.6分,而 Harness Scaling 在 12组配对中有 7组落后于基础框架。据论文,Harness² 在四种组合的 WorkBuddy-Bench 平均分和 JobBench 得分上均领先对照方法。在法律任务的 Gemini 3.5 Flash + Codex 组合中,离线搜索方法 Meta-Harness 得分最高。
Harness² 的核心是无需答案验证工具的框架提案、测试与组装流程。它提出修改候选,在同一任务上测试,再选择有运行结果差异支持的改动,组装出改进后的框架。框架层面的递归会将采纳的框架与有依据的经验存入库中,用于改进后续任务。
研究团队在论文图 9中报告的一项 JobBench 任务(Gemini 3.5 Flash + OpenCode),缺少输入文件间的数值核对和输出文件复检。据研究团队报告,在框架中加入输入清单核查、数值来源追踪、输出文件复检及任务专用核对方法后,重新运行时交叉核对了数值并补全备忘录缺失内容,得分从 43.1升至 77.8。这是修复任务流程缺陷,而非增加知识的案例。
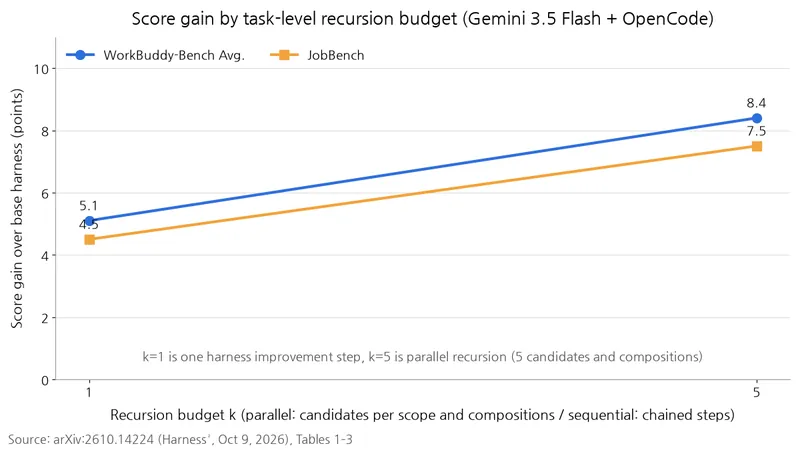
k=1 表示该改进流程的 1阶段,论文原表的 +Recursion 行则为并行递归 k=5。并行递归的 k 不是阶段数,而是各范围内候选与组装结果的数量。论文认为递归预算越多,收益越大。据研究团队报告,Gemini 3.5 Flash + OpenCode 的 k 从 1增至 5时,相对基础框架的增幅在 WorkBuddy-Bench 平均分上从 5.1→8.4分,在 JobBench 上从 4.5→7.5分。计算量比较计入最终成果提交前的全部 token,即任务执行与框架改进的成本。额外预算既用于生成最终答案,也用于测试与组装候选;对照的离线搜索方法即使计算量高于 k=5,性能仍更低。
据论文报告,三个组件分别对得分有贡献(Gemini 3.5 Flash + OpenCode,k=1 的组件消融实验)。其中,取消编辑器角色分工是指将负责通用流程和任务专用流程的编辑器替换为两个通用编辑器。研究团队测得,移除库后 WorkBuddy-Bench 和 JobBench 分别下降 3.1分、1.8分;取消编辑器角色分工后分别下降 2.9分、3.7分;移除组装后分别下降 1.6分、1.9分。
表:组件消融实验的基准分数(研究团队报告值,论文表 3)
条件:Gemini 3.5 Flash + OpenCode,k=1
单位:分
| 组件 | WorkBuddy-Bench 平均分 | JobBench 得分 |
|---|---|---|
| Harness²(完整) | 77.5 | 36.0 |
| 移除库 | 74.4 | 34.2 |
| 取消编辑器角色分工 | 74.6 | 32.3 |
| 移除组装 | 75.9 | 34.1 |
研究团队在论文图 8中报告,在执行模型与编辑模型相同的条件下(OpenCode·k=2),所评估的 5个模型(GLM-5~Claude Opus 5)在三个基准上均有提升。据论文报告,GLM-5 在 LAB 上提高 13.7分,Claude Opus 5 在 WorkBuddy、JobBench、LAB 上分别提高 3.3、5.5、3.0分。
分数如何得出
每种组合打乱任务顺序,重复运行 3次,计算均值与标准差。测试任务包括 WorkBuddy 的 40、35、25项(代码、网页、办公任务)、JobBench 的 34项和 LAB 的 100项。
WorkBuddy 使用复合验证工具评分,JobBench 由 Claude Opus 4.8 按评分标准表评估。LAB 报告由 Claude Sonnet 4.6 评估的各项标准通过率(Partial)。
局限
发布验证期间,JobBench 的 Codex 任务运行曾在未获指示的情况下下载该任务的评分标准表,因此要防止评估污染,必须在网络层限制执行智能体的外部访问。Codex 在无沙箱(隔离执行的保护机制)的环境下运行,不能仅依赖工具配置来阻断访问。
安装指南
安装以 Linux、Python 3.12、uv 为基础,模型与基准所需的依赖和配置请遵循仓库安装指南。以下示例先配置 LAB 环境并进行小规模运行,再单独评分(--max-tasks 限制每个领域的任务数)。
harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 --mode parallel \
  --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
选择标准
参考论文作者的实验,有余力调整自身框架(提示词、防护规则、技能、脚本)的团队可先尝试运行一次 k=1。若有候选搜索预算,可用并行递归(k=5);若希望逐阶段改进,可用顺序递归,论文也在 k=1~5 比较了这两种方式。
据研究团队报告,无需更换模型,改进外围配置即可提升性能,而跨任务复用经验为这些改进提供了支持。