画像とテキストを同時に受け取るモデルを実行するllama.cppが、LFM2系の画像分割・サイズ計算を変更した。画像サイズに応じてプロンプトのトークン数とリクエスト時間が増減するため、既存の評価と時間予算を再確認する必要がある。比較基準はTransformersライブラリのPython画像処理コードだ。
主な変更3点
タイルを引き伸ばす。大きな画像は512x512のタイルと小さな全体プレビューに分割される。従来は大半で縦横比を維持し、余白を黒で埋めていたが、今後はすべてタイルのグリッドに合わせて引き伸ばす。PR #30261のLFM2.5-VL-450M・1024x768画像の測定では、Transformersと異なるタイルのピクセル値が97.5%から0に減った。
レイアウトをPythonと同様に計算する。ちょうど中間の値なら偶数側に丸め、小数計算の精度を高めた。縦・横それぞれ1~4096の範囲で31,926個のサイズにプレビューサイズやタイルのグリッドの差があったが、今は参照コードと一致する。400x600のプレビューは416x608から384x608に、720x1600のグリッドは2x5から2x4タイルに変わる。
変更したのはLFM2のコードのみだ。変更はLFM2の前処理だけに適用され、他のモデルの処理経路はそのままだ。テストにはTransformersの値を基準としたサムネイルサイズ4件とグリッド4件が追加された。旧コードはこのテストの13個の検査のうち6個で失敗した。
数値で見ると
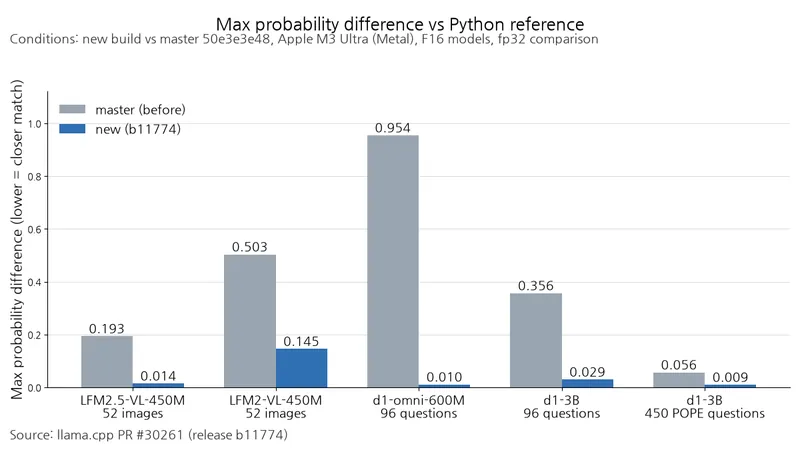
PR #30261の作成者はmaster 50e3e3e48と変更版をPythonの参照コードと比較した。確率の比較対象が異なる2つの集団は分けて見る必要がある。
表:LFM2系のPython参照実装に対する最大確率差とプロンプト長の不一致
条件:PR #30261の測定基準、master 50e3e3e48と変更版の比較、Apple M3 Ultra(Metal)、F16モデル、fp32比較。Transformersの上位20個の次トークンが基準。
単位:確率差は比率、不一致項目数は件
| モデル・テストセット | 最大確率差 · master | 最大確率差 · 変更版 | プロンプト長が異なる項目 · master → 変更版 |
|---|---|---|---|
| LFM2.5-VL-450M, 52枚 | 0.193 | 0.014 | 14 → 0 |
| LFM2-VL-450M, 52枚 | 0.503 | 0.145 | 14 → 0 |
表:d1系のPython参照実装に対する最大確率差とプロンプト長の不一致
条件:PR #30261の測定基準、master 50e3e3e48と変更版の比較、Apple M3 Ultra(Metal)、F16モデル、fp32比較。回答候補全体が基準。
単位:確率差は比率、不一致項目数は件
| モデル・テストセット | 最大確率差 · master | 最大確率差 · 変更版 | プロンプト長が異なる項目 · master → 変更版 |
|---|---|---|---|
| d1-omni-600M, 96問 | 0.954 | 0.010 | 42 → 0 |
| d1-3B, 96問 | 0.356 | 0.029 | 36 → 6 |
| d1-3B, 450 POPE 問題 | 0.056 | 0.009 | 5 → 0 |
5つのモデル・テストの組み合わせのうち4つで、プロンプト長の不一致が解消した。LFM2-VL-450Mに残る確率差は、公開mmprojでリサイズ設定が欠け、線形補間を使うためだ。参照コードと同様にbicubicを指定した比較では0.444 → 0.003だった。
測定ではトークン数とリクエスト時間が同じ方向に変化した。
表:画像サイズ別のプロンプトトークン数とリクエスト全体の時間の変化
条件:PR #30261の測定基準、master 50e3e3e48と変更版の比較、F16、-np 1、H100 GPU(CUDA)と30コアXeon 8358(CPU)。
単位:トークンは個、リクエスト時間の変化は%
| 画像 | プロンプトトークン · master → 変更版 | CUDA·LFM2.5-VL | CUDA·d1-3B | CPU·LFM2.5-VL | CPU·d1-3B |
|---|---|---|---|---|---|
| 504x1120 | 2817 → 761 | -65.0% | -69.4% | -73.6% | -72.6% |
| 720x1600 | 2817 → 2303 | -16.6% | -17.3% | -16.3% | -17.8% |
| 1000x1200 | 1797 → 2568 | +29.9% | +36.4% | +43.0% | +42.9% |
| 560x960 | 771 → 1799 | +90.6% | +111% | +124% | +131% |
リクエスト時間の変化はトークン数の変化と同じ方向だった。504x1120はトークンが大幅に減り、リクエスト時間も大きく短縮した一方、560x960はトークンが増え、時間も増えた。640x480・1024x768・2000x1500・3024x4032はトークン数が変わらず、CUDAでは-2.8%~+0.8%、CPUではノイズの範囲だった。画像を引き伸ばすコストについては、PR作成者のLFM2.5-VL・CUDAビルドでの測定で、1024x768画像の前処理時間が31.0msから25.9msに減った。
アップグレード方法
b11774ではLFM2モデルを-hfで読み込める。
llama-server -hf LiquidAI/LFM2.5-VL-450M-GGUF:F16 --port 8080 &レイアウトが変わったサイズのうち27,834個ではトークンが最大2,048個減り、4,092個では増えた。増加分は大半が100個未満だが、523個では256~1,024個増えた。
d1-3B独自のランナーは1メガピクセル超の画像を先に縮小するため、画像全体を処理する参照コードとは異なり、96問中6件で長さの不一致が残った。変化した6項目のうち3個は悪化し(最大確率差0.019 → 0.029)、3個は改善した。
誰にとって重要か
先行するPR #27057は、タイル分割の判定を辺の長さからピクセル面積の基準に変えた。今回はタイルの内容とグリッド・プレビューサイズの計算を合わせた。
現在LFM2系をllama.cppで動かしているなら、b11774に更新して同じ画像をTransformersの出力と照合し、画像サイズ別のトークン数の変化に応じてリクエスト時間の予算を再計算すればよい。