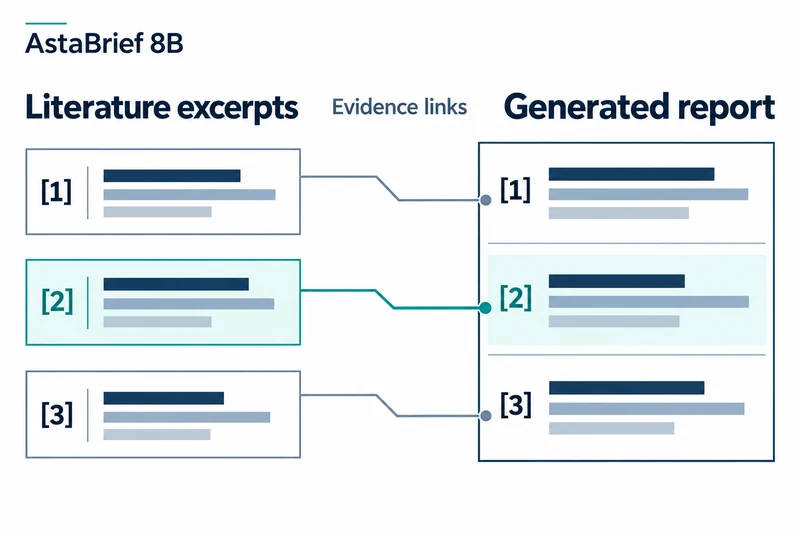
Ai2 于10月2日发布 AstaBrief 8B。它根据研究问题和检索到的文献摘录撰写带引用的报告,负责 Asta 报告生成功能中的 Fast 模式。
Ai2 表示,在完整 Asta 流程中,Fast 模式平均每份报告51.1秒,基于 Claude 的 Thinking 模式为178.5秒,约相差3.5倍。
差距来自结构。Thinking 模式先对摘录做总结和聚类,再逐节撰写;AstaBrief 则被训练为根据问题和摘录一次性生成最终报告。
不过大部分训练和评估在2025年完成,Ai2 表示尚未针对当今前沿模型重跑完整评估。因此很难把这一速度视为当前的比较优势。
以带引用 ID 的摘录作为输入
检查点名称为 allenai/AstaBrief_8B,以 Qwen3-8B 为起点,经过 SFT 和离线 DPO 训练。
模型卡建议推理时沿用训练提示词格式,并指出使用其他格式可能导致性能下降或行为不一致。
该提示词在问题之外提供以引用 ID 为键的摘录,并要求把来自模型自身知识的内容单独标注为 (LLM Memory)。
参考文献是作为输入给出的,而不是由模型自行查找。仅凭该检查点并不能检索或核实文献。
Apache 2.0 模型与 CC BY-NC 4.0 数据
模型卡注明 Apache 2.0 许可,并面向研究和教育用途。
SFT 和 DPO 数据卡为 CC BY-NC 4.0,并说明第三方模型生成的合成输出受各提供方条款约束。提示词仓库同样标注 CC BY-NC 4.0。
公开的许可标注并不能确定某一具体部署的使用许可,也不是每个组件都继承模型的许可。
用固定问题和摘录审查引用
实际上,报告质量受制于输入摘录的质量。比起生成速度,每条引用是否真正支撑相邻论断似乎更值得先看。
即使引用正确,研究的对象群体或条件也可能被泛化。把 (LLM Memory) 内容单独计数,更容易看出审查负担。
模型卡给出的推理设置如下。做法是固定一组问题和摘录,用这些设置生成,再记录引用能否解析、是否与证据一致。
model_name = "allenai/AstaBrief_8B"
sampling_params = SamplingParams(
    temperature=0.7,
    top_p=0.95,
    max_tokens=4096,
)
这是建议的审查流程,本文没有运行模型,也没有复现基准测试。检索、解析和服务环节同样需要检查,才能称整个工作流为本地化。
AstaBrief 的速度,最多只能像检索交给它的证据一样可信。