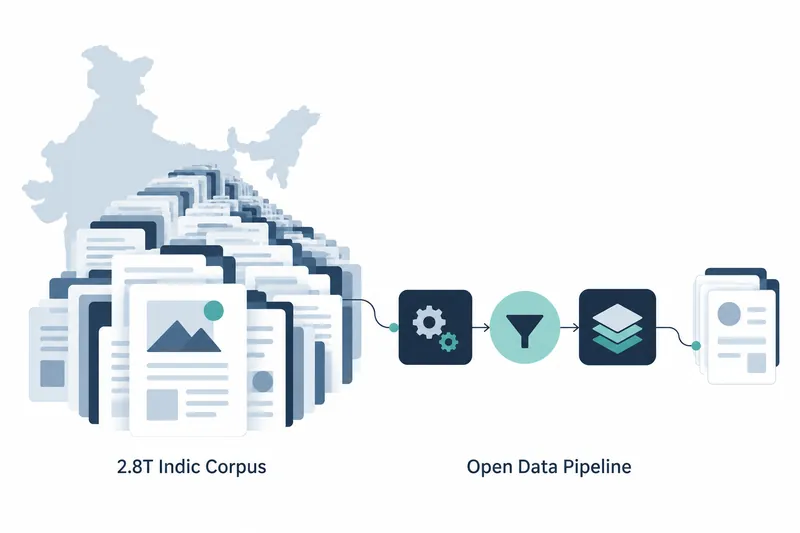
NVIDIA 为印度语言模型开发者介绍了约2.8万亿 token 的训练文本及其公开生成流程。这些数据与印度理工学院马德拉斯分校的语言研究机构合作制作,将英语数学、代码和问答内容翻译成印度语言,以扩充训练素材。数据计划公开,但未给出发布日期及分发日期。
1. 22种语言与两类文字形式
Nemotron-pretraining-Indic-v1 涵盖印度宪法列明的22种语言。语料库是训练文本的集合,token 是模型拆分和处理文本的单位。22种语言均有原生文字数据,其中12种还提供以拉丁字母书写的罗马字转写数据,共有34种语言与文字组合。
按 Gemma-4 分词器统计,原生文字数据为2万亿6010亿 token,罗马字转写数据为2246亿 token。这是存储的数据量,并非某次训练的预算。原生文字数据也译自英语,罗马字转写数据则仅改变了部分已采纳译文的书写形式,并不代表新增内容。
2. 翻译并评估后修正必要部分
起点是 Nemotron-CC-v2 中包含网页文档、数学和代码等内容的15个子集。NeMo Data Designer 串联翻译、质量检查与局部修正,并保留原始文档标识符,以便追踪结果。
12种语言的流程使用 Gemma-4-31B-it 翻译整篇文档,再用同一模型评估。评估考察语义、流畅度、术语和格式等,满分100分,仅采纳75分及以上的译文。这不意味着准确率为75%,不达标的结果会根据评语修正后重新评定。部分获采纳译文会转写为拉丁字母,并单独检查。
其余10种语言使用 Bodhan AI 的 Indic Translate 翻译,采用相同的75分门槛,但不根据反馈重写。较长的桑塔利语文档会拆成相互重叠的片段,翻译后再拼接;曼尼普尔语则先译为孟加拉文字,再转换为其本族文字。此流程仅生成原生文字数据。
3. 性能提升来自混合训练阶段
Nemotron 3.5 Super VL 将该语料库中12种语言的部分与本地原创文本混合,继续预训练。总预算为1000亿 token,其中10%,即100亿 token,分配给这一混合数据,其余90%维持原有训练数据的相对比例。
对比这一阶段前后的结果,五项知识与推理评估提升了4.98~9.82个百分点。例如,评估12种语言的 Indic MMLU-Pro 从51.83分升至56.81分。各项评估覆盖的语言不同,这些结果并未单独分离出合成数据的贡献。
另将最终模型与上一代 Nemotron 3 Super 比较,六项任务中有五项改善,但指令遵循评估 IFEval 1.5 下降了2.04个百分点。这一比较也反映了后续训练的影响。
4. 从小样本和固定预算开始
先确定所需的语言和文字,并查阅数据集说明与许可证。以下是原文示例中确认仓库和数据划分的部分。配置值表示使用天城文的印地语。
from datasets import get_dataset_split_names, load_dataset

dataset_id = input("Repository ID from the dataset card: ").strip()
config = "hi-Deva-IN"

splits = get_dataset_split_names(dataset_id, config_name=config)
print("Available splits:", splits)
原文介绍了无需完整下载即可读取样本的流式读取方式,以及公开后固定数据版本的做法。首次实验应固定 token 预算,比较混合比例,并记录各语言结果。划分训练与评估数据时,应考虑避免同一原文的译文和文字变体混入两侧。
5. 生成自动化并不免除验证责任
通过公开的生成工具 Nemotron Bharat 插件,可以应用自有文档和翻译指南。虽然技术内容更容易扩展到多种语言,但用户仍需决定将生成候选内容纳入实际训练数据的过滤策略。原文建议先与母语使用者审查小样本,再扩大规模。
质量评估主要依靠自动化,人工抽样审查的覆盖范围因语言而异。错误可能仍会残留,原始标识符检查也只能消除重复处理,并不能去除语义相近的文档。翻译数据无法替代包含地方知识与文化背景的本地原创文本。
此次公开的价值在于同时提供数据规模与可复用的生成流程,而是否采用,取决于与本地原创数据混合后针对具体用途的验证结果。