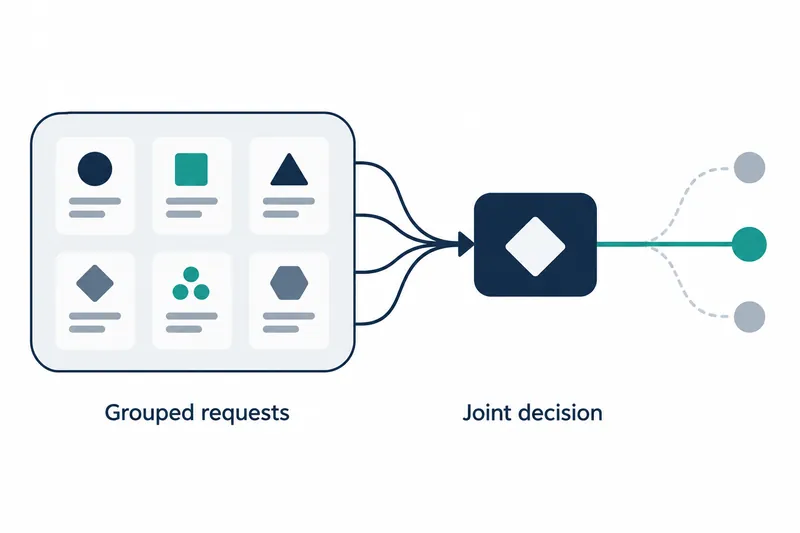
Perplexity 发布了一款可一次判断同一情境下多个问题的模型。开发客户咨询分类等需要判断多种属性的服务时,可以减少调用次数,但问题的分组方式也会影响答案。
1. 不再为每个问题单独运行
这款判断模型不生成句子,而是返回对给定选项的判断。
上一版本为每个问题分别运行模型。新版本在情境说明后附上多个问题,并在各问题的标记位置读取答案。各问题共享同一情境说明,也会参考彼此的内容。
训练数据新增了部分基准的官方训练集划分以及其他决策数据,并去除了与测试集重叠的内容。
2. 需结合分数提升与训练范围来看
公开的 Decision Index 0.3 自评综合分数从旧模型的 62.30 升至问题分组后新模型的 68.09。向新模型分别发送问题时,分数为 67.75。综合分数采用评测集合的权重,并非各类别的简单平均。
使用最大 1.6 MP 图像的公开 Vision Decision Index 0.3 分数从旧模型的 73.22 升至新模型的 77.43。
部分评测任务如今已纳入训练范围。虽然说明称,在未纳入训练的决策任务上也有所改善,但未提供详细分数。
在问题分组格式下,用独立数据拟合的概率校准系数为 1.382。在包含 1,497 个问题的开发集上,准确率为 91.3%,衡量预测概率与实际正确率偏差的 ECE 从校准前的 0.033 降至 0.014。在未纳入训练的决策数据上,仍有一定过度自信倾向,ECE 约为 0.05。
3. 相关属性合并,独立候选项分开
判断同一项目的多个属性时,分组更有利。在同一评测的任务分数中,分组请求相较单独请求,在多答案选择任务 SATA-Bench 上为 +11.3 分,在针对各候选工具提问的 ToolRet 上为 −4.8 分。独立候选项之间可能相互干扰判断。
文档重排序评测集合 BEIR 使用 nDCG@10,即前 10 个结果的排序质量指标。
每次请求放入 8 篇候选文档,相比每次放入 1 篇,在需要串联多个证据的 HotpotQA 上为 +2.1 分,但全部 13 个数据集的平均值为 −0.5 分。应先分清候选项之间的比较本身是否有帮助。
4. 快速执行也不完全等同于基准结果
在一次请求中将问题分组,与对独立请求进行批处理并不相同。高速路径在同时处理多个独立请求时,也会保持请求之间的独立性。
测量在一台 GB200 上使用 16 位数值格式 BF16 进行。对于平均 1,050 个 token(模型计量输入的小单位)的判断评测请求,吞吐量从按长度分组并填充的基准方式每秒 9.1 次,增至默认高速路径的 19.8 次。单个请求的延迟中位数从 131 毫秒降至 96 毫秒。基准方式已按长度对请求分组,因此仅靠简单分组几乎没有收益,提速来自计算编译和通过 CUDA 图进行执行复用。
收益在于吞吐量和延迟改善,但数值差异仍然存在。在同一评测集合的 300 个请求、2,324 个问题中,高速路径与基准路径的首选项一致率为 99.8%,概率差的绝对值均值为 0.002。基准路径自身在批处理与单独处理之间的选项一致率也为 99.8%,概率差的绝对值均值为 0.0017。高速路径的差异与基准路径自身因处理方式产生的波动规模相近。
5. 核查运行环境与输入上限
pplx-decider-v1.2 与上一版本一样基于 Qwen3.8-27B,可接收文本和最大 1.6 MP 的图像。
自行运行需要 Python 3.12 或更高版本及 CUDA GPU。
内存需求包括约 52 GiB 的 BF16 权重,以及额外的工作空间。
README 称仓库为私有,提示使用有访问权限的 Hugging Face 令牌认证,但模型页面元数据显示为 private:false、gated:false。原文说明互相冲突,因此无法确定实际是否限制访问。下载后安装基础依赖,使用高速路径时还需添加专用依赖。
以下是原文的默认高速路径示例。准备好模型路径和请求列表后运行。
from pplx_decider import Decider

decider = Decider.from_pretrained(checkpoint, fast=True)
decider.warmup()
responses = decider.decide(requests)
默认长度上限为 262,144 个 token,但训练长度仅到约 32k 个 token。超过这一长度时,需用自己的任务验证。超出配置上限时,不会截断输入,而是拆分问题,并在每个片段中重新放入情境和图像。如果连一个问题也容纳不下,则会在执行前报错。
服务运行环境需要支持问题间双向参考,以及按问题读取答案的实现。
Ollama 的 v0.40.7-rc0 预发布版本新增了对该模型的支持。
根据[变更请求作者的记录](https://github.com/ollama/ollama/pull/19072),在记录当时,用于运行库 MLX 的模型已上传,但汇总部署信息的清单尚未创建。应区分支持代码与部署准备状态。
决定是否引入该模型,应从区分哪些问题需要相互参考、哪些候选项需要独立评估入手,而不是尽可能多地分组。