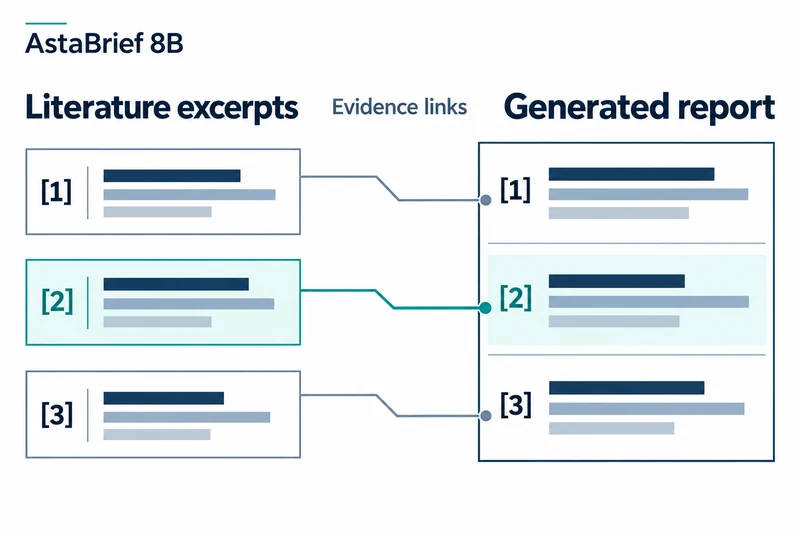
Ai2は10月2日にAstaBrief 8Bを公開した。研究上の質問と検索された文献抜粋から引用付きレポートを書くモデルで、Astaのレポート生成機能のFastモードを担う。
Ai2によると、Asta全体のパイプラインでFastモードはレポート1件当たり平均51.1秒、ClaudeベースのThinkingモードは178.5秒だ。約3.5倍の差である。
差は構造から生じる。Thinkingモードは抜粋の要約とクラスタリングを経てセクションごとに書くが、AstaBriefは質問と抜粋から最終レポートを一度に生成するよう学習された。
ただし学習と評価の大半は2025年に終わっており、Ai2は現在のフロンティアモデルとの全面評価を再実施していないと述べている。この速度を現時点の比較優位と読みにくい理由だ。
引用ID付き抜粋を入力とする構造
チェックポイント名はallenai/AstaBrief_8Bで、Qwen3-8Bから出発し、SFTとオフラインDPOで学習された。
モデルカードは、推論時にも学習時のプロンプト形式をそのまま使うことを推奨する。別の形式では性能低下や一貫しない動作につながり得ると記している。
そのプロンプトは質問と引用IDをキーとする抜粋を渡し、モデル自身の知識に由来する主張を(LLM Memory)として別に示させる。
参考文献はモデルが自ら探すのではなく、入力として与えられる。チェックポイント単体で文献を検索したり検証したりするわけではない。
Apache 2.0のモデルとCC BY-NC 4.0のデータ
モデルカードはApache 2.0ライセンスと研究・教育目的での利用を明記している。
SFTとDPOのデータカードはCC BY-NC 4.0で、第三者モデルが生成した合成出力は各提供元の規約に従うと記す。プロンプトのリポジトリにもCC BY-NC 4.0の表示がある。
公開されたライセンス表示が、特定の導入での利用許可を確定させるわけではない。すべての構成要素がモデルのライセンスを引き継ぐわけでもない。
固定した質問と抜粋で引用を点検する方法
実際には、レポートの品質は入力抜粋の品質に縛られる。生成速度より、各引用が隣の主張を本当に裏付けているかが先に見るべき点に見える。
引用が正しくても、研究の対象集団や条件が広く一般化されることがある。(LLM Memory)とされた主張を別に数えると、レビューの負担が見えやすい。
モデルカードに記された推論設定は以下のとおりだ。同じ質問と抜粋のセットを固定し、この設定で生成した後、引用の解決と根拠との一致を記録する方法である。
model_name = "allenai/AstaBrief_8B"
sampling_params = SamplingParams(
    temperature=0.7,
    top_p=0.95,
    max_tokens=4096,
)
これはレビュー手順の提案であり、本記事ではモデルを実行しておらず、ベンチマークも再現していない。検索、解析、サービングまで確認して初めて、ワークフロー全体をローカルと呼べる。
AstaBriefの速度は、検索が渡す根拠の質を超えては信頼できない。