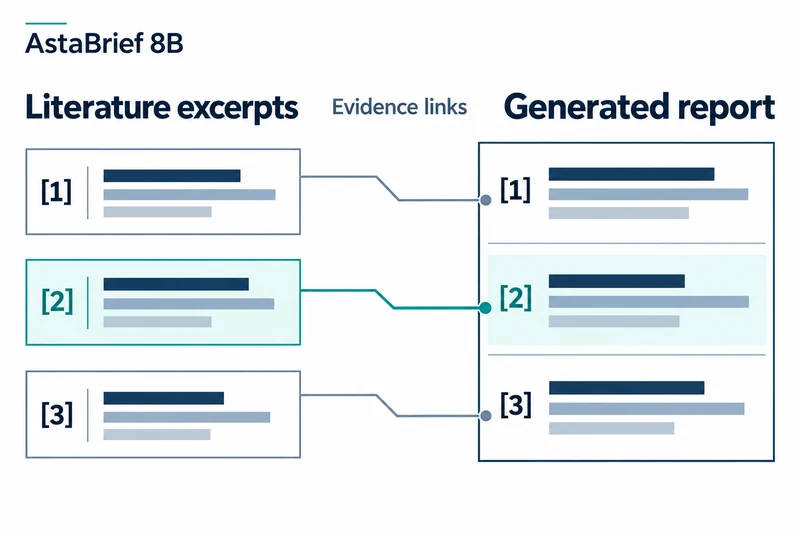
Ai2가 10월 2일 AstaBrief 8B를 공개했다. 연구 질문과 검색된 문헌 발췌를 받아 인용 보고서를 쓰는 모델로, Asta 보고서 생성 기능의 Fast 모드를 맡는다.
Ai2는 전체 Asta 파이프라인 기준으로 Fast 모드가 보고서당 평균 51.1초, Claude 기반 Thinking 모드가 178.5초라고 밝혔다. 약 3.5배 차이다.
속도 차이는 구조에서 나온다. Thinking 모드는 발췌 요약과 클러스터링을 거쳐 섹션별로 쓰지만, AstaBrief는 질문과 발췌에서 최종 보고서를 한 번에 생성하도록 학습됐다.
다만 학습과 평가 대부분은 2025년에 끝났고, Ai2는 현재 프런티어 모델과의 전체 평가를 다시 돌리지 않았다고 밝혔다. 이 속도를 현재 시점의 비교 우위로 읽기 어려운 이유다.
인용 ID가 붙은 발췌를 입력으로 받는 구조
체크포인트 이름은 allenai/AstaBrief_8B이며, Qwen3-8B에서 출발해 SFT와 오프라인 DPO로 학습됐다.
모델 카드는 학습에 쓴 프롬프트 형식을 추론 때도 그대로 쓰도록 권장한다. 다른 형식은 성능 저하나 일관되지 않은 동작으로 이어질 수 있다고 적었다.
그 프롬프트는 질문과 함께 인용 ID가 달린 발췌를 넣고, 모델 자체 지식에서 나온 주장은 (LLM Memory)로 따로 표시하게 한다.
참고 문헌은 모델이 스스로 찾는 것이 아니라 입력으로 주어진다. 체크포인트 단독으로 문헌을 검색하거나 검증한다는 뜻은 아니다.
Apache 2.0 모델과 CC BY-NC 4.0 데이터
모델 카드는 Apache 2.0 라이선스와 연구·교육 목적 사용을 명시한다.
SFT와 DPO 데이터 카드는 CC BY-NC 4.0이며, 제3자 모델이 만든 합성 출력은 각 제공자의 약관을 따른다고 적었다. 프롬프트 저장소에도 CC BY-NC 4.0 표시가 있다.
공개된 라이선스 표시가 특정 배포의 사용 허가를 확정해주지는 않는다. 모든 구성 요소가 모델의 라이선스를 물려받는 것도 아니다.
고정 질문과 발췌로 인용을 점검하는 방법
현실적으로 이 모델의 보고서 품질은 입력 발췌의 품질에 묶여 있다. 생성 속도보다 각 인용이 옆 주장을 실제로 뒷받침하는지가 먼저 볼 지점으로 보인다.
인용이 맞더라도 연구의 대상 집단이나 조건이 넓게 일반화될 수 있다. (LLM Memory)로 표시된 주장은 따로 세는 쪽이 검토 부담을 드러내기 쉽다.
모델 카드에 적힌 추론 설정은 아래와 같다. 같은 질문·발췌 세트를 고정하고 이 설정으로 생성한 뒤, 인용 해석 여부와 근거 일치를 기록하는 방식이다.
model_name = "allenai/AstaBrief_8B"
sampling_params = SamplingParams(
    temperature=0.7,
    top_p=0.95,
    max_tokens=4096,
)
이는 검토 절차의 제안이며, 이 글에서 모델을 실행하거나 벤치마크를 재현하지 않았다. 검색, 파싱, 서빙까지 확인해야 전체 워크플로를 로컬이라고 부를 수 있다.
AstaBrief의 속도는 검색이 넘겨준 근거의 질을 넘어서 믿을 수 없다.