Google Research가 모델 가중치를 고정한 채 작업마다 하네스(모델을 감싸는 프롬프트·도구·메모리 묶음)를 다시 쓰는 Harness²(하네스 스퀘어)를 공개했다. 모델 교체 없이 에이전트의 주변 구성을 고쳐 업무 성능을 높이는 프레임워크다. 저장소는 GitHub(google-research/harness2)에 공개됐으며, 공개용 첫 커밋은 10월 8일, 논문의 arXiv 게재는 10월 9일이다.
결과
평가는 사무·웹·코딩 산출물을 다루는 WorkBuddy-Bench, 전문 직무를 처음부터 끝까지 수행하는 JobBench, 법률 업무를 다루는 LAB에서 이뤄졌다. 연구진의 논문 보고 기준으로 네 조합 모두 세 벤치마크에서 점수가 올랐고, 상승 폭은 직무 수행 점수에서 1.2~4.5점, 법률 업무의 채점 기준 통과율에서 2.0~11.8%포인트였다. 표는 기본 하네스 → Harness² 1단계 후 점수다.
표: Harness² 1단계 적용 전후의 벤치마크 점수(연구진 보고값, 논문 표 1·표 2)
조건: 실행 모델과 초기 하네스 조합별, 기본 하네스 → Harness² 1단계(k=1), 하네스 편집자는 Claude Opus 4.8
단위: 점(WorkBuddy-Bench Avg., JobBench Score), %(LAB Partial 절대값), %포인트(LAB Partial 괄호 안 증감)
| 실행 모델 + 초기 하네스 | WorkBuddy-Bench Avg. | JobBench Score | LAB Partial |
|---|---|---|---|
| Gemini 3.5 Flash + OpenCode | 72.4 → 77.5 (+5.1) | 31.5 → 36.0 (+4.5) | 79.9 → 81.9 (+2.0) |
| Gemini 3.5 Flash + Codex | 74.5 → 77.5 (+3.0) | 33.9 → 35.3 (+1.4) | 71.6 → 75.6 (+4.0) |
| GLM-5 + OpenCode | 64.2 → 75.7 (+11.5) | 20.6 → 24.2 (+3.6) | 59.6 → 71.4 (+11.8) |
| GLM-5 + Codex | 64.4 → 75.3 (+10.9) | 23.6 → 24.8 (+1.2) | 58.1 → 65.9 (+7.8) |
연구진의 보고값을 같은 초기 하네스끼리 비교하면 사무·웹·코딩과 법률 업무에서는 GLM-5의 상승 폭이 Gemini 3.5 Flash보다 컸다. 특히 GLM-5는 1단계 개선만으로 사무·웹·코딩 평균에서 Gemini 3.5 Flash의 기본 점수를 넘었다. 반면 전문 직무에서는 Gemini 3.5 Flash의 상승 폭이 더 커, 어느 모델이 더 이득을 보는지는 업무에 따라 달랐다.
왜 이런 차이가 나나
같은 모델·하네스에서 비교군을 갈라놓으면 Harness²의 위치가 뚜렷하다(GLM-5 + OpenCode, 도메인별).
표: GLM-5 + OpenCode의 WorkBuddy-Bench 도메인별 방법 비교(연구진 보고값, 논문 표 1)
조건: 도메인별 점수
단위: 점
| 방법 | Code | Web | Office | 설명 |
|---|---|---|---|---|
| 기본 하네스 | 58.4 | 59.2 | 75.1 | 개입 없음 |
| ReasoningBank | 63.3 | 61.4 | 72.0 | 과거 궤적에서 전략만 검색 |
| Harness Scaling | 60.3 | 63.4 | 79.8 | 작업마다 하네스만 수정 |
| Meta-Harness | 69.0 | 61.9 | 78.1 | 학습 작업에서 오프라인 검색 |
| Harness² (k=1) | 77.1 | 69.1 | 80.8 | 1단계 개선 |
연구진의 보고값에서 코딩과 웹은 Harness²가 경쟁군을 크게 앞선 반면 사무 작업은 Harness Scaling과 접전이다. 논문은 ReasoningBank가 일부 코딩 작업 조합에서 기본 하네스보다 최대 6.6점 아래로 내려갈 수 있고, Harness Scaling은 12개 조합 쌍 중 7개에서 기본 하네스보다 뒤처졌다고 정리했다. 논문 기준으로 Harness²는 네 조합 모두 WorkBuddy-Bench 평균과 JobBench 점수에서 비교군을 앞선다. 법률 업무에서는 Gemini 3.5 Flash + Codex 조합에서 오프라인 검색 방식인 Meta-Harness가 가장 높았다.
Harness²의 핵심은 정답 검증 도구 없이 하네스를 고치는 제안·시험·조립 단계다. 수정 후보를 제안하고 같은 작업에서 시험한 뒤, 실행 결과 차이가 뒷받침하는 변경을 골라 개선된 하네스를 조립한다. 하네싱 수준 재귀는 채택한 하네스와 근거 있는 교훈을 라이브러리에 쌓아 다음 작업을 다듬게 한다.
연구진이 논문 그림 9에서 보고한 JobBench 한 작업(Gemini 3.5 Flash + OpenCode)에서는 입력 파일 간 수치 대조와 작성한 출력 파일의 재검사가 빠져 있었다. 연구진의 보고에 따르면 하네스에 입력 목록 확인·수치 출처 추적·출력 파일 재검사 절차와 업무별 대조 방법을 추가하자, 재실행에서 수치를 교차 확인하고 메모의 누락된 부분을 복원해 점수가 43.1에서 77.8로 올랐다. 지식 추가보다 작업 절차의 결함을 고친 사례다.
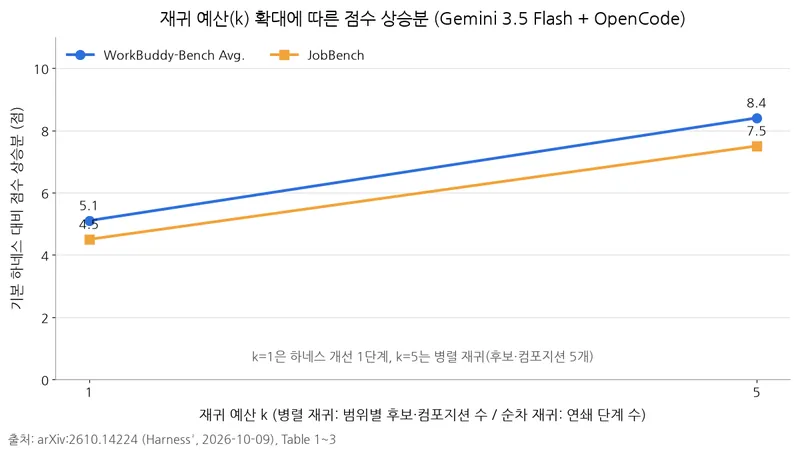
k=1은 이 개선 과정 1단계이며, 논문 원표의 +Recursion 행은 병렬 재귀 k=5다. 병렬 재귀의 k는 단계 수가 아니라 범위별 후보와 조립 결과의 수다. 논문은 재귀 예산을 늘릴수록 이득이 커진다고 본다. 연구진의 보고값에서 Gemini 3.5 Flash + OpenCode 기준으로 k를 1에서 5로 올리면 기본 하네스 대비 상승분이 WorkBuddy-Bench 평균에서 5.1→8.4점, JobBench에서 4.5→7.5점으로 커진다. 계산량 비교는 최종 산출물 제출 전의 모든 토큰, 즉 작업 실행과 하네스 개선 비용을 함께 센다. 추가 예산은 최종 답변 생성뿐 아니라 후보를 시험하고 조립하는 데도 쓰이며, 비교한 오프라인 검색 방식은 k=5보다 계산량이 많아도 성능은 낮았다.
연구진의 논문 보고 기준으로 세 구성 요소가 각각 점수에 기여한다(Gemini 3.5 Flash + OpenCode, k=1 기준 구성 요소 제거 실험). 여기서 편집자 역할 분리 제거는 공통 절차 담당과 업무별 담당을 일반 편집자 두 명으로 바꾼 조건이다. 연구진의 측정에서 라이브러리를 빼면 WorkBuddy-Bench와 JobBench 점수가 3.1점·1.8점, 편집자 역할 분리를 빼면 2.9점·3.7점, 조립을 빼면 1.6점·1.9점 떨어진다.
표: 구성 요소 제거 실험의 벤치마크 점수(연구진 보고값, 논문 표 3)
조건: Gemini 3.5 Flash + OpenCode, k=1
단위: 점
| 구성 요소 | WorkBuddy-Bench Avg. | JobBench Score |
|---|---|---|
| Harness² (전체) | 77.5 | 36.0 |
| 라이브러리 제거 | 74.4 | 34.2 |
| 편집자 역할 분리 제거 | 74.6 | 32.3 |
| 조립 제거 | 75.9 | 34.1 |
연구진은 논문 그림 8에서 실행 모델과 편집 모델을 같게 둔 조건(OpenCode·k=2)으로 평가한 5개 모델(GLM-5~Claude Opus 5)이 세 벤치마크 모두 개선됐다고 보고했다. 연구진의 논문 보고 기준으로 GLM-5는 LAB에서 13.7점, Claude Opus 5는 WorkBuddy·JobBench·LAB에서 3.3·5.5·3.0점 올랐다.
점수는 어떻게 나왔나
각 조합은 작업 순서를 섞어 3회 반복해 평균과 표준편차를 냈다. 대상은 테스트 작업 기준 WorkBuddy 40·35·25개(코딩·웹·사무 작업), JobBench 34개, LAB 100개다.
WorkBuddy는 복합 검증 도구로 채점하고, JobBench는 Claude Opus 4.8이 채점 기준표에 따라 평가한다. LAB은 Claude Sonnet 4.6이 평가한 기준별 통과율(Partial)을 보고한다.
한계
릴리스 검증 중 JobBench의 Codex 작업 실행이 지시 없이 해당 작업의 채점 기준표를 내려받은 사례가 있어, 평가 오염을 막으려면 실행 에이전트의 외부 접근을 네트워크에서 제한해야 한다. Codex는 샌드박스(실행을 격리하는 보호 장치) 없이 실행되므로 도구 설정에만 차단을 맡길 수 없다.
설치 안내
설치는 Linux·Python 3.12·uv를 기준으로 하며, 모델·벤치마크별 의존성과 설정은 저장소 설치 안내를 따른다. 아래는 LAB 환경을 잡고 소규모 실행한 뒤 별도로 채점하는 예제다(--max-tasks는 도메인당 작업 수를 제한한다).
harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 --mode parallel \
  --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
고를 때 기준
논문 저자의 실험을 참고하면 자기 하네스(프롬프트·가드레일·스킬·스크립트)를 손볼 여력이 있는 팀은 k=1 한 번만 먼저 돌려 볼 수 있다. 후보 탐색 여유가 있으면 병렬 재귀(k=5), 단계마다 다듬고 싶으면 순차 재귀를 쓰면 되고, 논문도 k=1~5에서 두 방식을 비교했다.
연구진의 보고에 따르면 모델 교체 없이도 주변 구성을 개선해 성능을 높였고, 작업 간 경험 재사용이 그 개선을 뒷받침했다.