로컬 언어모델과 보조 작업을 AMD Strix Halo 한 대에서 실행하는 halogen-flash-server가 2026년 10월 20일 0.18.12를 냈다. 프로젝트 발표에 따르면 적재된 보조 모델의 시작 대기가 줄고 여러 사진을 합치는 편집이 가능해졌다. Flash 체크포인트(모델 가중치 파일)는 그대로다.
이미지 네 장 편집과 NPU 시작 대기 단축
다중 이미지 편집. 사진 속 물체를 다른 사진에 넣는 식의 편집에 여러 그림을 함께 보낼 수 있다. /v1/images/edits가 이제 image 파트를 1~4개 받으며, 프롬프트는 "image 1", "image 2"처럼 보낸 순서대로 그림을 지목한다. 기능 요청은 GitHub 이슈 #179에서 왔고, 요청자는 한 사진의 물체를 다른 사진에 배치하는 기능을 원했다.
NPU 시작 대기 단축. 모든 NPU 모델 파일 묶음이 빠른 시작 경로로 다시 배포됐다. 프로젝트 발표에 따르면 이미 적재된 상태(warm)의 요청은 약 2%(1024x1024 이미지)~36%(사진 질문) 빨라졌고 답은 그대로다. 새 파일은 0.18.12 이상이 필요하다.
캐시 복사 중 GPU 정지 감소. 복사본은 기본적으로 이동하지 않게 고정한 중간 공간인 스테이징 버퍼를 거친다. 호스트가 GPU에 연결된 메모리를 옮기면 모든 GPU 작업 대기열이 멈추는데, 새 경로는 이 손실 시간을 프로젝트 테스트에서 절반으로 줄였다.
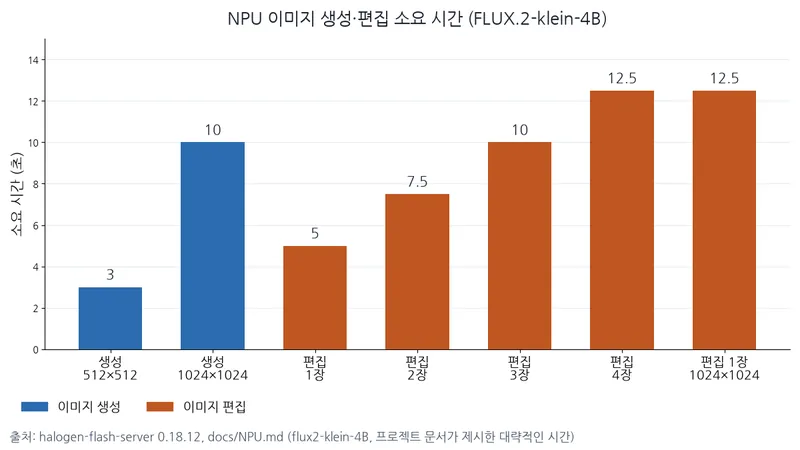
표: NPU 이미지 생성·편집 소요 시간
조건: 편집 출력은 512×512이며, 입력 사진이 한 장일 때만 1024×1024 지정 가능
단위: 초(프로젝트 문서가 제시한 대략값)
| NPU 이미지 작업 (flux2-klein-4b) | 소요 시간 |
|---|---|
| 이미지 생성 512×512 | 약 3 |
| 이미지 생성 1024×1024 | 약 10 |
| 이미지 편집, 512×512 (사진 1장) | 약 5 |
| 이미지 편집, 512×512 (사진 2장) | 약 7.5 |
| 이미지 편집, 512×512 (사진 3장) | 약 10 |
| 이미지 편집, 512×512 (사진 4장) | 약 12.5 |
| 이미지 편집, 1024×1024 (사진 1장) | 약 12.5 |
프로젝트 문서(docs/NPU.md)의 대략값으로, 사진을 한 장 더 붙일 때마다 시간이 고르게 늘며 입력은 최대 네 장이다. mask는 지원하지 않으므로 부분만 손보는 편집은 프롬프트로 설명해야 한다.
같은 기계에서 프롬프트·생성 속도 소폭 개선
프로젝트는 Ryzen AI Max+ 395(128GB) 두 대에 모델을 하나씩 올려 기본 설정(캐시 켬, 추론 과정 생성 끔)으로 측정했다. bench는 후보 토큰을 미리 만들어 함께 검사하는 드래프팅과 매 단계 가장 가능성 높은 토큰을 고르는 그리디 방식으로 10개 프롬프트를 시험했다. 평균 생성 속도는 v2 64.0→66.1 tok/s, ht43 65.1→66.1 tok/s였다.
표: v2 프롬프트 처리 속도, 0.18.11과 0.18.12
조건: v2, 약 85W 지속 패키지 전력, 같은 기계·세션 A/B
단위: 토큰/초
| 측정 조건 | v2 0.18.11 | v2 0.18.12 |
|---|---|---|
| 캐시 끔, 8,192토큰 | 1,833 | 1,877 |
| 캐시 끔, 32,768토큰 | 1,783 | 1,822 |
| 캐시 켬(콜드), 8,192토큰 | 1,746 | 1,787 |
| 캐시 켬(콜드), 32,768토큰 | 1,808 | 1,849 |
표: ht43 프롬프트 처리 속도, 0.18.11과 0.18.12
조건: ht43, 약 120W 기본 설정, 같은 기계·세션 A/B
단위: 토큰/초
| 측정 조건 | ht43 0.18.11 | ht43 0.18.12 |
|---|---|---|
| 캐시 끔, 8,192토큰 | 1,762 | 1,835 |
| 캐시 끔, 32,768토큰 | 1,808 | 1,865 |
| 캐시 켬(콜드), 8,192토큰 | 1,743 | 1,815 |
| 캐시 켬(콜드), 32,768토큰 | 1,809 | 1,864 |
프롬프트 처리는 약 2.1~4.2%, 생성은 v2 약 3.3%, ht43 약 1.5% 빨라졌다. 릴리스 노트는 여러 초안을 함께 검사하는 단계의 작업 감소를 개선 내용으로 든다. 표별로 같은 기계의 버전 간 변화만 비교했다.
새 이미지 태그로 NPU 파일 갱신
0.18.12 이미지의 HALOGEN_DOWNLOAD가 새 NPU 파일을 받는다. 다음은 이미지 모델 적재 후 사진 두 장을 합치는 원문 예시로, 두 번째 사진의 고양이를 첫 사진의 벤치에 놓으라는 요청이다.
curl -s localhost:8731/v1/images/edits -F model=flux2-klein-4b -F "image[]=@scene.png" -F "image[]=@cat.png" \
  -F prompt="put the cat from image 2 on the bench in image 1, matching its light" -F seed=7
보조 작업 활용 팀에 유리하나 메모리·전력은 공유
Flash 모델 옆에 분류·임베딩·리랭킹·검열·스트리밍 가드·음성 인식·이미지 생성·편집을 얹어 쓰던 팀이 가장 큰 수혜자다. 다만 Flash 모델은 NPU가 실제로 일하는 동안 조금 느려진다. 두 엔진이 메모리 버스와 칩의 전력 예산을 나누어 쓰기 때문이다.
출력은 프로젝트 릴리스 노트 기준으로 온도 0에서 0.18.11과 바이트 단위로 그대로다.
성능 개선과 새로 생긴 관측 지표가 필요하면 이미지 태그를 0.18.12로 바꾸고, 이미지 편집까지 쓰려면 HALOGEN_NPU_MODELS에 flux2-klein-4b를 더하면 된다.