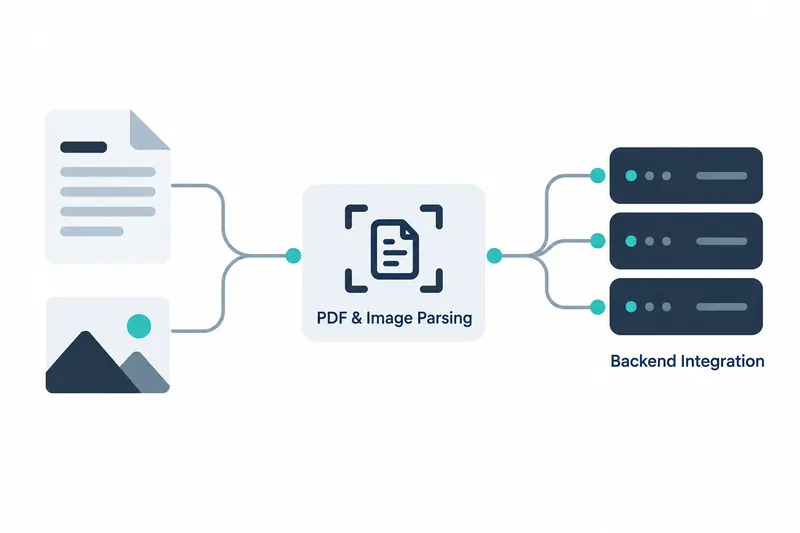
OpenBMBがMiniCPM-OCR SDK 1.0.2をPyPIで初公開した。開発者はPDFや画像を読み込み、本文・表・数式などをMarkdownに整理するパイプライン、つまり複数の処理工程をつなぐ流れを、コマンドラインやPython APIで構築できる。レイアウト解析と認識サービスが分離されており、モデル実行を担う既存の推論バックエンドに接続するか、対応バックエンドから1つを選ぶ方式だ。
1. 文書入力からMarkdown出力まで
SDKはレイアウト検出と視覚言語モデルによる認識を組み合わせ、文書要素を読む順序に沿って整理する。レイアウト検出は文書の領域と配置を見つける作業で、視覚言語モデルは画像と文章を併せて解釈するモデルだ。複数ページのPDFをまとめて出力でき、表はHTML、数式は数式記述形式のLaTeXで表現する。リリースではグラフと印章の認識も対応項目として挙げている。
数式の後処理は認識結果を整え、文中のインライン数式と独立した行に置くディスプレイ数式のLaTeX復元を支援する。リリースの説明によると、括弧の不整合や数式の区切り記号が欠けた一部のケースにも対応する。
2. コマンドラインで始め、設定を変える
組み込みのクイックスタート設定を使えば、別途設定ファイルを用意せずに実行できる。以下は原文のAPIドキュメントにあるコマンドだ。
minicpmvocr parse doc.pdf -o doc.md --device cuda:0 \
  --server-url http://127.0.0.1:18499 --model minicpm-ocr
コマンドライン引数や、人が読みやすい設定ファイル形式のYAMLで解析動作を調整でき、既定では最大32件の認識リクエストを同時に処理する。レイアウト検出と認識を重ねて実行する方式や、複数の認識サービスインスタンス、つまり実行中のプログラム単位への接続にも対応する。
既定のレイアウトモデルは現在の作業ディレクトリで確認し、存在しないか不完全な場合は自動でダウンロードする。
3. SDKと認識バックエンドの役割
パイプラインはSDKがレイアウトを検出し、文書ブロックを切り出して認識結果を再び組み立てる構造だ。実際のモデルによる認識は別のサービスが担い、両者は異なるPython環境で実行できる。
vLLMやOpenAI互換インターフェースで認識サービスを接続でき、llama.cppとOllamaにも対応する。
ローカル展開の案内では、文書処理と推論がいずれもローカルで行われ、原文書や成果物をクラウドOCRに送る必要はないと説明している。
4. ページ並列処理で変わるスループット
同社発表によると、下表はNVIDIA GeForce RTX 5090でOmniDocBench v1.6の全1,651画像を使ったMiniCPM-OCR 1.0のスループット、つまり単位時間当たりの処理量だ。一度に処理する画像数を変えた試験であり、文書ブロックを対象とするSDKの既定の認識リクエスト同時実行数32とは調整単位が異なる。
表:画像単位の同時実行数別MiniCPM-OCR 1.0のスループット
条件:NVIDIA GeForce RTX 5090、MiniCPM-OCR 1.0、OmniDocBench v1.6の全1,651画像、画像単位の同時実行数を変更
単位:pages/s
| 画像単位の同時実行数 | スループット |
|---|---|
| 1 | 1.217 |
| 2 | 1.613 |
| 4 | 1.888 |
| 6 | 2.031 |
| 8 | 2.133 |
画像単位の同時実行数別スループット (pages/s, 0基準)
1 | ████████████          1.217
2 | ████████████████      1.613
4 | ███████████████████   1.888
6 | ████████████████████  2.031
8 | █████████████████████ 2.133
同社発表によると、試験範囲では同時実行数8でスループットが最も高く、同時実行数1の1.75倍だった。ただし同時実行数が増すほど伸び幅は縮小し、スループットは同時実行数に比例しては増えなかった。ページを順番に処理する場合と複数ページをまとめて処理する場合の違いであり、大量の文書を扱うならページ単位の並列処理も調整点となる。
DSparkは主モデルと対になる補助モデルを併用して出力生成を加速する方式で、大量文書の解析時間短縮に使われる。同社発表では、DSparkのデコード加速でエンドツーエンドの処理効率が55%向上した。これは入力から結果までの処理性能を指す。
参照:README
参照:再現ガイド。この比較の詳細な実行コマンドと記録は今後補完すると記されている。
5. 統合コードより運用環境に目を向ける
出力されたMarkdownを後続の検索や文書処理の流れに渡したい開発者なら、ページ変換、要素抽出、結果の組み立てをそれぞれ実装する負担を減らせる。
実行前にSDKと互換性のある認識サービスを別途構成する必要がある。vLLMでDSpark加速を選ぶ場合は、主モデルに合うドラフトモデルも用意する必要がある。チュートリアルのvLLM導入例では、vLLM環境に約8GB、ソースとビルド成果物、つまりビルド過程で生成されるファイルに約6GBを使用し、ディスク容量を全体で40GB以上確保するよう案内している。
依存関係のインストールと初回のモデルダウンロードにはネットワーク接続も必要だ。既存の認識サービスを接続できるか、別の推論環境を維持できるかが導入判断の要点となる。
SDK 1.0.2は、認識バックエンドの選択肢を維持しつつ、文書解析の組み立て工程をパッケージにまとめたい開発者向けの選択肢だ。