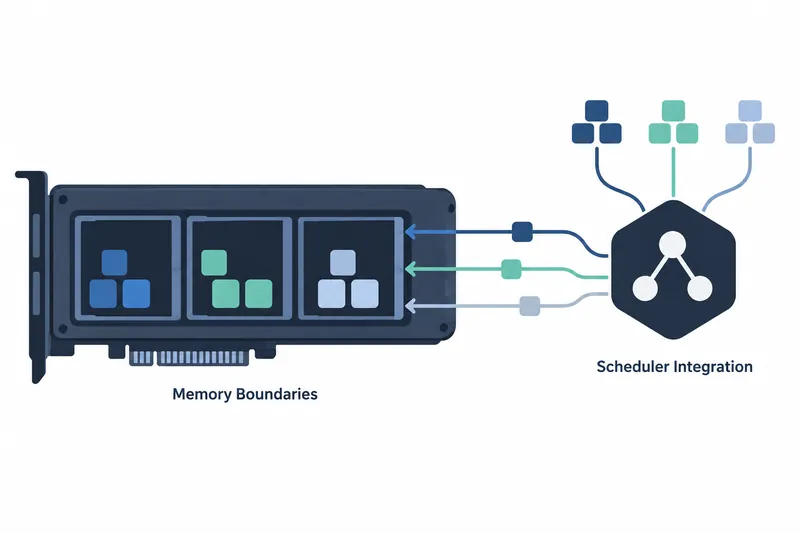
NVIDIAはCUDA 13.4で、GPUを共有するジョブごとにメモリ上限を強制する機能を公開した。GPUの一部だけを必要とするジョブを運用する開発・インフラチームは、Kubernetesでジョブごとの取り分を割り当て、実際の使用上限まで適用できる。
1. CUDA 13.4がメモリの取り分を強制する
GPU共有には、ハードウェアで分離したインスタンスに分割するMIG、プロセスがGPUを交代で使うtime-slicing、別々のアドレス空間で同時実行するMPSがある。NVIDIAはCUDA 13.4のメモリ境界の強制により、共有ジョブからは設定された上限分のメモリだけが見えるようにする。上限を省略して要求量に固定した場合、要求量を超える割り当ては、小容量のGPUと同様に失敗する。
ジョブは固定のメモリ容量を要求するか、保証される最小値と、空きメモリがある場合に拡張できる最大値を併せて設定できる。演算方式はデフォルトのtime-slicing、またはMPSのsm-sharingを選択する。time-slicingはジョブごとにGPUを使う順番を分け、sm-sharingはストリーミングマルチプロセッサーを分けてジョブを同時実行する。
2. ノード設定を自動管理するコンポーネントを追加する
Kubernetesでメモリ境界を適用するには、スケジューラーによるジョブ配置とGPUノードの設定を連携させる必要がある。ノードではプロセスの起動前に、コンテナごとのメモリ上限と演算モードを適用しなければならない。
これを担うgpu-fractioningは、ノード設定を自動管理するオープンソースのKubernetesオペレーターだ。KAI Schedulerの組織が公開し、各ノードでMPSを設定・実行して、ジョブごとのメモリ上限と演算モードを適用する。
ドライバーとコンテナ実行環境を設定するNVIDIA GPU Operatorと併用する。使用量もGPU全体ではなくジョブごとの取り分として測定するため、運用チームは各ジョブのメモリと演算リソースの使用状況を把握できる。
3. スケジューラーが割り当てた取り分をコンテナに伝える
スケジューラーは空きメモリが十分なGPUを選び、コンテナごとのPodアノテーションに割り当て情報を記録する。アノテーションは、メモリ割り当て、演算モード、GPUデバイスを伝える設定メモの役割を果たす。オペレーターがこれを読み取ってノードに適用するため、この情報を書き込めるKubernetesスケジューラーなら連携できる。
開発者はメモリを絶対容量またはGPUに対する比率で要求する。要求量は保証される最小の取り分であり、別途上限を指定すれば、空きメモリがある場合にその上限まで拡張して使える。上限は任意で、省略すると要求した容量に制限される。
4. KAI Schedulerはインストール設定で連携を有効にする
KAI Schedulerはgpu-fractioningと連携した最初のスケジューラーだ。バージョン0.18.0から新しいGPU共有モードを提供する。
このモードであるNvFractionsは、GPUごとの取り分を決め、アノテーションでオペレーターに伝える。従来の共有モードも維持され、管理者はクラスターごとに使用するモードを選ぶ。インストール時に次の設定を指定すると、gpu-fractioningも依存関係としてインストールされる。
helm upgrade -i kai-scheduler oci://ghcr.io/kai-scheduler/kai-scheduler/kai-scheduler \
  -n kai-scheduler --create-namespace \
  --set global.nvFractions.set=true
5. 時間分割と同時実行のトレードオフ
time-slicingではジョブがGPU全体を交代で使い、あるジョブの障害が別のジョブに波及しないよう分離する。sm-sharingは演算ユニットをジョブに必要に応じて配分し、同時実行する。NVIDIAの動作説明によると、共有ジョブ数がnで全ジョブが稼働中の場合、どちらの方式でも各ジョブは約1/nの演算リソースを得て、余ったリソースは他のジョブが活用する。
同時実行ではジョブが障害の影響を受ける領域を共有するため、互いに信頼できるジョブをまとめることが推奨される。1つのGPUには一度に1つの演算モードだけが適用され、KAI SchedulerはこれをGPUごとに追跡し、同じノードの異なるGPUに両モードを配置できる。
利点は、GPUの一部だけを必要とするジョブをまとめて配置し、各取り分の使用状況を把握できることだ。一方、運用チームはノードのオペレーターとMPSを管理し、スケジューラーが割り当て情報を正しく伝えるよう構成する必要がある。共有で余ったリソースを活用する代わりに、配置とノード設定を併せて管理する作業が加わる。
CUDAのメモリ境界の強制とスケジューラー連携は、GPU共有を単なる同時使用からジョブごとのリソース配分管理へと拡張する。