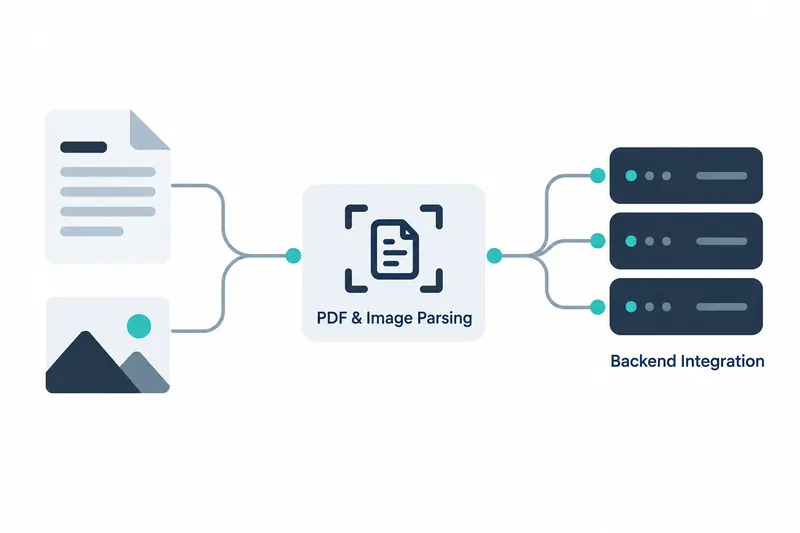
OpenBMB가 MiniCPM-OCR SDK 1.0.2를 PyPI에 처음 공개했다. 개발자는 PDF나 이미지를 읽어 본문·표·수식 등을 마크다운으로 정리하는 파이프라인, 여러 처리 단계를 잇는 흐름을 명령줄이나 Python API로 연결할 수 있다. 레이아웃 분석과 인식 서비스가 분리돼 있어 기존 추론 백엔드, 모델 실행을 맡는 구성요소에 붙이거나 지원 백엔드 가운데 하나를 선택하는 방식이다.
1. 문서 입력부터 마크다운 출력까지
SDK는 레이아웃 검출과 시각언어모델의 인식을 결합해 문서 요소를 읽기 순서에 맞춰 정리한다. 레이아웃 검출은 문서 영역과 배치를 찾는 작업이며, 시각언어모델은 이미지와 문장을 함께 해석하는 모델이다. 여러 쪽 PDF를 하나로 내보낼 수 있고 표는 HTML, 수식은 LaTeX, 수식을 적는 표기 형식으로 표현한다. 차트와 도장 인식도 릴리스에서 지원 항목으로 들었다.
수식 후처리는 인식 결과를 다듬어 문장 안의 인라인 수식과 별도 줄에 놓이는 독립 수식의 LaTeX 복원을 돕는다. 릴리스 설명에 따르면 괄호가 맞지 않거나 수식 구획 표시가 빠진 일부 사례도 처리한다.
2. 명령줄에서 시작하고 설정을 바꾼다
내장된 빠른 시작 설정을 사용하면 별도 설정 파일 없이 실행할 수 있다. 아래 예시는 원문 API 문서의 명령이다.
minicpmvocr parse doc.pdf -o doc.md --device cuda:0 \
  --server-url http://127.0.0.1:18499 --model minicpm-ocr
명령줄 인자나 YAML 설정, 사람이 읽기 쉬운 설정 파일 형식으로 파싱 동작을 조정할 수 있으며, 기본 설정은 인식 요청을 32개까지 동시에 처리한다. 레이아웃 검출과 인식의 중첩 실행, 두 작업을 겹쳐 수행하는 방식과 여러 인식 서비스 인스턴스, 실행 중인 프로그램 단위 연결도 지원한다.
기본 레이아웃 모델은 현재 작업 디렉터리에서 확인하고, 없거나 불완전하면 자동으로 내려받는다.
3. SDK와 인식 백엔드의 역할
파이프라인은 SDK가 레이아웃을 찾고 문서 블록을 잘라 인식 결과를 다시 조립하는 구조다. 실제 모델 인식은 별도의 서비스가 맡으며, 두 부분은 서로 다른 Python 환경에서 실행할 수 있다.
vLLM이나 OpenAI 호환 인터페이스로 인식 서비스를 연결할 수 있으며, llama.cpp와 Ollama도 지원한다.
로컬 배포 안내에서는 문서 처리와 추론이 모두 로컬에서 이뤄지며 원본 문서나 결과물을 클라우드 OCR에 보낼 필요가 없다고 설명한다.
4. 페이지 병렬 처리로 달라지는 처리량
회사 발표 기준, 아래 표는 NVIDIA GeForce RTX 5090에서 OmniDocBench v1.6 이미지 1,651개 전체를 사용한 MiniCPM-OCR 1.0의 처리량, 단위 시간에 처리하는 양이다. 한 번에 처리할 이미지 수를 바꾼 시험으로, 문서 블록을 대상으로 하는 SDK 기본 인식 요청 동시성 32와는 조정 단위가 다르다.
표: 이미지 단위 동시성별 MiniCPM-OCR 1.0 처리량
조건: NVIDIA GeForce RTX 5090, MiniCPM-OCR 1.0, OmniDocBench v1.6 이미지 1,651개 전체, 이미지 단위 동시성 변경
단위: pages/s
| 이미지 단위 동시성 | 처리량 |
|---|---|
| 1 | 1.217 |
| 2 | 1.613 |
| 4 | 1.888 |
| 6 | 2.031 |
| 8 | 2.133 |
이미지 단위 동시성에 따른 처리량 (pages/s, 0 기준)
1 | ████████████          1.217
2 | ████████████████      1.613
4 | ███████████████████   1.888
6 | ████████████████████  2.031
8 | █████████████████████ 2.133
회사 발표 기준, 시험 범위에서는 동시성 8이 가장 높은 처리량을 냈으며 동시성 1 대비 1.75배였다. 다만 동시성이 높아질수록 처리량 증가 폭은 줄어들어, 동시성에 비례해 처리량이 늘지는 않았다. 페이지를 차례로 처리할 때와 여러 페이지를 함께 처리할 때의 차이로, 대량 문서 작업이라면 페이지 단위 병렬 처리도 조정할 지점이다.
DSpark는 주 모델과 짝인 보조 모델을 함께 써 출력 생성을 가속하는 방식으로, 대량 문서 파싱 시간을 줄이는 데 쓰인다. 회사 발표 기준, DSpark 디코딩 가속으로 종단 처리 효율, 입력부터 결과까지의 처리 성능이 55% 향상됐다. 자세한 내용은 README를 참조할 수 있다. 재현 안내에는 이 비교의 상세 실행 명령과 기록이 추후 보완 대상으로 적혀 있다.
5. 통합 코드 대신 운영 환경을 챙긴다
결과 마크다운을 후속 검색이나 문서 처리 흐름에 넘기려는 개발자라면 페이지 변환, 요소 추출, 결과 조립을 각각 구현하는 부담을 줄일 수 있다.
실행 전 SDK와 호환되는 인식 서비스를 별도로 구성해야 한다. vLLM에서 DSpark 가속을 선택하면 주 모델에 맞는 초안 모델도 준비해야 한다. 튜토리얼의 vLLM 설치 예시는 vLLM 환경 약 8GB와 소스·빌드 산출물, 빌드 과정에서 생성된 파일 약 6GB를 사용하고 전체 디스크 40GB 이상을 확보하도록 안내한다.
설치 의존성과 최초 모델 다운로드에는 네트워크 연결도 필요하다. 이미 운영 중인 인식 서비스를 연결할 수 있는지와 별도 추론 환경을 감당할 수 있는지가 도입 판단의 핵심이다.
SDK 1.0.2는 인식 백엔드 선택을 유지하면서 문서 파싱의 조립 단계를 패키지로 묶으려는 개발자를 위한 선택지다.