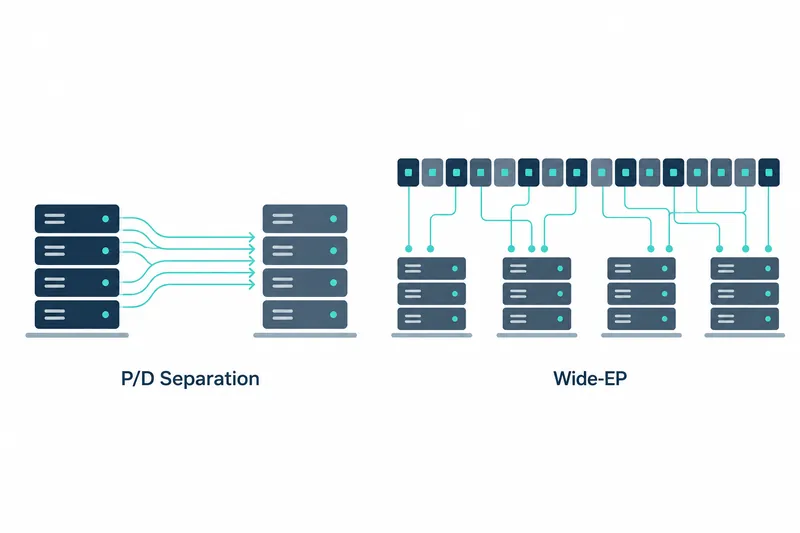
vLLM 面向大规模部署 DeepSeek-V4.1-Flash 的运营者,公布了将输入处理和回答生成分配给不同 GPU 组的结果。它还将模型内部的计算模块——专家广泛分布到多块 GPU 上,在单个 NVIDIA GB300 NVL72 机架内提高了吞吐量和用户响应速度。
1. 单机架吞吐量达到此前结果合计值的 7.9 倍
据公司公布的数据,在 SemiAnalysis AgentX 测试中,单 GPU 吞吐量为每秒 95.4 万个 token,是此前公布的单节点结果合计值的 7.9 倍。该吞吐量包含已缓存输入、未缓存输入和输出 token。
以分布的第 90 百分位数 P90 衡量,每位用户的速度为每秒 196 个 token。按 DeepSeek 的夜间费率折算,每 GPU 小时的金额为 38.96 美元。
团队还公布了与模型专用引擎的比较。在 GB200 上采用 32 块 GPU 并行、上下文 131K、nextn=3、批大小即每批处理请求数为 8~256 的条件下,vLLM 的生成吞吐量与 DeepSeek 引擎 DeepInfer 的公开结果相差不超过 6%。
2. 输入采用小组处理,生成则广泛分散
一次性处理输入的预填充与随后持续生成回答的解码,在资源使用上具有不同特点。P/D 分离将两个阶段分配给独立的 GPU 组,从而为各阶段选择合适的并行规模。
结合输入数据处理与专家计算分散的并行配置称为 DEP,后面的数字代表参与的 GPU 数量。开发团队解释,小规模配置更容易均匀分配工作量,因此有利于预填充。
在 AgentX 的预填充专项测试中,并发度即同时处理的请求数为 256 时,DEP2 的单 GPU 吞吐量为每秒 64.4K 个 token。DEP4 则降至 53.3K。对于输入处理,采用较小的 GPU 组比扩大 GPU 分组更高效。
3. 即使输入很长,生成阶段的计算量也仅缓慢增长
该模型通过层间共享和压缩,缩减存储此前输入计算信息的 KV 缓存。在 128K 上下文、DEP4、每个 rank(GPU 工作单元)64 个请求的条件下测量时,主模型生成阶段耗时的 62% 用于混合专家计算,即组合多个专家模块的计算。
在 GB300 的 DEP32 配置下,以每个 rank 16 个请求、每个请求 6 个 token 测量主模型执行时间。即使上下文从 128K 扩大至 855K,执行时间也仅从 8.93 毫秒增加到 9.53 毫秒。
表:不同上下文长度下的主模型执行时间
条件:DeepSeek-V4.1-Flash、GB300、DEP32、每个 rank 16 个请求、每个请求 6 个 token,所有请求的上下文长度相同
单位:毫秒
| 项目 | 64K | 128K | 256K | 512K | 855K |
|---|---|---|---|---|---|
| 主模型执行时间 | 8.86 | 8.93 | 9.03 | 9.25 | 9.53 |
由于上下文长度带来的时间差异很小,生成请求更容易按请求数量而非长度分配。开发团队分别测量了模型本身的执行时间与实际服务时间,测量模型执行时间时使用了以下命令。
vllm bench forward4. 专家分散的收益与通信成本相互牵制
Wide-EP 将专家计算分配给更多 GPU 工作单元,减少各单元需要读取的专家权重。在 GB200 上,以 128K 上下文、每 GPU 64 个请求并启用专家负载重分配功能,从 DEP4 到 DEP32 进行了测试。主模型的专家计算时间从 13.4 毫秒降至 6.0 毫秒。
这些收益的代价是通信和任务分配管理。其余任务耗时保持在约 10 毫秒,而在 DEP32 下,用于提前提出后续 token 的辅助模型,其通信成本抵消了部分并行化收益。
开发团队通过观察专家负载并调整布局的 EPLB 减少任务集中。团队不仅对主模型,也对辅助模型分别应用该机制,并通过基于 NVLink 的实现,在不停止解码的情况下于 1 秒内调整了整个 DEP32 的专家布局。
5. 增加 GPU 的同时,也要优化 CPU 处理
Wide-EP 在每一层同步各 GPU 工作单元的进度,因此一个慢任务就可能拖累整体。开发团队改变了生成侧 CPU 以同步方式、等待请求结果来读取输入信息的做法,并降低 CPU 间同步和新请求处理的开销。据公司公布的数据,在 GB300、8P1D、并发请求数 3,072 的条件下,将 KV 传输改为 NIXL push 后,单 GPU 吞吐量从每秒 141K 提升至 440K 个 token。这表明,要将 GPU 计算时间的缩短转化为实际响应速度的提升,周边处理也必须同步提速。
团队还为少量用户提供了独立的低延迟生成路径,以缩短响应等待时间。在实际 AgentX 会话中,面向一名用户、将模型计算分布到四块 B300 GPU 上时,P90 速度达到每秒 826 个 token。相同条件下,标准路径为每秒 575 个 token。
vLLM 的结果表明,针对输入与生成分配资源、平衡专家负载,以及管理通信和 CPU 成本,是大规模服务的关键。