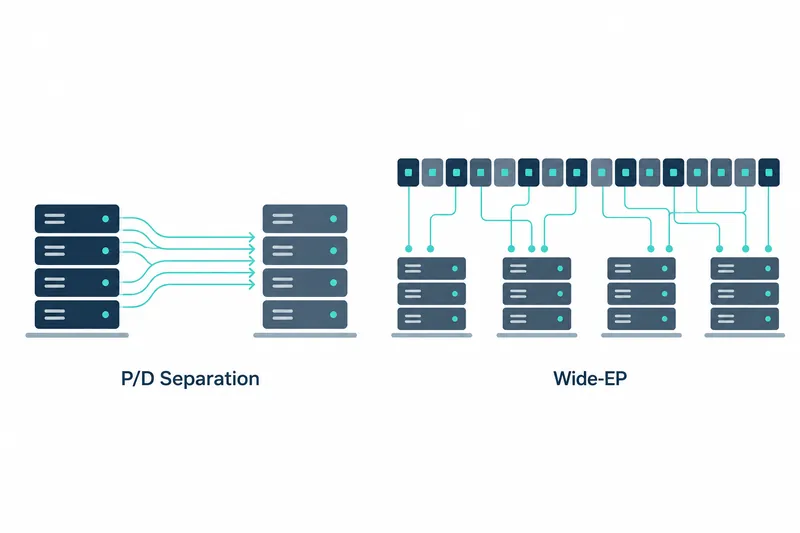
vLLMはDeepSeek-V4.1-Flashを大規模に提供する運用者向けに、入力処理と回答生成を異なるGPU群に割り当てた結果を公開した。モデル内の計算モジュールであるエキスパートも複数のGPUに広く分散し、NVIDIA GB300 NVL72の1ラックでスループットとユーザーへの応答速度を向上させた。
1. 1ラックで従来の合算結果の7.9倍のスループット
同社発表によると、SemiAnalysis AgentX試験のGPU当たりのスループットは毎秒95万4千トークンで、以前公開した単一ノードの結果を合算した値の7.9倍だった。このスループットには、キャッシュ済み入力、未キャッシュ入力、出力のトークンがすべて含まれる。
ユーザー当たりの速度は、分布の90パーセンタイル値であるP90で毎秒196トークンだった。DeepSeekの深夜料金を適用したGPU時間当たりの換算額は38.96ドルと示された。
モデル専用エンジンとの比較も公開した。GB200の32基のGPUによる並列構成で、コンテキスト131K、nextn=3、バッチサイズ、つまり一度にまとめて処理するリクエスト数8~256で試験したvLLMの生成スループットは、DeepSeekのエンジンDeepInferの公開結果との差が6%以内だった。
2. 入力は小さなグループで、生成は広く分散する
入力を一括処理するプリフィルと、その後の回答を順次生成するデコードでは、リソース使用の特性が異なる。両段階を別々のGPU群に分けるP/D分離により、各段階に適した並列規模を選べる。
入力データの処理とエキスパート演算の分散を組み合わせた並列構成をDEPと呼び、後ろの数字は参加するGPU数を表す。小規模な構成は処理量を均等に分けやすく、プリフィルに有利だと開発チームは説明する。
AgentXのプリフィル専用試験では、同時実行数、つまり同時に処理するリクエスト数が256のとき、DEP2のGPU当たりのスループットは毎秒64.4Kトークンだった。DEP4では53.3Kに低下した。入力処理ではGPUを大きくまとめるより、小さなグループを使うほうが効率的だった。
3. 長い入力でも生成段階の演算量の増加は緩やかだった
このモデルは層間の共有と圧縮により、過去の入力の計算情報を保持するKVキャッシュを削減する。128KコンテキストでDEP4、GPUごとの作業単位であるランク当たりリクエスト64件で測定したところ、本体モデルの生成段階の時間の62%を、複数のエキスパートモジュールを組み合わせる混合エキスパート演算が占めた。
GB300のDEP32では、ランク当たりリクエスト16件、リクエスト当たり6トークンで本体モデルの実行時間を測定した。コンテキストを128Kから855Kに増やしても、実行時間は8.93ミリ秒から9.53ミリ秒への増加にとどまった。
表:コンテキスト長に応じた本体モデルの実行時間
条件:DeepSeek-V4.1-Flash、GB300、DEP32、ランク当たり16件のリクエスト、リクエスト当たり6トークン、全リクエストのコンテキスト長は同一
単位:ミリ秒
| 項目 | 64K | 128K | 256K | 512K | 855K |
|---|---|---|---|---|---|
| 本体モデルの実行時間 | 8.86 | 8.93 | 9.03 | 9.25 | 9.53 |
このようにコンテキストによる時間差が小さいため、生成リクエストは長さよりも件数を基準に分配しやすかった。開発チームはモデル自体の実行時間と実際のサービング時間を別々に測定し、モデルの実行測定には次のコマンドを使った。
vllm bench forward4. エキスパート分散の利点は通信コストと表裏一体
Wide-EPは、エキスパート演算をより多くのGPU作業単位に分散し、それぞれが読み込むエキスパートの重みを減らす方式だ。GB200でコンテキスト128K、GPU当たりリクエスト64件、エキスパート負荷の再配置機能を有効にした条件でDEP4からDEP32まで試験した。本体モデルのエキスパート演算時間は13.4ミリ秒から6.0ミリ秒に短縮された。
その利点の代償となるのが、通信と作業分配の管理だ。残りの処理は約10ミリ秒にとどまり、DEP32では次のトークンを先に提案する補助モデルの通信コストが、並列化の利点を一部相殺した。
開発チームは、エキスパートの負荷を観測して配置を変えるEPLBで、処理の偏りを減らした。本体モデルだけでなく補助モデルにも個別に適用し、NVLinkベースの実装により、デコードを止めずにDEP32全体のエキスパート配置を1秒以内に変更した。
5. GPUを増やすほどCPU処理も併せて改善する
Wide-EPは各層でGPU作業単位の進行をそろえるため、1つの遅い処理が全体を遅延させうる。開発チームは、生成側CPUが要求の結果を待つ同期方式で入力情報を読み込む方法を変更し、CPU間の同期と新規リクエスト処理のコストを削減した。同社発表ではGB300、8P1D、同時リクエスト3,072件でKV転送をNIXL pushに改善すると、GPU当たりのスループットは毎秒141Kから440Kトークンに増加した。GPU演算の短縮を実際の応答速度につなげるには、周辺処理も高速化する必要があることを示す結果だ。
少数のユーザー向けに、応答の待ち時間を減らす専用の低遅延生成経路も用意した。実際のAgentXセッションでは、ユーザー1人、B300 GPU4基にモデル演算を分散する条件で、P90で毎秒826トークンを記録した。同じ条件の標準経路では毎秒575トークンだった。
vLLMの結果は、入力と生成に適したリソース配分、エキスパートの負荷均衡、通信・CPUコストの管理が大規模サービングの鍵であることを示している。