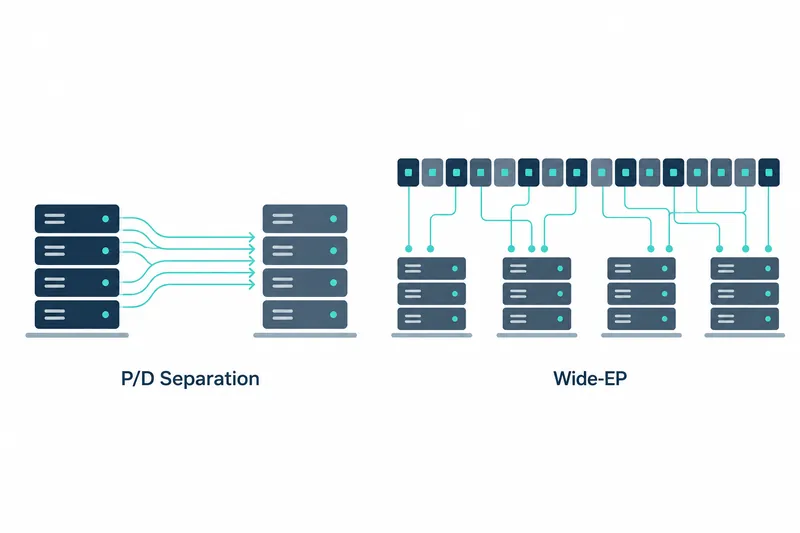
vLLM이 DeepSeek-V4.1-Flash를 대규모로 서비스하는 운영자를 위해 입력 처리와 답변 생성을 서로 다른 GPU 묶음에 맡긴 결과를 공개했다. 모델 안의 계산 모듈인 전문가도 여러 GPU에 넓게 나눠, NVIDIA GB300 NVL72 한 랙에서 처리량과 사용자 응답 속도를 높였다.
1. 한 랙에서 기존 합산 결과보다 처리량 7.9배
회사 발표 기준, SemiAnalysis AgentX 시험의 GPU당 처리량은 초당 95만4천 토큰으로 앞서 공개한 단일 노드 결과를 합산한 값의 7.9배였다. 이 처리량에는 캐시된 입력, 캐시되지 않은 입력, 출력 토큰이 모두 포함된다.
사용자당 속도는 분포의 90백분위 값인 P90으로 초당 196토큰이었다. DeepSeek의 심야 요금을 적용한 GPU 시간당 환산액은 38.96달러로 제시됐다.
모델 전용 엔진과의 비교도 공개했다. GB200의 32개 GPU 병렬 구성에서 컨텍스트 131K, nextn=3, 배치 크기, 한 번에 묶어 처리하는 요청 수 8~256으로 시험한 vLLM의 생성 처리량은 DeepSeek 엔진 DeepInfer의 공개 결과와 6% 이내 차이를 보였다.
2. 입력은 작은 묶음으로, 생성은 넓게 분산한다
입력을 한꺼번에 처리하는 프리필과 이후 답변을 이어 만드는 디코드는 자원 사용 특성이 다르다. 두 단계를 별도 GPU 묶음으로 나누는 P/D 분리는 각 단계에 맞는 병렬 규모를 선택하게 한다.
입력 데이터 처리와 전문가 연산 분산을 결합한 병렬 구성을 DEP라고 하며, 뒤 숫자는 참여 GPU 수다. 작은 구성은 작업량을 고르게 나누기 쉬워 프리필에 유리하다는 것이 개발팀의 설명이다.
AgentX의 프리필 전용 시험에서 동시성, 동시에 처리하는 요청 수 256일 때 DEP2의 GPU당 처리량은 초당 64.4K 토큰이었다. DEP4에서는 53.3K로 낮아졌다. 입력 처리에는 GPU를 더 크게 묶는 것보다 작은 묶음을 쓰는 편이 효율적이었다.
3. 긴 입력에서도 생성 단계의 연산량은 완만하게 늘었다
이 모델은 계층 간 공유와 압축으로 이전 입력의 계산 정보를 담는 KV 캐시를 줄인다. 128K 컨텍스트에서 DEP4, GPU별 작업 단위인 랭크당 요청 64개로 측정했을 때, 본 모델의 생성 단계 시간 중 62%는 전문가 혼합 연산, 여러 전문가 모듈을 조합하는 계산이 차지했다.
GB300의 DEP32에서는 랭크당 요청 16개, 요청당 6개 토큰으로 본 모델의 실행 시간을 측정했다. 컨텍스트를 128K에서 855K로 늘려도 실행 시간은 8.93밀리초에서 9.53밀리초로 늘어나는 데 그쳤다.
표: 컨텍스트 길이에 따른 본 모델 실행 시간
조건: DeepSeek-V4.1-Flash, GB300, DEP32, 랭크당 16개 요청, 요청당 6개 토큰, 모든 요청의 컨텍스트 길이 동일
단위: 밀리초
| 항목 | 64K | 128K | 256K | 512K | 855K |
|---|---|---|---|---|---|
| 본 모델 실행 시간 | 8.86 | 8.93 | 9.03 | 9.25 | 9.53 |
이처럼 컨텍스트에 따른 시간 차이가 작아, 생성 요청은 길이보다 요청 수를 기준으로 분배하기 쉬웠다. 개발팀은 모델 자체의 실행 시간과 실제 서빙 시간을 따로 측정했으며, 모델 실행 측정에는 다음 명령을 썼다.
vllm bench forward4. 전문가 분산의 이득은 통신 비용과 맞물린다
Wide-EP는 전문가 연산을 더 많은 GPU 작업 단위에 나눠 각자 읽어야 할 전문가 가중치를 줄이는 방식이다. GB200에서 컨텍스트 128K, GPU당 요청 64개, 전문가 부하 재배치 기능을 켠 조건으로 DEP4부터 DEP32까지 시험했다. 본 모델의 전문가 연산 시간은 13.4밀리초에서 6.0밀리초로 줄었다.
이득의 대가는 통신과 작업 배분 관리다. 나머지 작업은 약 10밀리초에 머물렀고, DEP32에서는 다음 토큰을 미리 제안하는 보조 모델의 통신 비용이 병렬화 이득을 일부 상쇄했다.
개발팀은 전문가 부하를 관찰해 배치를 바꾸는 EPLB로 작업 쏠림을 줄였다. 본 모델뿐 아니라 보조 모델에도 따로 적용했고, NVLink 기반 구현으로 디코드를 멈추지 않고 DEP32 전체의 전문가 배치를 1초 안에 바꿨다.
5. GPU를 늘릴수록 CPU 처리도 함께 다듬는다
Wide-EP는 매 계층에서 GPU 작업 단위들의 진행을 맞추므로 느린 작업 하나가 전체를 지연시킬 수 있다. 개발팀은 생성 측 CPU가 입력 정보를 동기식으로, 요청 결과를 기다리며 처리하는 방식으로 읽던 방식을 바꾸고, CPU 간 동기화와 새 요청 처리 비용을 줄였다. 회사 발표 기준 GB300, 8P1D, 동시 요청 3,072개 조건에서 KV 전송을 NIXL push로 개선하자 GPU당 처리량이 초당 141K에서 440K토큰으로 늘었다. GPU 연산 단축을 실제 응답 속도로 연결하려면 주변 처리도 함께 빨라져야 한다는 결과다.
적은 사용자를 위한 별도 저지연, 응답 대기 시간을 줄인 생성 경로도 마련했다. 실제 AgentX 세션에서 사용자 한 명, B300 GPU 네 장에 모델 연산을 나눈 조건으로 P90 초당 826토큰을 기록했다. 같은 조건의 표준 경로는 초당 575토큰이었다.
vLLM의 결과는 입력과 생성에 맞춘 자원 배분, 전문가 부하 균형, 통신·CPU 비용 관리를 대규모 서빙의 핵심으로 제시한다.