Nanbeige LLM Lab 在 Hugging Face 发布了 Nanbeige4.3-33B 权重。模型 API 中 createdAt 字段记录的仓库创建时间为 2026 年 10 月 24 日。这一创建时间戳只说明仓库何时建立,并不能证明权重何时首次公开可用。它支持最大 524,288 token(512K)上下文,为自行运行编程智能体和内部业务自动化的团队增加了一个选择。模型卡将 20 项基准测试中的 17 项标为对比组最高分,发布方称其智能体性能在 30B 级开放权重模型中领先。
性能:在编程智能体基准测试中领先对比组
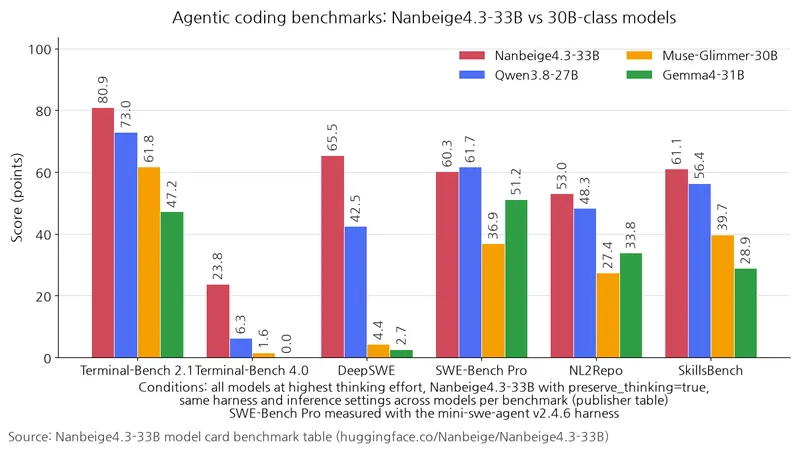
在 8 项编程智能体基准测试中,有 7 项取得对比组最高分。表中前两项测试分别领先 17.5 分和 23.0 分,但第三项落后 1.4 分,优势随编程任务类型而变化。
表:代表性编程智能体性能
条件:依据发布方模型卡。所有模型均以最高推理强度评测,每项测试中各模型使用相同的评测框架和推理设置。Nanbeige4.3-33B 使用 preserve_thinking=true 评测。此表中的 mini-swe-agent v2.4.6 条件仅适用于原文明确注明的 Terminal-Bench 4.0 和 DeepSWE。
| 基准测试 | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 4.0 | 23.8 | 6.3 |
| DeepSWE | 65.5 | 42.5 |
| SWE-Bench Pro | 60.3 | 61.7 |
单位:分数(越高越好)
在 9 项业务自动化测试中,也有 8 项取得对比组最高分。不仅在 600 项公开任务的评测中表现突出,在涵盖 35 个职业的评测中,也在多数职业上领先基准模型。
表:业务自动化代表性结果
条件:发布方模型卡中的评测。Automation Bench v1.0.6 使用 600 项公开任务,JobBench 在 Claude Code 评测框架中配备搜索工具,对 35 个职业进行评测。YC-bench 在每次模型调用前,仅保留用户对话最近 10 轮作为历史上下文。
单位:分数,仅 YC-bench 为美元($)
| 基准测试 | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Automation Bench v1.0.6 | 54.2 | 38.3 |
| JobBench | 44.8 | 34.5 |
| YC-bench | $1,025,437 | $641,290 |
推理评测中,GPQA Diamond 得分为 89.5,低于 Gemma4-31B 的 91.3 分,而 AIME 2026 得分为 95.2,高于 Qwen3.8-27B 的 94.5 分。与业务自动化上的广泛优势不同,推理方面的相对优势因评测而异。
自行部署
权重采用 Apache-2.0 许可,模型卡中的运行示例以自行托管为前提。vLLM 和 SGLang 示例将张量并行度设为 4,即用四块 GPU 共同运行一个模型。GitHub 上的 Nanbeige 组织公开了 llama.cpp、sglang、vllm、ollama 的分叉版本,即复制现有代码后独立开发的版本。
用途:从 33B 教师模型到小模型
上一款小模型 Nanbeige4.2-3B 的上下文为 256K,此次 33B 模型则支持 512K。发布方表示,Nanbeige4.3-33B 被设计为指导小模型训练的教师模型。它是将智能体行为蒸馏到小模型这一计划的基础,Nanbeige4.3-3B 被列为下一个目标。
基础模型,即额外训练之前的初始模型 Nanbeige4.3-33B-Base 也已公开。据基础模型卡,该基础模型的 MMLU-Pro 为 66.9、GPQA 为 62.0,高于 Gemma4-31B-Base 的 59.3 和 41.5。
如何试用
模型卡的聊天模板提供三个开关。enable_thinking 默认开启,preserve_thinking 用于将先前回复的推理保留在对话历史中。建议在普通对话和问答中关闭,在多步骤工具使用、办公任务和编程智能体中开启。工具调用格式推荐 xml,也支持 json。默认系统提示词,即为模型提供默认指令的输入文本,采用中文,因此最好自行传入系统消息来指定语言。
推荐推理设置为:工具任务使用 temperature 1.0、top_p 0.95、最大新生成 token 数 65,536,推理和对话则为 0.6、0.95、262,144。最大上下文 524,288 token 用于容纳输入和对话历史,而最大新生成 token 数是新生成输出的上限。工具任务的推荐输出上限为推理和对话的 4 分之 1。
vllm serve Nanbeige/Nanbeige4.3-33B \
  --tensor-parallel-size 4 \
  --enable-auto-tool-choice \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder
局限
在发布方评测中,使用修订版评分量规(评测项目和评分标准表)打分的 GDPval 上,Qwen3.8-27B 领先,而 Terminal-Bench 4.0 的绝对分数较低。
此次发布体现了面向小型智能体蒸馏的教师模型策略,采用决策的重点应是其对多步骤工具使用和编程任务的适用性,而非通用推理排名。