Unsloth在2026年10月19日的版本发布中,公开了对DeepSeek-V4.1-Flash-1017进行动态量化的GGUF文件和本地运行指南。开发者将Engram表放在SSD上后,据Unsloth估计,可在128–145GB内存级别的设备上运行1位配置,从而有更多机会选择本地运行而非API。
量化评估与结果
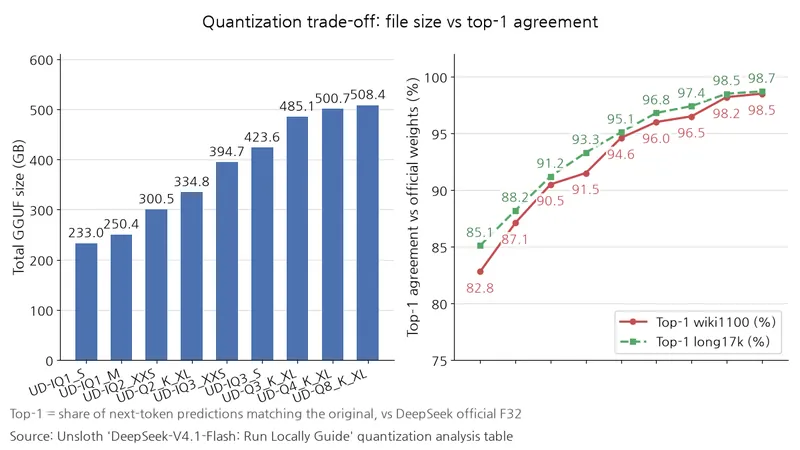
目前模型中心已上架9种量化版本。量化是通过调整数值精度缩减体积的处理,GGUF则是存放模型权重的文件格式。Unsloth将各文件与DeepSeek官方F32(32位浮点数)权重进行比较。在wiki1100和long17k数据集上,同时测量了表示概率分布差异的KL,以及下一词元预测与原版相同的比例,即top-1一致率。
表:各量化版本的文件大小与top-1一致率
条件:Unsloth Dynamic GGUF,与DeepSeek官方F32权重比较。top-1为下一词元预测与原版一致的比例,非Engram权重为除Engram表以外的权重大小,也是所需内存的绝对最小值。
单位:总大小、非Engram权重为GB,top-1一致率为%
| 量化版本 | 总大小 | top-1 wiki1100 | top-1 long17k | 非Engram权重 |
|---|---|---|---|---|
| UD-IQ1_S | 233.0 | 82.8 | 85.1 | 122.4 |
| UD-IQ1_M | 250.4 | 87.1 | 88.2 | 139.8 |
| UD-IQ2_XXS | 300.5 | 90.5 | 91.2 | 165.3 |
| UD-Q2_K_XL | 334.8 | 91.5 | 93.3 | 199.6 |
| UD-IQ3_XXS | 394.7 | 94.6 | 95.1 | 233.5 |
| UD-IQ3_S | 423.6 | 96.0 | 96.8 | 262.3 |
| UD-Q3_K_XL | 485.1 | 96.5 | 97.4 | 282.3 |
| UD-Q4_K_XL | 500.7 | 98.2 | 98.5 | 297.9 |
| UD-Q8_K_XL | 508.4 | 98.5 | 98.7 | 305.6 |
来源:Unsloth量化分析
1位IQ1_S比Unsloth归类为无损的UD-Q8_K_XL小约54%。IQ1_M仅增加17.4GB,即可在wiki1100上挽回4.3%p、在long17k上挽回3.1%p。4位Q4_K_XL比同一UD-Q8_K_XL小7.7GB,一致率差距仅为wiki1100的0.3%p和long17k的0.2%p。
内存需求
1位UD-IQ1_S的下载大小为233.0GB,其中存放在SSD上的Engram表为110.6GB。
表:各量化位数档位的所需内存估计值
条件:Unsloth文档按位数档位给出的估计值,以RAM+VRAM或统一内存为准,Engram保留在SSD上。该值比非Engram权重多预留约5~10GB,实际可能因上下文和运行时而需要更多内存。
单位:GB
| 位数档位 | Unsloth估计所需内存 |
|---|---|
| 1位 | 128–145 |
| 2位 | 176–205 |
| 3位 | 256–290 |
| 4位 | 305 |
| 8位 | 315 |
位数越高,所需内存越大。各位数档位的估计值并非每个文件的最小值,而是按位数档位标注,因此1位下限不适用于IQ1_M这类非Engram权重较大的文件。
官方基准测试
表:DeepSeek官方基准测试得分对比
条件:基于DeepSeek官方模型卡的原始模型得分。Terminal-Bench 4.0使用Claude Code测试框架,将执行环境一并纳入测试的工具DeepSWE v1.1使用Mini-SWE-V2测试框架。
| 基准测试 | V4.1-Flash-1017 | 上一版V4.1-Flash |
|---|---|---|
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
从开发任务角度看,Terminal-Bench 4.0的改进为考虑在Claude Code环境中使用提供了依据,DeepSWE v1.1的改进则为考察基于Mini-SWE-V2的开发流程提供了依据。筛选程序编写候选模型时可参考ProgramBench,筛选自然语言仓库操作候选模型时可参考NL2Repo-Bench。但此表展示的是原始模型结果,并不意味着1位配置也能保持相同的任务得分。
为何会有这些差异
模型由作为核心神经网络的552B骨干网络和独立的196B参数Engram表组成,实际参与计算的激活参数约为16B。Engram是一种条件内存,最多组合最近4个词元,只读取表中的少数行。因此可以采用SSD卸载,即将数据移到磁盘上,把110.6–202.8GB的表放在SSD上,仅将所需行载入OS缓存。这样能节省RAM和VRAM,但磁盘占用不变。
各量化档位对MoE与其余权重采用不同处理,MoE是仅计算激活参数的混合专家结构。DeepSeek原版混用MXFP4、FP8和BF16,Unsloth的4位与8位档位保留相同的MXFP4专家和Engram表。4位配置将多数非专家权重设为Q8_0,8位配置则设为BF16,因此档位名称不能反映所有张量的精度。文档注明,Unsloth Dynamic 3.0仅使用校准数据进行训练后量化。
速度提升来自DSpark,即先提出多个词元、再由主模型验证的加速解码。DSpark与Engram相互独立,因此可组合使用以同时节省内存并加速解码。据Unsloth说明,在支持DSpark的配置中,解码速度提高约1.3~1.5倍;先生成草稿回答的辅助模型,即草稿模块,提供Q8_0 8GB和BF16 8.5GB版本。Unsloth称,基于llama.cpp的配置比其他CPU、VRAM、n-gram存储方案快约3倍。
DSpark是可选步骤,需具备版本匹配的V4.1-1017草稿模型、支持DSpark的运行时,以及供草稿模型使用的额外内存。
选择标准
按Unsloth估计,128GB级别内存的设备可首先考虑1位UD-IQ1_S,Unsloth表示该配置能在Macbook、DGX Spark、RTX Spark等设备上运行。256GB级别可选择3位UD-IQ3_XXS,而4位UD-Q4_K_XL在两个数据集上均显示出较高一致率。
若想节省磁盘空间,可以降低Engram精度。IQ4_NL、Q5_K、Q6_K、MXFP8这四种表已作为独立文件上架,大小为110.6GB至202.8GB;也可仅将1位档位的IQ4_NL表替换为MXFP8,但这样会使表增大92.2GB。
若要自行构建,需要Unsloth的llama.cpp PR。
推理强度默认值为75。以下是Unsloth文档中附加到运行命令的选项示例。
--chat-template-kwargs '{"reasoning_effort":75}'权重和模型卡采用MIT许可证发布。
优先考虑内存和文件大小时可选1位配置,优先保留原版预测时可选4位配置,并可在Unsloth Chat或模型中心选择适合设备的文件后将Engram放在SSD上。