Unsloth는 2026년 10월 19일 릴리스에서 DeepSeek-V4.1-Flash-1017에 동적 양자화를 적용한 GGUF 파일과 로컬 구동 가이드를 공개했다. 개발자는 Engram 테이블을 SSD에 두면 1비트 구성을 Unsloth 추정 128–145GB 메모리급 기기에서 실행할 수 있어, API 대신 로컬 구동을 선택할 여지가 넓어졌다.
양자화 평가와 결과
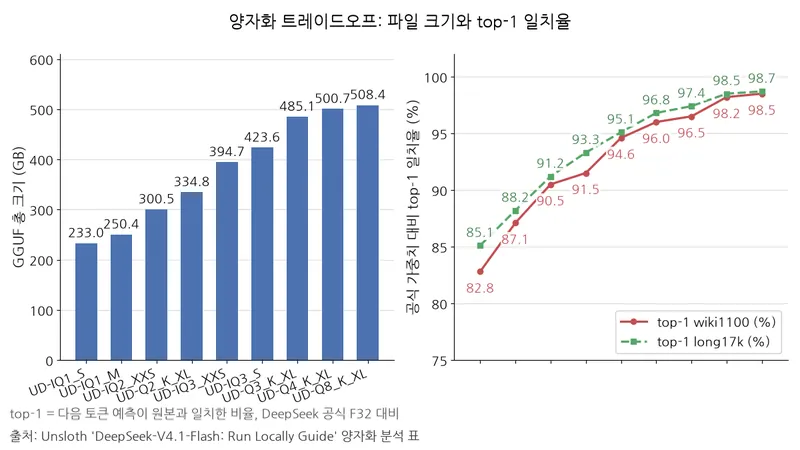
현재 모델 허브에는 9종 양자화가 올라가 있다. 양자화는 수치 정밀도를 조정해 용량을 줄이는 처리이고, GGUF는 모델 가중치를 담는 파일 형식이다. Unsloth는 각 파일을 DeepSeek 공식 F32(32비트 부동소수점) 가중치와 비교했다. wiki1100과 long17k 데이터셋에서 확률 분포 차이를 나타내는 KL과 다음 토큰 예측이 원본과 같은 비율인 top-1 일치율을 함께 측정했다.
표: 양자화별 파일 크기와 top-1 일치율
조건: Unsloth Dynamic GGUF, DeepSeek 공식 F32 가중치 대비. top-1은 다음 토큰 예측이 원본과 일치한 비율, 비-Engram 가중치는 Engram 테이블을 뺀 나머지 가중치 크기이자 필요 메모리의 절대 최솟값.
단위: 총 크기·비-Engram 가중치 GB, top-1 일치율 %
| 양자화 | 총 크기 | top-1 wiki1100 | top-1 long17k | 비-Engram 가중치 |
|---|---|---|---|---|
| UD-IQ1_S | 233.0 | 82.8 | 85.1 | 122.4 |
| UD-IQ1_M | 250.4 | 87.1 | 88.2 | 139.8 |
| UD-IQ2_XXS | 300.5 | 90.5 | 91.2 | 165.3 |
| UD-Q2_K_XL | 334.8 | 91.5 | 93.3 | 199.6 |
| UD-IQ3_XXS | 394.7 | 94.6 | 95.1 | 233.5 |
| UD-IQ3_S | 423.6 | 96.0 | 96.8 | 262.3 |
| UD-Q3_K_XL | 485.1 | 96.5 | 97.4 | 282.3 |
| UD-Q4_K_XL | 500.7 | 98.2 | 98.5 | 297.9 |
| UD-Q8_K_XL | 508.4 | 98.5 | 98.7 | 305.6 |
출처: Unsloth 양자화 분석
1비트 IQ1_S는 Unsloth가 무손실로 분류한 UD-Q8_K_XL보다 약 54% 작다. IQ1_M은 17.4GB만 더 얹어 wiki1100에서 4.3%p, long17k에서 3.1%p를 되찾는다. 4비트 Q4_K_XL은 같은 UD-Q8_K_XL보다 7.7GB 작고 일치율 차이는 wiki1100 0.3%p, long17k 0.2%p뿐이다.
메모리 요구량
1비트 UD-IQ1_S의 다운로드 크기는 233.0GB이며, 이 중 SSD에 두는 Engram 테이블은 110.6GB다.
표: 양자화 비트 단계별 필요 메모리 추정치
조건: Unsloth 문서가 비트 단계별로 낸 추정치, RAM+VRAM 또는 통합 메모리 기준이고 Engram은 SSD 유지. 비-Engram 가중치보다 약 5~10GB를 더 잡은 값이라 컨텍스트와 런타임에 따라 더 필요할 수 있다.
단위: GB
| 비트 단계 | Unsloth 추정 필요 메모리 |
|---|---|
| 1비트 | 128–145 |
| 2비트 | 176–205 |
| 3비트 | 256–290 |
| 4비트 | 305 |
| 8비트 | 315 |
비트 수가 오를수록 필요한 메모리가 급격히 커진다. 비트 단계별 추정치는 파일별 최솟값이 아니라 비트 단계 표기라 IQ1_M처럼 비-Engram 가중치가 큰 파일에는 1비트 하한이 적용되지 않는다.
공식 벤치마크
표: DeepSeek 공식 벤치마크 점수 비교
조건: DeepSeek 공식 모델 카드 기준의 원본 모델 점수. Terminal-Bench 4.0은 Claude Code 하네스, 실행 환경을 묶어 시험하는 도구인 DeepSWE v1.1은 Mini-SWE-V2 하네스.
| 벤치마크 | V4.1-Flash-1017 | 직전 V4.1-Flash |
|---|---|---|
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
개발 작업 관점에서 Terminal-Bench 4.0의 개선은 Claude Code 환경에서의 활용을, DeepSWE v1.1의 개선은 Mini-SWE-V2 기반 개발 흐름을 검토할 근거다. 프로그램 작성 후보를 고를 때는 ProgramBench를, 자연어 기반 저장소 작업의 후보를 고를 때는 NL2Repo-Bench를 참고할 수 있다. 다만 이 표는 원본 모델의 결과이므로, 1비트에서도 같은 작업 점수가 유지된다는 뜻은 아니다.
왜 이런 차이가 나나
모델은 핵심 신경망인 552B 백본과 별도의 196B 파라미터 Engram 테이블로 구성되며, 실제 계산에 참여하는 활성 파라미터는 약 16B다. Engram은 최근 토큰 4개까지 조합해 표 몇 행만 읽는 조건부 메모리다. 그래서 110.6–202.8GB짜리 테이블을 SSD에 두고 필요한 행만 OS 캐시로 올리는 SSD 오프로드, 데이터를 디스크에 옮겨 두는 방식이 가능하다. RAM과 VRAM은 아낄 수 있지만 디스크 사용량은 그대로다.
양자화 단계마다 MoE, 활성 파라미터만 계산하는 혼합 전문가 구조의 가중치와 나머지 가중치를 다르게 다룬다. DeepSeek 원본은 MXFP4와 FP8, BF16을 섞고, Unsloth의 4비트와 8비트 단계는 MXFP4 엑스퍼트와 같은 Engram 테이블을 유지한다. 4비트는 비-엑스퍼트 가중치 다수를 Q8_0으로, 8비트는 BF16으로 둬서 단계 이름이 모든 텐서 정밀도를 말해주지 않는다. Unsloth Dynamic 3.0은 보정 데이터로만 후처리 양자화를 한다고 문서에 적혀 있다.
속도는 DSpark, 여러 토큰을 먼저 제안하고 본 모델이 검증하는 가속 디코딩으로 오른다. DSpark는 Engram과 별개 기능이라 메모리 절약과 디코딩 가속을 동시에 노리는 조합이다. DSpark 지원 구성에서 디코딩은 Unsloth 설명상 약 1.3~1.5배 빨라지고 드래프터 모듈, 초안 답변을 먼저 만드는 보조 모델은 Q8_0 8GB와 BF16 8.5GB가 준비돼 있다. Unsloth는 llama.cpp 기반 구성이 다른 CPU·VRAM·n-gram 저장소보다 약 3배 빠르다고 밝혔다.
DSpark는 버전이 맞는 V4.1-1017 드래프터와 DSpark 지원 런타임, 드래프터 추가 메모리를 확보했을 때 고르는 선택 단계다.
고를 때 기준
Unsloth 추정치 기준으로 128GB급 메모리 기기라면 1비트 UD-IQ1_S가 첫 선택지이고, Unsloth는 이 구성이 Macbook, DGX Spark, RTX Spark 같은 기기에서 동작한다고 안내한다. 256GB급이면 3비트 UD-IQ3_XXS를 선택할 수 있고, 4비트 UD-Q4_K_XL은 두 데이터셋에서 높은 일치율을 보여준다.
디스크를 아끼려면 Engram 정밀도를 낮추는 방법이 있다. IQ4_NL, Q5_K, Q6_K, MXFP8 네 가지가 110.6GB에서 202.8GB까지 별도 파일로 올라와 있고, 1비트 단계의 IQ4_NL 테이블만 MXFP8로 바꾸는 것도 되지만 테이블이 92.2GB 커지는 선택이다.
직접 빌드하려면 Unsloth의 llama.cpp PR이 필요하다.
추론 강도는 기본값이 75다. 다음은 Unsloth 문서에서 실행 명령에 덧붙이는 옵션 예시다.
--chat-template-kwargs '{"reasoning_effort":75}'가중치와 모델 카드는 MIT 라이선스로 배포된다.
메모리와 파일 크기를 우선하면 1비트, 원본 예측 보존을 우선하면 4비트 구성을 검토하고 Unsloth Chat이나 모델 허브에서 기기에 맞는 파일을 골라 Engram을 SSD에 둘 수 있다.