本地模型运行器 TensorSharp 新增对 DeepSeek 最新模型的支持,并将 GPU 间的数据交换改为以 GPU 为中心。使用多个 GPU 提供本地模型服务的开发者,可以不再按完整层拆分,而选择让多个 GPU 共同计算所选专家运算,即根据输入选择使用的计算部分。
一览
2026 年 10 月 23 日发布的版本支持 unsloth 的 DeepSeek-V4.1-Flash-1017 GGUF(模型权重文件格式)。
默认使用 1 张 GPU,张量并行(TP)使用 2–8 张。
YOCO 是一种跳过部分输入处理、重新计算末尾部分的近似方式,本版本默认启用。
性能:张量并行转入 GPU 内部
此前的 TP 由 CPU 逐层同步 GPU 任务。现在,默认的 ggml_cuda 路径由 GPU 负责执行和收集结果,消除了层内的 CPU 等待。传输经由页锁定主机内存,因此也能在不支持 GPU 间直接通信(P2P)的 PCIe 主机上运行。
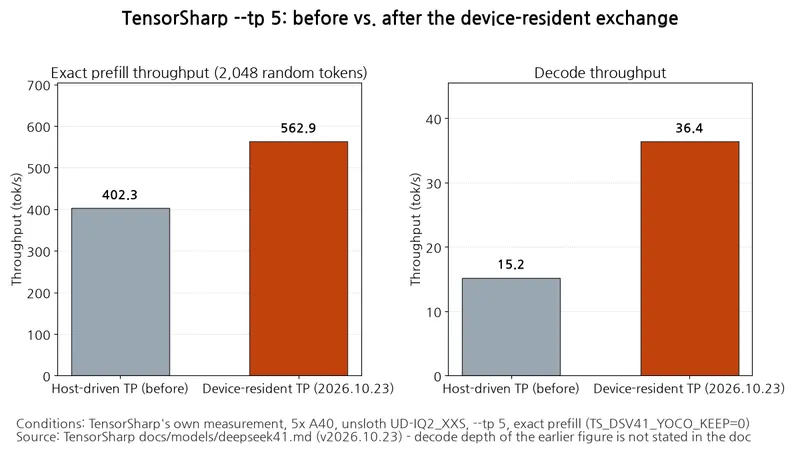
预填充是输入处理阶段,解码是生成下一个 token 的阶段。--tp 5 在改为 GPU 驻留前后,精确预填充提升约 1.40 倍,解码提升约 2.39 倍,这与部署方式之间的比较不同。
条件:TensorSharp 自测,5× A40·unsloth UD-IQ2_XXS·--tp 5。精确预填充以 2,048 个随机 token 为基准。
单位:tok/s
| 测量项 | 之前 | 之后 |
|---|---|---|
| 精确预填充 | 402.3 | 562.9 |
| 解码 | 15.2 | 36.4 |
条件:TensorSharp 自测,5× A40·UD-IQ2_XXS·ggml_cuda,随机 token,取 3 次中的最佳值。输入长度与上下文深度为 2,048 个 token。默认预填充使用 YOCO 近似计算,精确预填充设置 TS_DSV41_YOCO_KEEP=0。
单位:tok/s
| 测量项 | --tp 5 | --layer-split 5 |
|---|---|---|
| 默认预填充 | 1,046.7 | 844.3 |
| 精确预填充 | 562.9 | 463.5 |
| 合成解码 | 36.4 | 34.5 |
TP 的主要收益集中在输入处理。在上述文档的解码性能分析中,密集投影运算(将输入向量转换为另一种表示的计算)占 GPU 内核时间的 31%,由 TP 拆分的专家运算在 5 张 GPU 上合计占 21%。注意力、共享专家和输出头(计算下一个 token 候选得分的部分)在每层仍留在单张 GPU 上。TP 不支持注意力拆分或多节点 TP。
YOCO 有限重计算成为默认设置
DeepInfer 的 YOCO利用从第 20 层起共享的压缩缓存,在这些层中仅重新计算预填充调用的最后 140 个位置。图像调用、推测验证和 1 个 token 的微批次不会缩减。
同一原文的质量测量采用依次输入正确 token 的评估方式。在 TensorSharp 自测的 wikitext-2 评估中,以 10 个区段为基准,对 4,608 个 token 窗口的前 2,304 个 token 进行预填充,其余逐 token 评分。层拆分的困惑度(预测难度)从精确预填充的 2.4820 升至 YOCO 的 2.4970,上升 0.6%。
衡量相对 llama.cpp 输出分布差异的平均 KL 散度从 0.0160 增至 0.0172。前 128 个 token 中,精确预填充为 0.015,YOCO 为 0.026,但 512 个 token 之后均为 0.016。相比平均差异,提示词之后初始阶段的影响更明显。YOCO 的质量应与精确预填充比较后判断。
存储空间与内存需求
条件:unsloth 官方指南硬件需求表中的估计值。使用 RAM·VRAM 或统一内存,Engram(模型用于查找并读取所需信息的独立查找表)置于 SSD。数值基于非 Engram 权重预留约 5–10 GB 余量,运行时和上下文还可能需要额外内存。
单位:GB
| 量化 | 预估需求 |
|---|---|
| 1-bit | 128–145 |
| 2-bit | 176–205 |
| 3-bit | 256–290 |
| 4-bit | 305 |
| 8-bit | 315 |
TensorSharp 上述 5× A40 实测配置的内存条件与这张 SSD 部署估算表不同。Engram 映射到主机内存,主机或容器的内存限额必须能够容纳该表。
缓存改进与应用设置
还新增了在每张 GPU 上复制键值缓存的 KV 镜像。在 TensorSharp 自测的层拆分配置中,5× A40·2K 上下文的解码速度从 32.6 升至 34.5 tok/s。转换为概率前的模型输出分数,即 logits,逐比特一致。
DSpark 是先生成预测 token,再由目标模型批量验证的推测解码方式。在 V4.1 中仍处于实验阶段。
YOCO 默认启用适用于 V4.1 的 ggml_cuda·ggml_cpu 后端。
下载发行资产和 unsloth 权重,并核对文档中的版本与 SHA-256。将服务器示例中的 --layer-split 5 改为 --tp 5 即可选择 TP。切换为精确预填充的环境变量如下。
TS_DSV41_YOCO_KEEP=0根据这次测量,使用多个 GPU 提供 1017 服务时,选择 TP 的主要理由是输入吞吐量,而非解码。