Unslothは2026年10月19日のリリースで、DeepSeek-V4.1-Flash-1017に動的量子化を適用したGGUFファイルとローカル実行ガイドを公開した。開発者はEngramテーブルをSSDに置けば、1ビット構成をUnslothの推定で128–145GBのメモリを持つ機器で実行でき、APIの代わりにローカル実行を選ぶ余地が広がった。
量子化の評価と結果
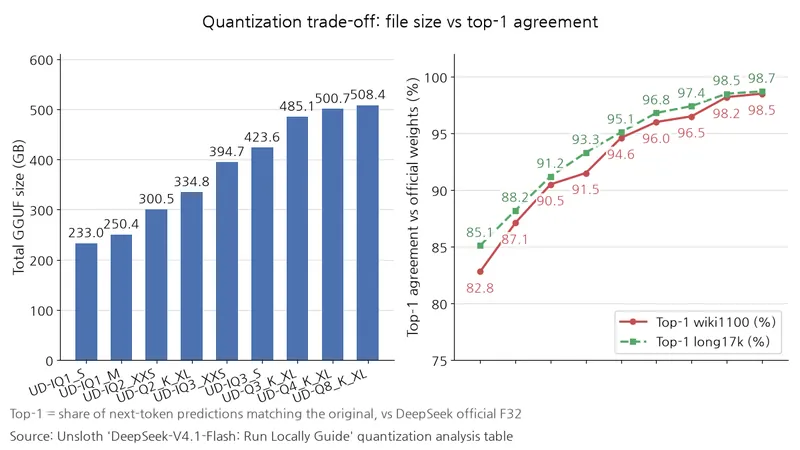
現在、モデルハブには9種類の量子化が掲載されている。量子化は数値精度を調整して容量を減らす処理で、GGUFはモデルの重みを格納するファイル形式だ。Unslothは各ファイルをDeepSeek公式のF32(32ビット浮動小数点)重みと比較した。wiki1100とlong17kデータセットで、確率分布の差を示すKLと、次のトークンの予測が元モデルと一致する割合であるtop-1一致率を測定した。
表:量子化別のファイルサイズとtop-1一致率
条件:Unsloth Dynamic GGUFとDeepSeek公式F32重みの比較。top-1は次のトークンの予測が元モデルと一致した割合、非Engram重みはEngramテーブルを除く重みのサイズであり、必要メモリの絶対的な最小値。
単位:合計サイズ・非Engram重みはGB、top-1一致率は%
| 量子化 | 合計サイズ | top-1 wiki1100 | top-1 long17k | 非Engram重み |
|---|---|---|---|---|
| UD-IQ1_S | 233.0 | 82.8 | 85.1 | 122.4 |
| UD-IQ1_M | 250.4 | 87.1 | 88.2 | 139.8 |
| UD-IQ2_XXS | 300.5 | 90.5 | 91.2 | 165.3 |
| UD-Q2_K_XL | 334.8 | 91.5 | 93.3 | 199.6 |
| UD-IQ3_XXS | 394.7 | 94.6 | 95.1 | 233.5 |
| UD-IQ3_S | 423.6 | 96.0 | 96.8 | 262.3 |
| UD-Q3_K_XL | 485.1 | 96.5 | 97.4 | 282.3 |
| UD-Q4_K_XL | 500.7 | 98.2 | 98.5 | 297.9 |
| UD-Q8_K_XL | 508.4 | 98.5 | 98.7 | 305.6 |
1ビットのIQ1_Sは、Unslothがロスレスと分類するUD-Q8_K_XLより約54%小さい。IQ1_Mは17.4GBを追加するだけで、wiki1100で4.3%p、long17kで3.1%pを取り戻す。4ビットのQ4_K_XLは同じUD-Q8_K_XLより7.7GB小さく、一致率の差はwiki1100で0.3%p、long17kで0.2%pにとどまる。
必要メモリ量
1ビットのUD-IQ1_Sのダウンロードサイズは233.0GBで、このうちSSDに置くEngramテーブルは110.6GBだ。
表:量子化のビット段階別の必要メモリ推定値
条件:Unslothの文書にあるビット段階別の推定値で、RAM+VRAMまたはユニファイドメモリが基準となり、EngramはSSDに保持する。非Engram重みより約5~10GB多く見積もった値のため、コンテキストやランタイムによってはさらに必要になる。
単位:GB
| ビット段階 | Unsloth推定の必要メモリ |
|---|---|
| 1ビット | 128–145 |
| 2ビット | 176–205 |
| 3ビット | 256–290 |
| 4ビット | 305 |
| 8ビット | 315 |
ビット数が増えるほど必要メモリは急増する。ビット段階別の推定値はファイルごとの最小値ではなく、ビット段階の表記だ。そのためIQ1_Mのように非Engram重みが大きいファイルには、1ビットの下限は適用されない。
公式ベンチマーク
表:DeepSeek公式ベンチマークのスコア比較
条件:DeepSeek公式モデルカードに基づく元モデルのスコア。Terminal-Bench 4.0はClaude Codeハーネスを使用する。実行環境をまとめてテストするツールであるDeepSWE v1.1は、Mini-SWE-V2ハーネスを使用する。
| ベンチマーク | V4.1-Flash-1017 | 直前のV4.1-Flash |
|---|---|---|
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
開発作業の観点では、Terminal-Bench 4.0の改善はClaude Code環境での活用を、DeepSWE v1.1の改善はMini-SWE-V2ベースの開発フローを検討する根拠となる。プログラム作成の候補を選ぶ際はProgramBenchを、自然言語によるリポジトリ作業の候補を選ぶ際はNL2Repo-Benchを参照できる。ただし、この表は元モデルの結果であり、1ビットでも同じ作業スコアが維持されるという意味ではない。
なぜこのような差が生じるのか
モデルは中核のニューラルネットワークである552Bのバックボーンと、別個の196BパラメータのEngramテーブルで構成され、実際の計算に参加するアクティブパラメータは約16Bだ。Engramは直近のトークンを4個まで組み合わせ、表の数行だけを読む条件付きメモリだ。このため110.6–202.8GBのテーブルをSSDに置き、必要な行だけをOSキャッシュに読み込むSSDオフロードが可能となる。これはデータをディスクに移しておく方式だ。RAMとVRAMは節約できるが、ディスク使用量は変わらない。
量子化の各段階では、アクティブパラメータだけを計算する混合エキスパート構造のMoEの重みと、それ以外の重みを別々に扱う。DeepSeekの元モデルはMXFP4とFP8、BF16を混用し、Unslothの4ビットと8ビット段階はMXFP4エキスパートと同じEngramテーブルを保持する。4ビットでは非エキスパート重みの多くをQ8_0に、8ビットではBF16にするため、段階名が全テンソルの精度を示すわけではない。文書にはUnsloth Dynamic 3.0は較正データだけで事後量子化を行うと記されている。
速度は、複数のトークンを先に提案して本体モデルが検証する高速デコーディングのDSparkで向上する。DSparkはEngramとは別の機能で、メモリ節約とデコーディング高速化を同時に狙う組み合わせだ。Unslothの説明では、DSpark対応構成でデコーディングが約1.3~1.5倍速くなる。回答の草案を先に作る補助モデルであるドラフターモジュールは、Q8_0の8GBとBF16の8.5GBが用意されている。Unslothは、llama.cppベースの構成がほかのCPU・VRAM・n-gramストレージより約3倍速いと述べた。
DSparkは、バージョンの合うV4.1-1017ドラフターとDSpark対応ランタイム、ドラフター用の追加メモリを確保した場合に選ぶ任意の段階だ。
選ぶ際の基準
Unslothの推定値を基準にすると、128GB級メモリの機器では1ビットのUD-IQ1_Sが最初の選択肢となる。Unslothは、この構成がMacbook、DGX Spark、RTX Sparkなどの機器で動作すると案内している。256GB級なら3ビットのUD-IQ3_XXSを選べ、4ビットのUD-Q4_K_XLは両データセットで高い一致率を示す。
ディスクを節約するにはEngramの精度を下げる方法がある。IQ4_NL、Q5_K、Q6_K、MXFP8の4種類が110.6GBから202.8GBの個別ファイルとして公開されている。1ビット段階のIQ4_NLテーブルだけをMXFP8に替えることもできるが、テーブルが92.2GB大きくなる選択だ。
自分でビルドするにはUnslothのllama.cpp PRが必要だ。
推論の強度のデフォルト値は75だ。以下はUnslothの文書にある、実行コマンドに付け加えるオプションの例だ。
--chat-template-kwargs '{"reasoning_effort":75}'重みとモデルカードはMITライセンスで配布される。
メモリとファイルサイズを優先するなら1ビット、元モデルの予測保持を優先するなら4ビット構成を検討し、Unsloth Chatやモデルハブで機器に合うファイルを選んでEngramをSSDに置ける。