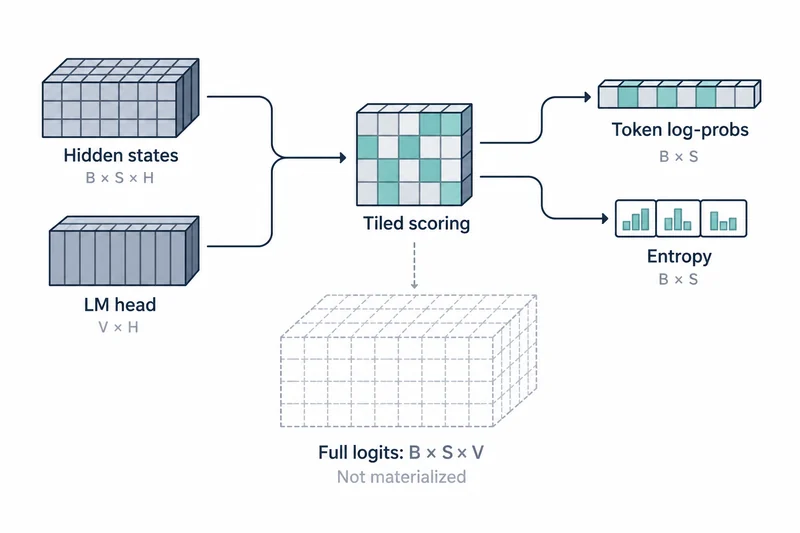
TRL v1.15.0 于 10 月 8 日发布。SFT、DPO、KTO、GRPO、RLOO 和 Distillation 现在都用融合(fused)LM head 计算 token 分数,这一路径默认开启。
Triton 内核把隐藏状态按块通过 LM head,并直接归约为每个 token 的对数概率和熵。因此不会生成 [batch, seq, vocab] 大小的 logits 张量。
计算分数需要 GPU 上的 Triton,发布说明列出的适用环境是使用 CUDA、ROCm 或 XPU 的 Linux。
logits 张量如何占用内存
完整 logits 张量与模型大小无关,而是随打分的 token 位置数和词表大小成比例增长。词表越大、序列越长,这个中间张量越容易成为内存瓶颈。
如果训练只需要每个 token 的归约统计,就可以跳过这个张量。这样不必缩小模型,也能放进更长的样本。
不过,能放进更长的样本,与更快地处理同样的数据是两回事。
注意事项:项目测量的条件
发布说明称,DPO 的最大训练长度从 10,240 增加到 59,392,提高 5.80 倍。KTO 提高 6.89 倍,只算打分的 GRPO 和 RLOO 分别提高 4.00 倍和 4.26 倍。
测量使用随机权重的 gemma-3-1b、262k 词表、bf16、批大小 1、梯度检查点和 sdpa,并把 B300 的分配器限制在 79GiB 以模拟 H100 80GB。没有测量真实的 H100、flash-attention、真实生成和多 GPU。
在 8,192 token 下,峰值内存降低 52~82%,但每步速度只提升 2.3~10.9%。默认的 SFT 损失(chunked_nll)原本就避开了完整 logits,所以最大长度没有变化。
与其他省内存技术的区别
根据固定版本的 TRL 内存指南,梯度检查点不保存中间激活值,而在反向传播时重新计算,并且在所有训练器中默认开启。
激活值卸载把激活值移到 CPU 内存以降低峰值内存,代价是训练时间略有增加。截断会丢弃超出长度限制的 token,这些 token 不会参与训练。
这几种技术各自付出不同的代价,而融合 LM head 是不去生成不需要的输出张量。
升级时会失效的设置
GRPO、RLOO、DPO 和 KTO 中的完整 logits 打分路径已被移除。挂在 lm_head 上的 PEFT 适配器现在会报错,替代做法是使用 modules_to_save=["lm_head"]。
在这四个训练器中,use_liger_kernel=True 已被弃用,并将在 v2.0.0 中移除。DPO 和 KTO 的 compute_metrics 与 compute_loss(..., return_outputs=True) 仍会通过额外的前向传播拿到完整 logits,但这条路径也计划在 v2.0.0 中移除。
从当前损失路径出发的评估
如果现有设置原本就避开了完整 logits,这次变化可能不会消除任何瓶颈。反之,如果原来会生成完整张量,在相同样本和批设置下比较峰值内存和每步时间,就能看出差别。
如果同时更改上下文长度和其他优化,一旦出现回退就很难判断原因。
TRL v1.15.0 的融合 LM head 能让原本生成完整 logits 的设置大幅突破内存上限,但原本就避开该张量的设置不会得到同样的倍数。