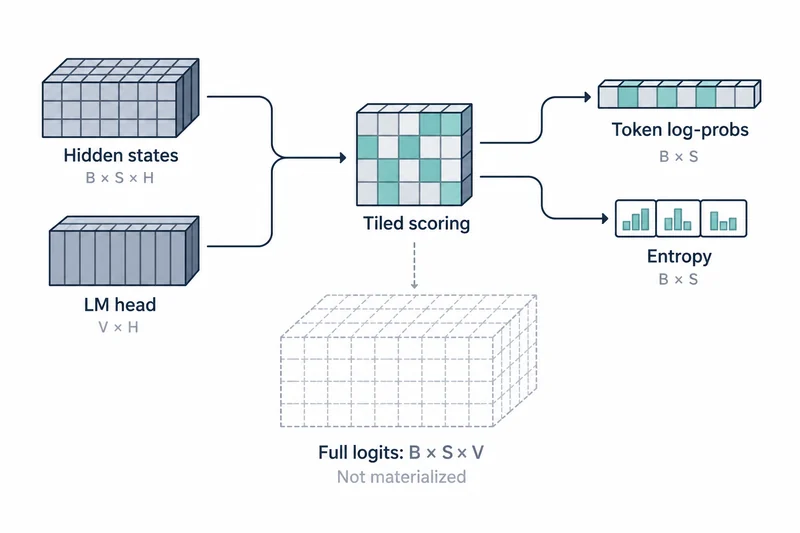
TRL v1.15.0이 10월 8일 나왔다. SFT, DPO, KTO, GRPO, RLOO, Distillation이 이제 융합(fused) LM head로 토큰 점수를 계산하며, 이 경로는 기본으로 켜져 있다.
Triton 커널이 은닉 상태를 LM head에 타일 단위로 통과시키고, 곧바로 토큰별 로그 확률과 엔트로피로 줄인다. 그래서 [batch, seq, vocab] 크기의 logits 텐서를 만들지 않는다.
점수 계산에는 GPU의 Triton이 필요하며, 릴리스 노트가 밝힌 대상은 CUDA·ROCm·XPU를 쓰는 Linux다.
logits 텐서가 메모리를 차지하는 방식
전체 logits 텐서는 모델 크기와 별개로 점수를 매기는 토큰 위치 수와 어휘 크기에 비례해 커진다. 어휘가 크고 시퀀스가 길수록 이 중간 텐서가 메모리 병목이 되기 쉽다.
학습에 필요한 것이 토큰별 축약 통계라면 이 텐서를 건너뛰어도 된다. 그만큼 모델을 줄이지 않고 더 긴 예제를 넣을 여지가 생긴다.
다만 더 긴 예제가 들어간다는 것과 같은 데이터를 더 빨리 처리한다는 것은 다른 이야기다.
주의할 점: 프로젝트 측정의 조건
릴리스 노트는 DPO의 최대 학습 길이가 10,240에서 59,392로 5.80배 늘었다고 보고한다. KTO는 6.89배, GRPO와 RLOO의 점수 계산만 따진 경우는 4.00배와 4.26배였다.
측정은 무작위 가중치의 gemma-3-1b, 262k 어휘, bf16, 배치 크기 1, 그래디언트 체크포인팅, sdpa로 했고, B300의 할당기를 79GiB로 제한해 H100 80GB를 흉내 냈다. 실제 H100, flash-attention, 실제 생성, 다중 GPU는 측정하지 않았다.
8,192토큰에서 최대 메모리는 52~82% 줄었지만 스텝 속도 향상은 2.3~10.9%였다. 기본 SFT 손실(chunked_nll)은 이미 전체 logits를 피하고 있어 최대 길이가 그대로였다.
다른 메모리 절약 기법과의 차이
버전을 고정한 TRL 메모리 안내서에 따르면, 그래디언트 체크포인팅은 중간 활성값을 저장하지 않고 역전파 때 다시 계산하며 모든 트레이너에서 기본으로 켜져 있다.
활성값 오프로딩은 활성값을 CPU RAM으로 옮겨 최대 메모리를 줄이는 대신 학습 시간이 조금 늘어난다. 잘라내기(truncation)는 길이 제한을 넘는 토큰을 버려, 그 토큰이 학습에 쓰이지 않는다.
세 기법은 각각 다른 비용을 치르고, 융합 LM head는 필요 없는 출력 텐서를 만들지 않는 쪽이다.
업그레이드 때 깨지는 설정
GRPO, RLOO, DPO, KTO에서는 전체 logits 점수 경로가 사라졌다. lm_head에 붙인 PEFT 어댑터는 이제 오류를 내며, 대신 modules_to_save=["lm_head"]를 써야 한다.
같은 네 트레이너에서 use_liger_kernel=True는 폐기 예정이며 v2.0.0에서 제거된다. DPO와 KTO의 compute_metrics와 compute_loss(..., return_outputs=True)는 추가 순전파로 여전히 전체 logits를 받지만, 이 경로도 v2.0.0에서 제거될 예정이다.
현재 손실 경로에서 시작하는 평가
기존 설정이 이미 전체 logits를 피하고 있었다면 이번 변경으로 병목이 사라지지 않을 수 있다. 반대로 전체 텐서를 만들고 있었다면 같은 예제와 배치 조건에서 최대 메모리와 스텝 시간을 비교하면 변화가 드러난다.
컨텍스트 확장이나 다른 최적화를 한꺼번에 바꾸면 회귀가 생겼을 때 원인을 가리기 어렵다.
TRL v1.15.0의 융합 LM head는 전체 logits를 만들던 설정에서 메모리 한계를 크게 밀어내지만, 이미 그 텐서를 피하던 설정에는 같은 배수가 나오지 않는다.