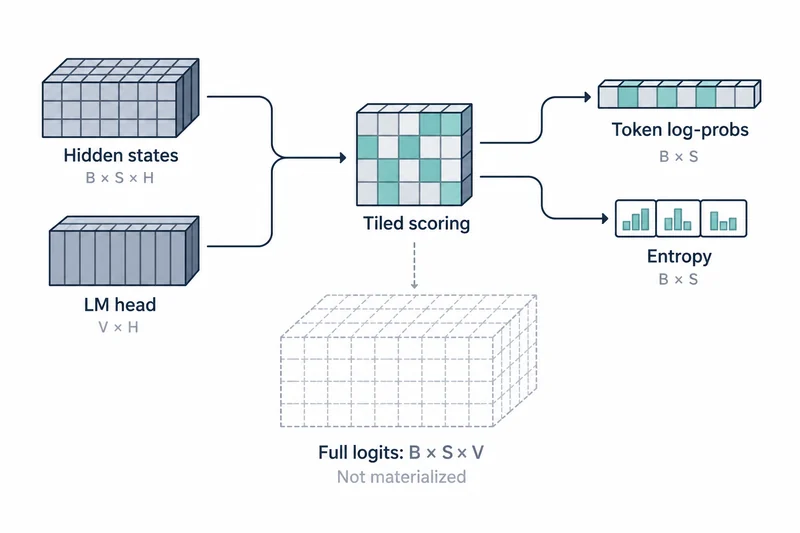
TRL v1.15.0が10月8日に公開された。SFT、DPO、KTO、GRPO、RLOO、Distillationは、融合(fused)LM headでトークンのスコアを計算するようになり、この経路は既定で有効だ。
Tritonカーネルが隠れ状態をタイル単位でLM headに通し、そのままトークンごとの対数確率とエントロピーにまとめる。そのため[batch, seq, vocab]の大きさのlogitsテンソルは作られない。
スコア計算にはGPU上のTritonが必要で、リリースノートが挙げる対象はCUDA・ROCm・XPUを使うLinuxだ。
logitsテンソルがメモリを占める仕組み
完全なlogitsテンソルは、モデルの大きさとは別に、スコアを付けるトークン位置の数と語彙の大きさに比例して大きくなる。語彙が大きくシーケンスが長いほど、この中間テンソルがメモリのボトルネックになりやすい。
学習に必要なのがトークンごとの集約統計なら、このテンソルは省ける。そのぶん、モデルを小さくせずに長い例を入れる余地が生まれる。
ただし、長い例が入ることと、同じデータを速く処理できることは別の話だ。
注意点:プロジェクトの測定条件
リリースノートは、DPOの最大学習長が10,240から59,392へ5.80倍に伸びたと報告している。KTOは6.89倍、スコア計算だけのGRPOとRLOOは4.00倍と4.26倍だった。
測定には、ランダムな重みのgemma-3-1b、262kの語彙、bf16、バッチサイズ1、勾配チェックポイント、sdpaを使い、B300のアロケーターを79GiBに制限してH100 80GBを模した。実際のH100、flash-attention、実際の生成、複数GPUは測っていない。
8,192トークンではピークメモリが52〜82%減ったが、ステップの速度向上は2.3〜10.9%だった。既定のSFT損失(chunked_nll)はもともと完全なlogitsを避けていたため、最大長は変わらなかった。
他のメモリ削減手法との違い
バージョンを固定したTRLのメモリガイドによると、勾配チェックポイントは中間の活性値を保存せず逆伝播で再計算するもので、すべてのトレーナーで既定で有効だ。
活性値のオフロードは活性値をCPUのRAMへ移してピークメモリを下げる代わりに、学習時間が少し延びる。切り詰め(truncation)は長さの上限を超えるトークンを捨て、そのトークンは学習に使われない。
これらはそれぞれ別のコストを払う手法で、融合LM headは不要な出力テンソルを作らない側の手法だ。
アップグレードで壊れる設定
GRPO、RLOO、DPO、KTOでは完全なlogitsによるスコア計算の経路がなくなった。lm_headに付けたPEFTアダプターはエラーになり、代わりにmodules_to_save=["lm_head"]を使う。
同じ4つのトレーナーでuse_liger_kernel=Trueは非推奨になり、v2.0.0で削除される。DPOとKTOのcompute_metricsとcompute_loss(..., return_outputs=True)は追加の順伝播で引き続き完全なlogitsを受け取るが、この経路もv2.0.0で削除される予定だ。
現在の損失経路から始める評価
既存の設定がもともと完全なlogitsを避けていたなら、今回の変更でボトルネックはなくならないかもしれない。逆に完全なテンソルを作っていたなら、同じ例とバッチ条件でピークメモリとステップ時間を比べれば違いが表れる。
コンテキストの拡張や他の最適化を一度に変えると、退行が起きたときに原因を見分けにくい。
TRL v1.15.0の融合LM headは、完全なlogitsを作っていた設定ではメモリの限界を大きく押し広げるが、もともとそのテンソルを避けていた設定には同じ倍率は出ない。