ローカルモデル実行ツールTensorSharpがDeepSeekの最新モデルへの対応を追加し、GPU間のデータ交換をGPU主導に変更した。複数GPUでローカルモデルを提供する開発者は、レイヤーを丸ごと分割する代わりに、選択されたエキスパート演算、つまり入力に応じて選ぶ計算部分をGPUが共同で計算する配置を選べる。
概要
2026年10月23日にリリースされたバージョンは、unslothのDeepSeek-V4.1-Flash-1017にGGUF(モデルの重みファイル形式)で対応する。
デフォルトはGPU 1枚で、テンソル並列化(TP)は2–8枚を使う。
YOCOは入力処理の一部を省略して末尾を再計算する近似方式で、今回のバージョンではデフォルトで有効になる。
性能:テンソル並列化がGPU内に移った
従来のTPはCPUがレイヤーごとにGPUの処理を同期していた。標準のggml_cuda経路ではGPUが実行と結果の集約を担い、レイヤー内部のCPU待機をなくした。転送はページ固定ホストメモリを経由し、GPU間の直接通信(P2P)ができないPCIeホストでも動作する。
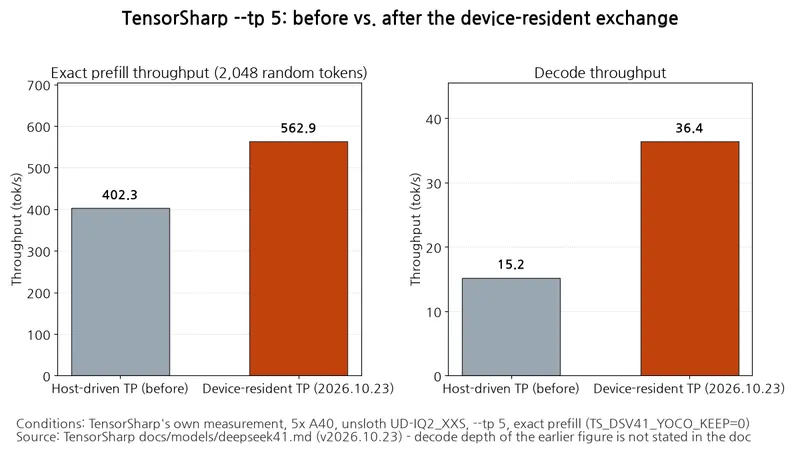
プリフィルは入力処理、デコードは次のトークンを生成する段階だ。--tp 5のGPU常駐化前後の改善は、正確なプリフィルで約1.40倍、デコードで約2.39倍であり、配置方式間の比較とは別だ。
条件:TensorSharpの独自実測、5× A40・unsloth UD-IQ2_XXS・--tp 5。正確なプリフィルは2,048ランダムトークン基準。
単位:tok/s
| 測定 | 変更前 | 変更後 |
|---|---|---|
| 正確なプリフィル | 402.3 | 562.9 |
| デコード | 15.2 | 36.4 |
条件:TensorSharpの独自実測、5× A40・UD-IQ2_XXS・ggml_cuda、ランダムトークン、3回中の最良値。入力・コンテキスト深度は2,048トークン。標準プリフィルはYOCO近似計算、正確なプリフィルはTS_DSV41_YOCO_KEEP=0。
単位:tok/s
| 測定 | --tp 5 | --layer-split 5 |
|---|---|---|
| 標準プリフィル | 1,046.7 | 844.3 |
| 正確なプリフィル | 562.9 | 463.5 |
| 合成デコード | 36.4 | 34.5 |
TPの大きな利点は入力処理に集中した。上記文書のデコードプロファイルでは、密な射影演算(入力ベクトルを別の表現に変換する計算)がGPUカーネル時間の31%、TPで分割するエキスパート演算がGPU 5枚の合計で21%だった。アテンション・共有エキスパート・出力ヘッド(次のトークン候補のスコアを計算する部分)はレイヤーごとに1つのGPUに残る。TPはアテンション分割・マルチノードTPに対応しない。
YOCOの限定再計算がデフォルトになった
DeepInferのYOCOはレイヤー20から共有する圧縮キャッシュを利用し、これらのレイヤーではプリフィル呼び出しの最後の140位置だけを再計算する。画像呼び出し・投機的検証・1トークンのマイクロバッチは削減しない。
同じ原文の品質測定は、正解トークンを順に入力する評価だ。TensorSharp独自のwikitext-2評価では、4,608トークンの窓の先頭2,304トークンをプリフィルし、残りを1トークンずつ採点した10区間を基準に、レイヤー分割のパープレキシティ(予測の難度)が正確なプリフィルの2.4820からYOCOの2.4970へ0.6%上昇した。
llama.cppに対する出力分布の差である平均KLダイバージェンスは0.0160から0.0172に拡大した。最初の128トークンは正確なプリフィルが0.015、YOCOが0.026だが、512トークン以降はどちらも0.016だった。平均の差よりもプロンプト直後の影響が目立つ結果だ。YOCOの品質は正確なプリフィルと比較して判断する必要がある。
ストレージとメモリの要件
条件:unsloth公式ガイドのハードウェア要件表に記載された推定値。RAM・VRAMまたは統合メモリを使い、Engram(必要な情報を検索して読み出すモデルの別個の参照テーブル)はSSDに置く。Engram以外の重みを基準に約5–10 GBの余裕を見込んだ値で、ランタイムとコンテキストによって追加メモリが必要になる。
単位:GB
| 量子化 | 推定必要量 |
|---|---|
| 1-bit | 128–145 |
| 2-bit | 176–205 |
| 3-bit | 256–290 |
| 4-bit | 305 |
| 8-bit | 315 |
TensorSharpの上記5× A40実測構成は、このSSD配置の推定表とはメモリ条件が異なる。Engramをホストメモリにマッピングするため、ホストまたはコンテナのメモリ上限がテーブルを収容できる必要がある。
キャッシュの改善と適用設定
GPUごとにキー・バリューキャッシュを複製するKVミラーも追加された。TensorSharp独自のレイヤー分割測定では、5× A40・2Kコンテキストのデコードが32.6から34.5 tok/sに向上した。確率に変換する前のモデル出力スコアであるロジットはビット単位で一致した。
DSparkは予想トークンを先に生成し、対象モデルでまとめて検証する投機的デコーディングだ。V4.1では実験段階にある。
YOCOのデフォルト有効化はV4.1のggml_cuda・ggml_cpuバックエンドに適用される。
リリースアセットとunslothの重みを入手し、文書のバージョン・SHA-256を確認する。サーバー例の--layer-split 5を--tp 5に変更するとTPを選択できる。正確なプリフィルに切り替える環境変数は次のとおりだ。
TS_DSV41_YOCO_KEEP=0この測定では、複数GPUで1017を提供する際にTPを選ぶ主な理由は、デコードよりも入力処理量にある。