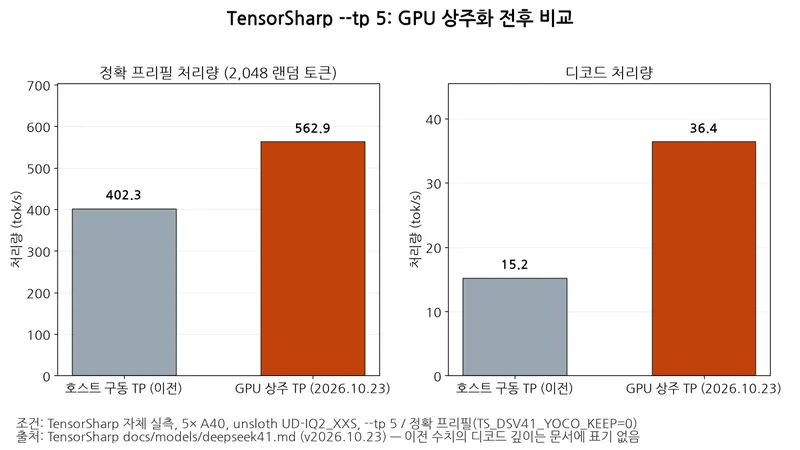
로컬 모델 실행기 TensorSharp가 DeepSeek 최신 모델 지원을 추가하고, GPU 사이의 데이터 교환을 GPU 중심으로 바꿨다. 여러 GPU로 로컬 모델을 서비스하는 개발자는 레이어를 통째로 나누는 대신, 선택된 전문가 연산, 즉 입력에 따라 골라 쓰는 계산 부분을 GPU들이 함께 계산하는 배치를 선택할 수 있다.
한눈에 보기
2026년 10월 23일 출시된 버전은 unsloth의 DeepSeek-V4.1-Flash-1017을 GGUF(모델 가중치 파일 형식)로 지원한다.
기본은 GPU 1장이며, 텐서 병렬화(TP)는 2–8장을 쓴다.
YOCO는 입력 처리 일부를 생략하고 끝부분을 재계산하는 근사 방식으로, 이번 버전에서 기본으로 켜진다.
성능: 텐서 병렬화가 GPU 안으로 들어왔다
기존 TP는 CPU가 레이어마다 GPU 작업을 동기화했다. 기본 ggml_cuda 경로는 이제 GPU가 실행·결과 수집을 맡아 레이어 내부의 CPU 대기를 없앴다. 전송은 페이지 고정 호스트 메모리를 경유해 GPU 간 직접 통신(P2P)이 안 되는 PCIe 호스트에서도 돌아간다.
프리필은 입력 처리, 디코드는 다음 토큰 생성 단계다. --tp 5의 GPU 상주화 전후 개선은 정확 프리필 약 1.40배, 디코드 약 2.39배로, 배치 방식 간 비교와는 별개다.
조건: TensorSharp 자체 실측, 5× A40·unsloth UD-IQ2_XXS·--tp 5. 정확 프리필은 2,048 랜덤 토큰 기준.
단위: tok/s
| 측정 | 이전 | 이후 |
|---|---|---|
| 정확 프리필 | 402.3 | 562.9 |
| 디코드 | 15.2 | 36.4 |
조건: TensorSharp 자체 실측, 5× A40·UD-IQ2_XXS·ggml_cuda, 랜덤 토큰, 3회 중 최선값. 입력·문맥 깊이 2,048토큰. 기본 프리필은 YOCO 근사 계산, 정확 프리필은 TS_DSV41_YOCO_KEEP=0.
단위: tok/s
| 측정 | --tp 5 | --layer-split 5 |
|---|---|---|
| 기본 프리필 | 1,046.7 | 844.3 |
| 정확 프리필 | 562.9 | 463.5 |
| 합성 디코드 | 36.4 | 34.5 |
TP의 큰 이득은 입력 처리에 집중됐다. 위 문서의 디코드 프로파일에서 밀집 투영 연산(입력 벡터를 다른 표현으로 바꾸는 계산)은 GPU 커널 시간의 31%, TP로 분할하는 전문가 연산은 GPU 5장 합계로 21%였다. 어텐션·공유 전문가·출력 헤드(다음 토큰 후보의 점수를 계산하는 부분)는 레이어당 한 GPU에 남는다. TP는 어텐션 분할·멀티노드 TP를 지원하지 않는다.
YOCO 제한 재계산이 기본값이 됐다
DeepInfer의 YOCO는 레이어 20부터 공유하는 압축 캐시를 이용해, 이 레이어들에서 프리필 호출의 마지막 140개 위치만 다시 계산한다. 이미지 호출·추측 검증·1토큰 마이크로배치는 줄이지 않는다.
같은 원문의 품질 측정은 정답 토큰을 차례로 넣는 평가다. TensorSharp 자체 wikitext-2 평가에서 4,608토큰 창의 앞 2,304토큰을 프리필하고 나머지를 한 토큰씩 채점한 10개 구간 기준, 레이어 분할의 퍼플렉서티(예측 난도)는 정확 프리필 2.4820에서 YOCO 2.4970으로 0.6% 올랐다.
llama.cpp 대비 출력 분포 차이인 평균 KL 발산은 0.0160에서 0.0172로 커졌다. 첫 128토큰은 정확 프리필 0.015, YOCO 0.026이지만 512토큰 이후에는 모두 0.016이었다. 평균 차이보다 프롬프트 직후 영향이 두드러진 결과다. YOCO 품질은 정확 프리필과 비교해 판단해야 한다.
저장공간과 메모리 요구량
조건: unsloth 공식 가이드의 하드웨어 요구 표에 적힌 추정치. RAM·VRAM 또는 통합 메모리, Engram(필요한 정보를 찾아 읽는 모델의 별도 조회 테이블)은 SSD에 둔다. 비-Engram 가중치 기준 약 5–10 GB 여유를 잡은 값이며 런타임과 컨텍스트에 따라 추가 메모리가 필요하다.
단위: GB
| 양자화 | 추정 요구량 |
|---|---|
| 1-bit | 128–145 |
| 2-bit | 176–205 |
| 3-bit | 256–290 |
| 4-bit | 305 |
| 8-bit | 315 |
TensorSharp의 위 5× A40 실측 구성은 이 SSD 배치 추정표와 메모리 조건이 다르다. Engram을 호스트 메모리에 매핑하며, 호스트 또는 컨테이너의 메모리 한도가 테이블을 수용해야 한다.
캐시 개선과 적용 설정
GPU마다 키·값 캐시를 복제하는 KV 미러도 추가됐다. TensorSharp 자체 레이어 분할 측정에서 5× A40·2K 문맥의 디코드는 32.6에서 34.5 tok/s로 올랐다. 확률로 바꾸기 전 모델 출력 점수인 로짓은 비트 단위로 같았다.
DSpark는 예상 토큰을 먼저 생성한 뒤 대상 모델로 묶어 검증하는 추측 디코딩이다. V4.1에서는 실험 단계다.
YOCO 기본 활성화는 V4.1의 ggml_cuda·ggml_cpu 백엔드에 적용된다.
릴리스 자산과 unsloth 가중치를 받고 문서의 버전·SHA-256을 확인한다. 서버 예시의 --layer-split 5를 --tp 5로 바꾸면 TP를 선택한다. 정확 프리필 전환용 환경변수는 다음과 같다.
TS_DSV41_YOCO_KEEP=0이 측정에서 여러 GPU로 1017을 서비스할 때 TP를 선택할 주된 이유는 디코드보다 입력 처리량이다.