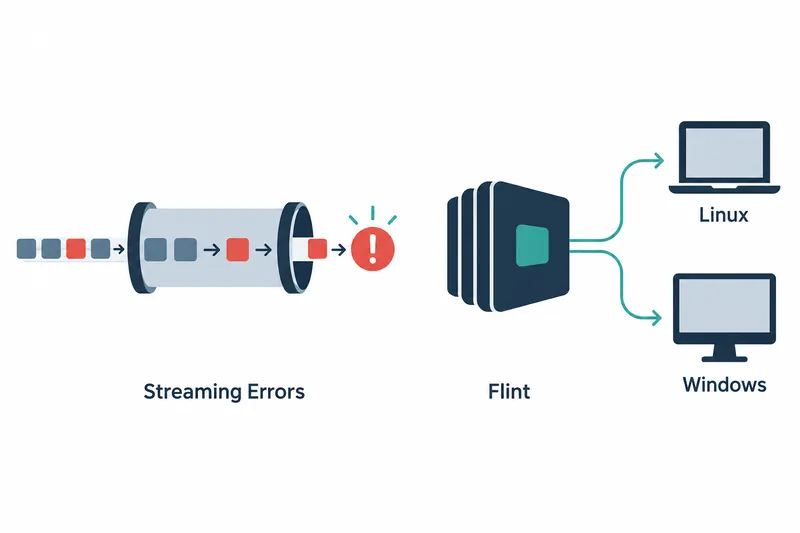
Ollama 改为在响应中报告发送回答期间发生的生成失败,并让 Flint 模型也能在 Linux 和 Windows 上运行。开发实时展示回答服务的开发者可以区分处理部分输出与完整回答,Flint 用户则有了更多运行环境选择。
1. 部分输出后的失败也会包含在响应中
发布说明指出,OpenAI Responses 和 Anthropic Messages 格式的流式请求在生成失败时,会报告失败,而不再是在输出部分内容后静默结束。此前,接收方可能仅凭已收到的内容将请求误判为正常响应,现在则可以在流末尾确认失败。
Anthropic 格式会将流式传输开始后的错误通过 error 事件传递。流式传输开始前发生的错误仍按原有方式,以包含错误信息的响应处理。
OpenAI Responses 则改为发送表示失败状态的 response.failed 事件。修改后的代码还会保留失败结束前已生成的部分输出。
	response := anthropic.NewError(w.Status(), errData.Error)
	if w.stream && w.Written() {
		if err := w.writeEvent("error", anthropic.StreamErrorEvent{Type: response.Type, Error: response.Error}); err != nil {
			return 0, err
		}
		return len(data), nil
	}
这段代码是完整变更记录中 Anthropic 处理逻辑的一部分。它会先检查是否已经开始写入响应,再发送错误事件。消费流式数据的程序不仅要展示正文片段,还需要解析最后的失败事件。
2. 向编程工具传递云端模型信息
ollama launch 已修改为向编程工具传递云端模型的上下文长度,即模型一次可参考的输入量,以及能力信息。发布说明称,这项变更修正了错误的上下文与压缩配置。压缩是缩减长对话内容以继续工作的处理方式,工具需要了解模型的输入上限,才能确定合适的压缩时机。
Claude Code 集成代码会将从模型信息中获取的上下文长度应用于配置,并在规定上限内调整自动压缩区间。如果用户已设置自动压缩区间,则保留该值。用户将云端模型连接到编程工具时,可以检查配置是否反映了各模型的输入上限。
3. Flint 的运行环境扩展至 Linux、Windows
Ollama 宣布,Flint 不仅能在 macOS 上运行,也能在 Linux 和 Windows 上运行。因此,这些操作系统的用户也可以选择运行同一模型。
完整变更记录还包括一项修复,让关闭推理功能的 Flint 直接生成响应。推理功能是指回答前进行中间思考的功能。变更说明指出,默认配置和开启推理时的提示词没有变化。
4. 搜索后的后续请求也遵循受支持的设置
兼容 Anthropic 的网页搜索后续请求已改为复用模型支持的推理设置,也就是将针对首次请求调整过的设置延续用于搜索后的请求。Ollama 表示,这可以防止本可避免的失败。
如果说流式变更侧重于将已发生的错误告知接收方,那么这项修复则侧重于为搜索后的后续请求使用合适的设置。同样是应对错误,一项处理失败信息的传递,另一项处理后续请求的配置一致性。
5. 集成代码需同时处理部分输出与最终状态
传递流式错误可以降低将中断结果当作完整回答处理的可能性。但原本只消费成功输出的集成代码,需要增加读取失败事件并向用户报告错误的处理。错误处理因此更加明确,同时消费流式数据的一方也更需要重视状态处理。
0.40.9 是一次明确报告流式失败、扩展云端模型信息传递和 Flint 支持范围,从而提升集成准确性并扩大选择范围的更新。