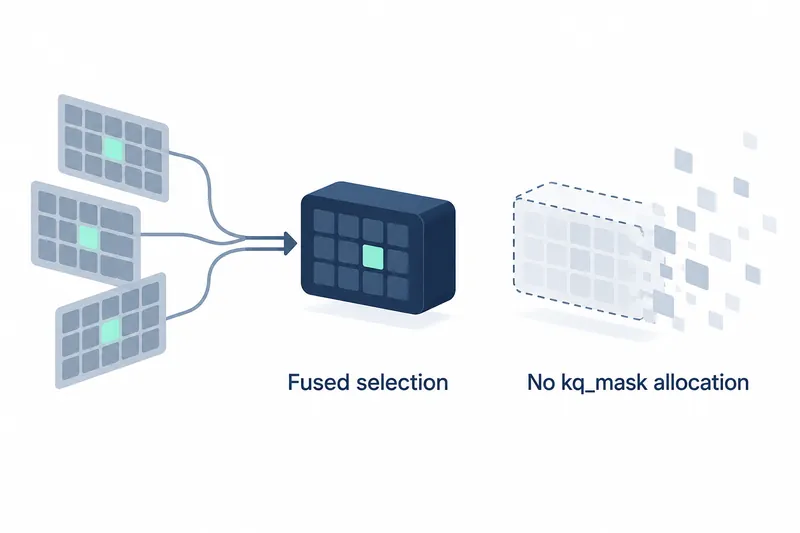
llama.cpp 合并了一项变更,在特定模型的注意力处理,即计算输入之间关系的过程中,不再创建用于存放临时数据的中间内存缓冲区。运行 Qwen 系列的相关模型时,可同时节省显存和 CPU 使用的主机内存,让内存紧张的环境有更多余量运行大模型。
1. 移除模型注意力处理中不必要的缓冲区
2026年10月23日合并的拉取请求 30965 适用于 qwen4exp;拉取请求是请求审查代码变更的流程。提交者解释,该模型的 12 个注意力层均采用 QSA 方式,因此无需单独分配 kq_mask。
这一方式不再创建存放独立标记的空间,而是将所需的选择结果融合起来。提交说明还指出,修复了同时使用多个处理流时,因选择结果的数组形状不匹配而在内存预分配阶段出现的错误。
2. 计算缓冲区中确认的内存减少:用于存放临时运算结果的空间
提交者 sanmai 仅统计计算缓冲区,对比了由基准代码生成的原 master 构建版本与变更后的构建版本。下表中的 ubatch 指一次计算的词元批量大小。
测量在 5090@400W 上进行。CUDA0 指 GPU 端缓冲区,CUDA_Host 指主机端缓冲区。
表:各构建版本的计算缓冲区内存
条件:Qwen3.8-Flash-Next UD-Q4_K_XL, 5090@400W, --load-mode dio, -cmoe --moe-cache-mib 8000 -ctk q8_0 -ctv q5_1
单位:MiB
| 项目 | master | PR |
|---|---|---|
| CUDA0 缓冲区,ubatch 4096 | 7088 | 5046 |
| CUDA0 缓冲区,ubatch 8192 | 13327 | 9237 |
| CUDA_Host 缓冲区,ubatch 4096 | 2765 | 717 |
| CUDA_Host 缓冲区,ubatch 8192 | 5526 | 1430 |
变更后的构建版本中,两类缓冲区均有所缩小。提交者将其概括为:词元批量大小为 4096 时,GPU 和主机内存各节省 2GB;为 8192 时,各节省 4GB。这是模型计算所需的临时工作空间在两端同时减少的结果。
3. 速度与实际模型验证
提交者表示,其他条件相同时,词元生成速度提升了 40%。公开的变更后构建版本测量显示,ubatch 为 4096、用于临时保存模型专家信息的专家缓存为 17750 MiB 时,输入处理速度为每秒 1004 个词元,生成速度为每秒 45.5 个词元,峰值显存占用为 32066 MiB。
ubatch 为 8192、专家缓存为 13400 MiB 时,输入处理速度为每秒 1470 个词元,生成速度为每秒 41.2 个词元,峰值显存占用为 32036 MiB。两次测量均使用前述 5090@400W 和相同的加载方式。
原文的速度表未提供原构建版本的基准数据,两次运行的缓存设置也不同,因此难以直接比较优劣。计算缓冲区表统计的也只是临时计算空间,而非总内存。
批准审查的 ServeurpersoCom 表示,已使用实际的 UD-Q4_K_XL 模型验证。当上下文,即模型参考的输入范围为 16384 时,作为下一词元候选评分的 logits 与原构建版本逐字节一致;上下文为 262144、词元批量大小为 8192 时,计算缓冲区和固定主机缓冲区各减少了 4GiB。
4. 通过公开的运行命令确认条件
提交者公开了运行 Qwen3.8-Flash-Next 的 UD-Q4_K_XL 模型所用的命令。该命令对应专家缓存设为 13400 MiB 的测量,也可据此确认加载方式和词元批量大小。
llama-server -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL \
    --no-mmproj -ctk q8_0 -ctv q5_1 --cache-ram 32768 \
    -b 8192 -ub 8192 \
    -cmoe --moe-cache-mib 13400 --load-mode dio
提交者预计,16GB·24GB 显卡用户对这种方式带来的效果感受最明显。他认为,释放空间的价值取决于运行条件距离内存上限有多近。
5. 模型定制优化的意义
收益是节省 GPU 和主机的计算空间,所需投入则是针对各模型适配执行路径的开发与验证。本次变更也同时进行了数组形状修正和实际模型的 logits 对比。这项优化的工作重点在实现端,而非用户的配置组合。
该变更通过了 19 项自动检查,并合并至 master。对于使用该模型的开发者,这意味着可以通过包含该合并内容的构建版本获得内存节省。
本次合并移除了 QSA 模型中不必要的缓冲区,尤其为接近内存上限的运行环境增加了实际可用的余量。