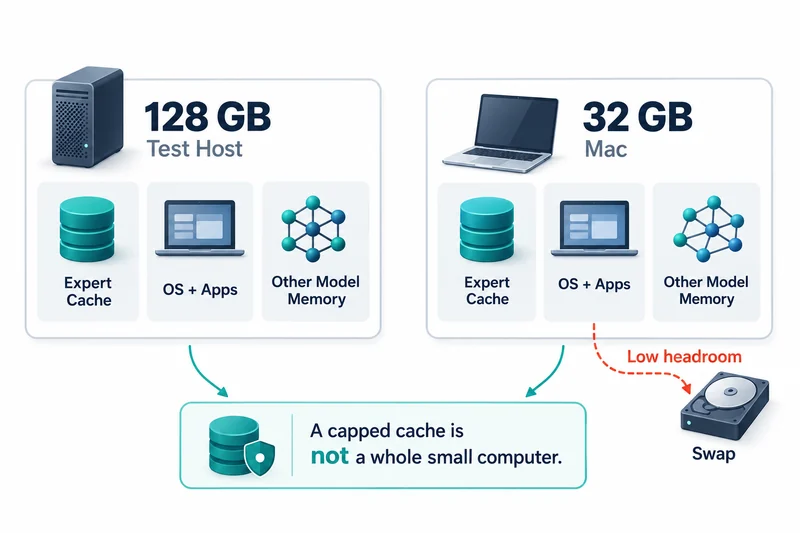
strata-mlx 是在 Apple Silicon 上运行 Qwen3.8-Flash-Next 的 MLX 引擎。它直接读取 Strata 使用的 GGUF 文件并使用 Strata 的行协议,因此 Strata 的服务器和网页可以驱动它。
README 说明这是一个与 Strata 无关的独立、非官方实验项目。公开介绍于 10 月 10 日发在 Reddit 上。
在 128GB Mac 上模拟的小内存数字
该引擎让专家权重保持文件原有的量化块,放不进内存的专家在 token 需要时从 SSD 读取。
最初的小内存数字是在 128GB M4 Max 上限制专家预算、模拟 16GB、24GB 和 32GB 设备得到的。这种方式只减少引擎保留的专家数量,并不会让 macOS 和其他应用争夺同一块物理内存。
现在的 README 把这些模拟数字与真实设备用户的报告分开记录。
真实 32GB MacBook Air M5 上的测量
10 月 11 日开启的 issue 6 整理了贡献者 guoggg 的测量。环境为 32GB MacBook Air M5、macOS 27.0.1、MLX 0.32.3、提交 1d75ad4,以及带草拟头的 Q2_0。
默认的 20.5GB 专家预算下平均 11.9 tok/s,运行中换出 106GB;16GB 下平均 25.3 tok/s,换出 1.7GB。每一行都是 4 个提示各跑两轮、每次生成 200 token 的单次运行。
贡献者 guoggg 的测量。提交 1d75ad4,使用带草稿头的 Q2_0,并开着约 2GB 的其他程序;用 bench/paged.py 将 4 个提示各运行两轮,每次生成 200 个词元。每一行都是单次运行。
| 放入内存的专家 | 草稿头平均(tok/s) | 范围(tok/s) | 运行中换出 |
|---|---|---|---|
| 14 GB | 23.6 | 20.9–24.8 | 未记录 |
| 16 GB | 25.3 | 23.4–26.8 | 1.7 GB |
| 18 GB | 15.4 | 12.0–24.4 | 39 GB |
| 20.5 GB(默认值) | 11.9 | 5.8–19.2 | 106 GB |
维护者判断,引擎留给 macOS 和其他程序的 4.5GB 太少。即使关闭所有应用,macOS 自身也占用约 6GB。
106GB 是运行期间累计的交换传输量,并不是说 32GB 设备同时占用了这么多交换空间。
多在内存里放一个专家,可以减少引擎的 SSD 读取,却可能把其他内存挤进操作系统的交换区。因此把专家预算开到最大,并不能让等待回答的时间最短。
注意事项:仍在进行的校准与单台设备
维护者先加入了为 macOS 留出 8.5GB 的默认值(提交 2f9d1ab)。关闭应用时它与 16GB 那一行速度相同,但在开着应用的运行中换出了 16.8GB。
随后加入了 --expert-memory available 选项,按引擎启动时的可用内存设定专家预算。10 月 13 日在开着大量应用的状态下运行,8.08GB 预算平均 17.1 tok/s,换出量为 0。
之后的 10GB 和 12GB 运行,启动时的空闲内存和压缩状态都不同,因此并不能说明相同条件下的最佳预算。这些都来自一个人的一台设备。
在自己的 Mac 上比较时要统一的条件
如果在已有的 Mac 上比较,可以统一模型版本、提示、输出长度和后台应用,并在记录生成速度的同时记录交换量变化。
空闲的测试机与需要让编辑器和浏览器保持响应的笔记本,回答的是不同的问题。
缓存小并不总是正解
常驻专家太少,刻意的 SSD 读取就会增加;太多,又会带来交换这种难以预测的成本。这份报告展示的是在一台设备上寻找这种平衡的过程。
strata-mlx 的 32GB Mac 报告说明,守住留给 macOS 的内存比扩大专家缓存更快,但它并不能为所有 Mac 决定默认值。