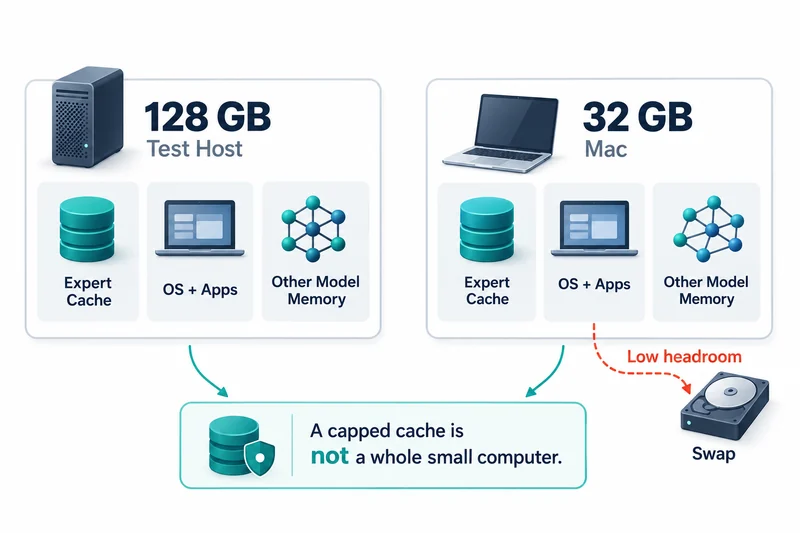
strata-mlxは、Apple SiliconでQwen3.8-Flash-Nextを動かすMLXエンジンだ。Strataが使うGGUFファイルをそのまま読み、Strataのラインプロトコルを話すため、Strataのサーバーとウェブページから動かせる。
READMEは、Strataとは無関係の独立・非公式な実験プロジェクトだと明記している。公開の投稿は10月10日にRedditに出た。
128GBのMacで模した小容量の数値
このエンジンはエキスパートの重みをファイル本来の量子化ブロックのまま保ち、メモリに収まらないエキスパートはトークンが求めたときにSSDから読む。
初期の小容量の数値は、128GBのM4 Maxでエキスパート予算を制限し、16・24・32GB機を模したものだった。この方法はエンジンが保持するエキスパート数を減らすだけで、macOSや他のアプリが同じ物理メモリを奪い合う状況は作らない。
現在のREADMEは、こうした模擬の数値と実機の持ち主による報告を分けて記している。
実際の32GB MacBook Air M5での測定
10月11日に開かれたissue 6は、貢献者guogggの測定をまとめたものだ。環境は32GBのMacBook Air M5、macOS 27.0.1、MLX 0.32.3、コミット1d75ad4、ドラフトヘッド付きのQ2_0だった。
既定のエキスパート予算20.5GBでは平均11.9 tok/sで実行中のスワップアウトが106GB、16GBでは平均25.3 tok/sで1.7GBだった。各行は、プロンプト4つを2巡、それぞれ200トークン生成した1回の実行だ。
貢献者guogggの測定だ。コミット1d75ad4、ドラフトヘッド付きのQ2_0で、他のプログラムを約2GB開いた状態のまま、bench/paged.pyでプロンプト4つを2回ずつ200トークン生成した。各行は1回の実行である。
| メモリに置いたエキスパート | ドラフトヘッド平均(tok/s) | 範囲(tok/s) | 実行中のスワップアウト |
|---|---|---|---|
| 14 GB | 23.6 | 20.9–24.8 | 記録なし |
| 16 GB | 25.3 | 23.4–26.8 | 1.7 GB |
| 18 GB | 15.4 | 12.0–24.4 | 39 GB |
| 20.5 GB(既定値) | 11.9 | 5.8–19.2 | 106 GB |
メンテナーは、エンジンがmacOSと他のプログラムに残した4.5GBが少なすぎたと判断した。アプリをすべて閉じた測定でも、macOS自体が約6GBを使っていた。
106GBは実行中に累積したスワップの転送量で、32GB機がそれだけのスワップを一度に占めていたという意味ではない。
エキスパートを1つ多くメモリに置けばエンジンのSSD読み出しは減るが、他のメモリをOSのスワップへ押し出しうる。そのため、エキスパート予算を最大にしても応答の待ちが最小になるわけではない。
注意点:進行中の調整と1台の機器
メンテナーはまず、macOSに8.5GBを残す既定値(コミット2f9d1ab)を入れた。アプリを閉じた状態では16GBの行と同じ速度だったが、アプリを開いたままの実行では16.8GBをスワップアウトした。
その後、エンジン起動時の利用可能メモリからエキスパート予算を決める--expert-memory availableオプションが加わった。10月13日、アプリを多く開いた状態の実行では、8.08GBの予算で平均17.1 tok/s、スワップアウト0だった。
続く10GBと12GBの実行は、開始時の空きメモリと圧縮の状態が違うため、同じ条件での最適な予算を示すものではない。いずれも1人の1台の機器から出た値だ。
自分のMacで比べるときにそろえる条件
手元のMacで比べるなら、モデルのリビジョン、プロンプト、出力長、バックグラウンドのアプリをそろえ、生成速度と一緒にスワップの変化を記録する方法がある。
手の空いた試験機と、エディターやブラウザーが反応し続ける必要のあるノートPCでは、答える問いが違う。
小さいキャッシュが常に正解ではない
常駐するエキスパートが少なすぎれば意図したSSD読み出しが増え、多すぎればスワップという予測しにくいコストが生じる。この報告が示すのは、1台の機器でその釣り合いを探る過程だ。
strata-mlxの32GB Macの報告は、エキスパートキャッシュを増やすよりmacOSに残すメモリを守るほうが速かった事例であり、すべてのMacの既定値を決めるものではない。