strata-mlx는 Apple Silicon에서 Qwen3.8-Flash-Next를 실행하는 MLX 엔진이다. Strata가 쓰는 GGUF 파일을 그대로 읽고 Strata의 라인 프로토콜을 써서, Strata의 서버와 웹 페이지가 이 엔진을 구동할 수 있다.
README는 Strata와 무관한 독립·비공식 실험 프로젝트라고 밝힌다. 공개 글은 10월 10일 Reddit에 올라왔다.
128GB Mac에서 흉내 낸 소용량 수치
이 엔진은 전문가 가중치를 파일의 원래 양자화 블록 그대로 두고, 메모리에 들어가지 않는 전문가는 토큰이 요구할 때 SSD에서 읽는다.
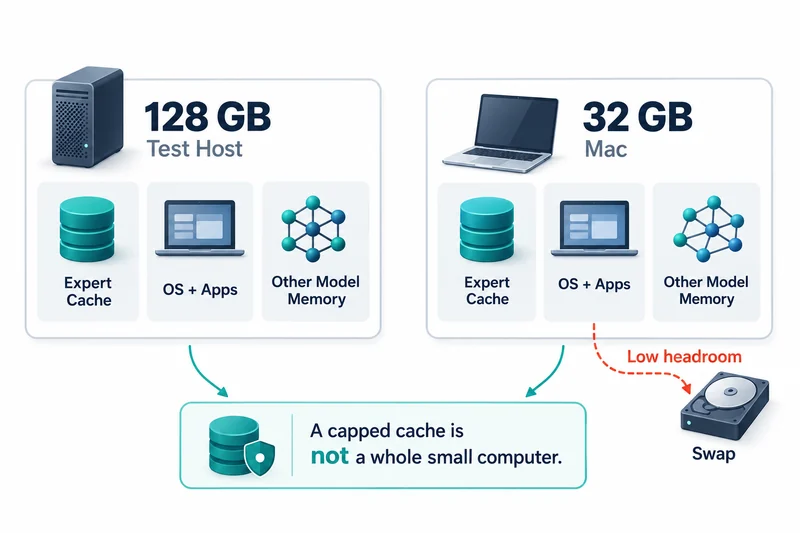
초기 소용량 수치는 128GB M4 Max에서 전문가 예산을 제한해 16·24·32GB 기기를 흉내 낸 값이었다. 이 방식은 엔진이 보관할 전문가 수만 줄일 뿐, macOS와 다른 앱이 같은 물리 메모리를 놓고 경쟁하는 상황은 만들지 않는다.
현재 README는 이 모의 수치와 실제 기기 소유자의 보고를 나눠 적는다.
실제 32GB MacBook Air M5의 측정
10월 11일 열린 이슈 6은 기여자 guoggg의 측정을 정리했다. 환경은 32GB MacBook Air M5, macOS 27.0.1, MLX 0.32.3, 커밋 1d75ad4, 드래프트 헤드를 쓴 Q2_0이었다.
기본값인 전문가 예산 20.5GB에서는 평균 11.9 tok/s에 실행 중 스왑아웃 106GB, 16GB에서는 평균 25.3 tok/s에 1.7GB였다. 각 행은 프롬프트 4개를 두 번씩, 200토큰씩 생성한 단일 실행이다.
기여자 guoggg의 측정이다. 커밋 1d75ad4, 드래프트 헤드를 쓴 Q2_0, 다른 프로그램 약 2GB를 연 상태에서 bench/paged.py로 프롬프트 4개를 두 번씩 200토큰 생성했다. 각 행은 한 번의 실행이다.
| 메모리에 둔 전문가 | 드래프트 헤드 평균(tok/s) | 범위(tok/s) | 실행 중 스왑아웃 |
|---|---|---|---|
| 14 GB | 23.6 | 20.9–24.8 | 기록 없음 |
| 16 GB | 25.3 | 23.4–26.8 | 1.7 GB |
| 18 GB | 15.4 | 12.0–24.4 | 39 GB |
| 20.5 GB (기본값) | 11.9 | 5.8–19.2 | 106 GB |
관리자는 엔진이 macOS와 다른 프로그램에 남긴 4.5GB가 너무 적었다고 진단했다. 앱을 모두 닫은 측정에서도 macOS 자체가 약 6GB를 쓰고 있었다.
106GB는 실행 동안 누적된 스왑 전송량이며, 32GB 기기가 그만큼의 스왑을 한꺼번에 점유했다는 뜻이 아니다.
전문가 하나를 더 메모리에 두면 엔진의 SSD 읽기는 줄지만, 다른 메모리를 운영체제 스왑으로 밀어낼 수 있다. 그래서 전문가 예산을 최대로 잡는 것이 응답 대기를 최소로 만들지는 않는다.
주의할 점: 진행 중인 보정과 한 대의 기기
관리자는 먼저 macOS 몫을 8.5GB로 늘린 기본값(커밋 2f9d1ab)을 넣었다. 이 기본값은 앱을 닫은 상태에서는 16GB 행과 같은 속도를 냈지만, 앱을 열어 둔 실행에서는 16.8GB를 스왑아웃했다.
이후 엔진 시작 시점의 가용 메모리로 전문가 예산을 정하는 --expert-memory available 선택 기능이 추가됐다. 10월 13일 앱을 많이 연 상태의 실행에서는 8.08GB 예산으로 평균 17.1 tok/s, 스왑아웃 0을 기록했다.
뒤이은 10GB와 12GB 실행은 시작 시점의 여유 메모리와 압축 상태가 달라, 같은 조건의 최적 예산을 보여 주지는 않는다. 모두 한 사람의 기기 한 대에서 나온 값이다.
자기 Mac에서 비교할 때 맞출 조건
이미 가진 Mac에서 비교한다면 모델 리비전, 프롬프트, 출력 길이, 백그라운드 앱을 맞추고 생성 속도와 함께 스왑 변화를 기록하는 방법이 있다.
한가한 시험 기기와 편집기·브라우저가 계속 반응해야 하는 노트북은 서로 다른 질문에 답한다.
작은 캐시가 늘 정답은 아니다
전문가 상주량이 너무 적으면 의도적인 SSD 읽기가 늘고, 너무 많으면 스왑이라는 예측하기 어려운 비용이 생긴다. 이 보고가 보여 주는 것은 한 기기에서 그 균형을 찾는 과정이다.
strata-mlx의 32GB Mac 보고는 전문가 캐시를 키우는 것보다 macOS에 남길 메모리를 지키는 쪽이 더 빨랐던 사례이며, 모든 Mac의 기본값을 정해 주지는 않는다.