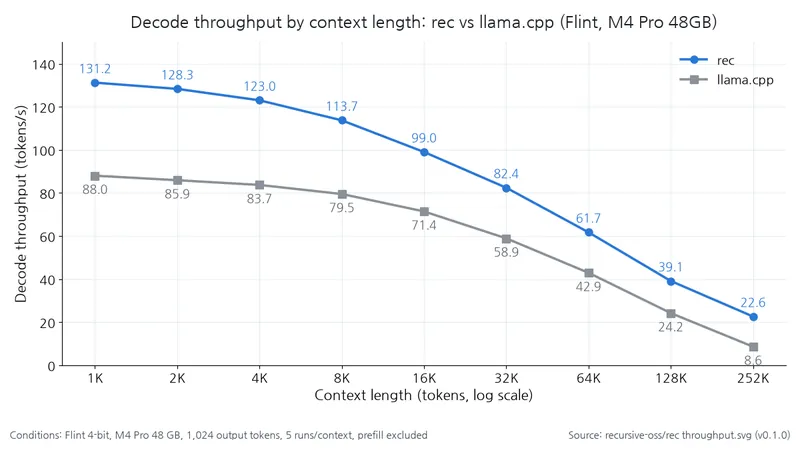
Flint 是直接在 Mac 上运行的本地编程语言模型。Recursive 于 2026 年 10 月 21 日发布了专用推理引擎 rec 的首个正式版本 v0.1.0,让受支持的 Mac 能更快、更便捷地使用该模型。只需一条命令,即可下载模型、启动服务器,并连接用于接入编程工具的运行框架。公司自测显示,在同一 M4 Pro 48GB 环境下,使用 Flint 4 位权重和 1K~252K token 上下文时,解码吞吐量是 llama.cpp 的 1.4~2.6 倍。
3 项核心变化
公司表示,已用 Metal 巨型内核融合整个解码路径。根据公告,在 M4·M5 芯片上,生成一个 token 的全部计算过程会合并为一个 Metal 巨型内核。
公告介绍的量化旨在降低每个 token 读取权重的内存负担。公司解释,Flint 的全部 39.8B 参数中,每个 token 仅激活约 2.5B,因此输出层在每个 token 读取的权重中占比较大。将该层也缩减至 4 位后,以 16 位模型为教师进行离线蒸馏来恢复准确度,最终 NVFP4 模型的基准测试分数与 16 位模型相差不超过 0.7 分。公告把这一分数列为 NVFP4 检查点自身的结果,并未说明它同样适用于 rec 吞吐量测试中在苹果芯片上测量的 4 位权重。
首次发布命令行界面 CLI。它可自动管理模型、启动服务器并连接编程运行框架。
提供兼容 OpenAI 的 Chat Completions API。Cline 或 VS Code Chat 等其他客户端也可连接本地服务器。
模型规格
除速度外,公司还公布了模型性能指标。官方模型卡显示,使用工具执行任务的智能体评测各运行至少 5 次,并报告单次尝试通过率 pass@1 的平均值。Flint 在考察工具辅助编程能力的 Terminal-Bench 2.1 中得分为 54.9%,在考察编程智能体问题解决能力的 SWE-bench Pro v2 和 SWE-bench Verified 中分别为 89.7%、74.2%。
公司声称,在每个 token 仅激活部分参数、规模低于 50B 的 MoE 模型中,该模型在智能体编程评测中领先。
以下规格同样依据官方模型卡。
表:Flint 模型规格
条件:依据 Recursive 官方模型卡(规格及公司自测分数)
单位:参数为 B,上下文和词表为 token
| 项目 | 值 |
|---|---|
| 总参数量 | 39.8B |
| 激活参数量(每个 token) | 约 2.5B |
| 上下文设置 | 262,144 |
上下文设置为提示词与生成输出的合计值。
不同上下文的吞吐量
公司还公布了另一项对比:其得分与每次输入都使用全部参数的 25~40B 稠密模型相近,而速度超过其 5 倍。
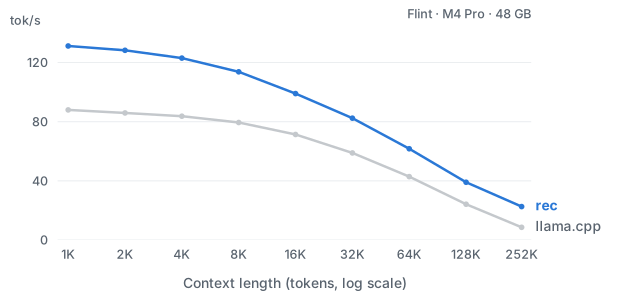
表:不同上下文的解码吞吐量及 rec 相对 llama.cpp 的倍数
条件:Flint 4 位权重,Apple M4 Pro 48GB,1K~252K token 提示词,输出 1,024 token,每种上下文重复 5 次,统计排除提示词处理阶段的解码生成速度。中间值由仓库图表(throughput.svg)的坐标反推,倍数为两者吞吐量之商,两端值在图表说明中明确列出。
单位:token/秒,倍
| 上下文 | rec (token/秒) | llama.cpp (token/秒) | 倍数 |
|---|---|---|---|
| 1K | 131.2 | 88.0 | 1.49 |
| 2K | 128.3 | 85.9 | 1.49 |
| 4K | 123.0 | 83.7 | 1.47 |
| 8K | 113.7 | 79.5 | 1.43 |
| 16K | 99.0 | 71.4 | 1.39 |
| 32K | 82.4 | 58.9 | 1.4 |
| 64K | 61.7 | 42.9 | 1.44 |
| 128K | 39.1 | 24.2 | 1.61 |
| 252K | 22.6 | 8.6 | 2.63 |
两款引擎的绝对吞吐量差距从 1K 时的 43.2 token/秒缩小至 252K 时的 14.0 token/秒,但相对倍数从 1K 时的 1.49 倍降至 16K 时的 1.39 倍,再增至 252K 时的 2.63 倍。表中 9 个测量点的 rec 吞吐量均更高。因此,输入长代码或对话历史时,选择 rec 会比 llama.cpp 生成得更快,但上下文本身越长,等待相同输出量的时间也越长。
升级方法
运行条件为搭载 M4 Pro·M5 Pro·M5 Max 的 Mac、至少 48GB 统一内存,以及约 30GB 可用磁盘空间。运行 pi 和 OpenCode 还需要 Node.js 22 与 npm。
安装只需一行脚本。
curl -fsSL https://raw.githubusercontent.com/recursive-oss/rec/main/install.sh | bash安装脚本会验证二进制文件的校验和及大小,若不是 Apple Silicon 则会中止。
安装后,在项目目录运行 rec launch pi,首次运行时会下载模型与运行框架,随后自动启动服务器并完成连接。OpenCode 可通过 rec launch opencode 以相同方式连接。公司推荐使用 pi 运行框架,称其能发挥最佳模型性能。公司文档中关于 pi 比 OpenCode 快约 1.5 倍的非正式报告,是对整个编程工作流的估算,会因任务、硬件和设置而异。
管理方面,可用 rec doctor 检查硬件、rec pull 预下载模型、rec stop 停止服务器、rec update 更新至新版本。
连接方法:其他客户端可先用 rec serve 启动服务器,再接入兼容 OpenAI 的 API。默认地址为 http://127.0.0.1:11500/v1,模型 ID 为 flint,密钥为 rec auth token 的输出值。
这是首个版本,没有此前的正式版本。不过,有些限制需提前了解。
若不满足支持的芯片及内存要求,则不会下载模型;引擎一次只能处理一个生成任务,可能对并发请求返回 HTTP 429;NVIDIA RTX Spark 支持仍在准备中。
对谁重要
对于在受支持的 Mac 上使用本地编程模型的开发者,rec 可一次性完成模型管理、服务器启动及运行框架配置。pi 和 OpenCode 使用随附的运行配置,无需单独安装运行框架。若要连接编辑器扩展或自有应用,可使用兼容 OpenAI 的本地 API。
在长上下文中,rec 的相对优势会扩大,但两款引擎的绝对生成速度都会下降。