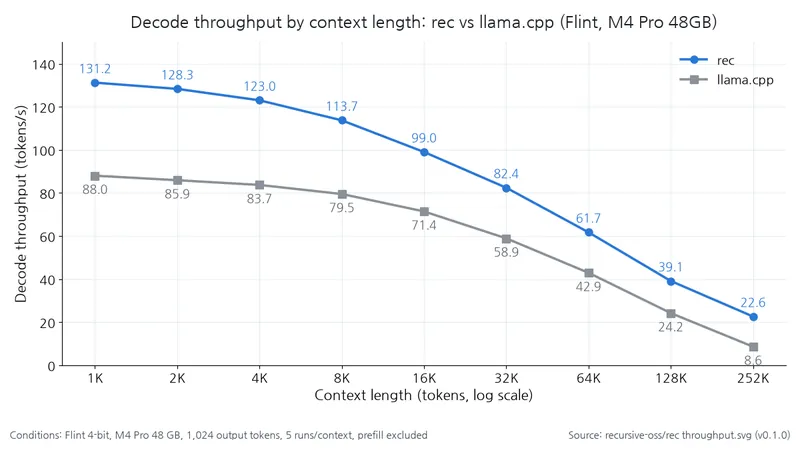
FlintはMac上で直接動くローカルのコーディング用言語モデルだ。Recursiveは対応Macでこのモデルをより高速かつ手軽に使えるよう、専用推論エンジンrecの初の正式版v0.1.0を2026年10月21日に公開した。コマンド1行でモデルをダウンロードしてサーバーを起動し、コーディングツールを接続する実行環境であるハーネスまで組み込む。同社の測定では、同じM4 Pro 48GB環境でFlintの4ビット重みと1K~252Kトークンの文脈を使い、llama.cppの1.4~2.6倍のデコードスループットを記録した。
主な変更点3つ
同社はMetalメガカーネルでデコード経路全体を融合したと説明した。発表文によると、M4・M5チップでは1トークンを生成する全演算過程を単一のMetalメガカーネルにまとめる。
発表文で説明した量子化は、トークンごとに読み込む重みのメモリ負荷を減らす手法だ。同社によると、Flintは全体の39.8Bのうちトークンあたり約2.5Bのみを活性化するため、出力層がトークンごとに読み込む重みに占める割合が大きい。この層も4ビットに削減し、16ビットモデルを教師とするオフライン蒸留で精度を回復したという。最終的なNVFP4モデルのベンチマークスコアは、16ビットモデルとの差が0.7点以内だとした。発表文はこの差をNVFP4チェックポイント自身の結果として示しており、recのスループット測定でApple Silicon上で計測した4ビット重みにも当てはまるとは述べていない。
コマンドラインで使うインターフェースであるCLIを初公開した。モデル管理とサーバー起動、コーディングハーネスの接続を自動化する。
OpenAI互換のChat Completions APIを提供する。ClineやVS Code Chatなどの別のクライアントもローカルサーバーに接続できる。
モデル仕様
速度とともにモデル性能の指標も公開された。公式モデルカードによると、ツールで作業を行うエージェント評価をそれぞれ5回以上実行し、1回の試行で合格する割合であるpass@1の平均を報告した。Flintはツールを使ったコーディング能力を測るTerminal-Bench 2.1で54.9%を記録した。コーディングエージェントの問題解決能力を測るSWE-bench Pro v2とSWE-bench Verifiedでは、それぞれ89.7%、74.2%だった。
同社は、トークンごとに一部のパラメータのみを活性化する50B未満のMoEモデルの中で、エージェント型コーディング評価で首位だと主張した。
以下の仕様も公式モデルカードに基づく。
表:Flintのモデル仕様
条件:Recursiveの公式モデルカードに基づく(仕様・同社による評価スコア)
単位:パラメータはB、文脈・語彙はトークン
| 項目 | 値 |
|---|---|
| 総パラメータ | 39.8B |
| 活性パラメータ(トークンあたり) | 約2.5B |
| 文脈設定 | 262,144 |
文脈設定はプロンプトと生成出力を合わせた数値だ。
文脈別スループット
同社は、入力ごとに全パラメータを使う25~40Bの密モデルと同程度のスコアを出しながら、5倍以上高速だという比較も示した。
以下の表は公式リポジトリの測定条件とスループットのSVGを基にまとめた。
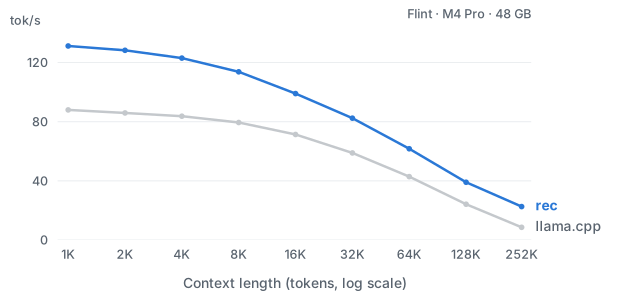
表:文脈別デコードスループットとrecのllama.cppに対する倍率
条件:Flintの4ビット重み、Apple M4 Pro 48GB、1K~252Kトークンのプロンプト、出力1,024トークン、文脈ごとに5回反復し、プロンプト処理区間を除いたデコード生成速度。中間値はリポジトリのチャート(throughput.svg)の座標から逆算し、倍率は両スループットの商で、両端の値はチャートの説明文に明記されている。
単位:トークン/秒、倍
| 文脈 | rec (トークン/秒) | llama.cpp (トークン/秒) | 倍率 |
|---|---|---|---|
| 1K | 131.2 | 88.0 | 1.49 |
| 2K | 128.3 | 85.9 | 1.49 |
| 4K | 123.0 | 83.7 | 1.47 |
| 8K | 113.7 | 79.5 | 1.43 |
| 16K | 99.0 | 71.4 | 1.39 |
| 32K | 82.4 | 58.9 | 1.4 |
| 64K | 61.7 | 42.9 | 1.44 |
| 128K | 39.1 | 24.2 | 1.61 |
| 252K | 22.6 | 8.6 | 2.63 |
両エンジンの絶対的なスループット差は1Kの43.2トークン/秒から252Kの14.0トークン/秒に縮まる。一方、相対倍率は1Kの1.49倍から16Kの1.39倍まで下がった後、252Kの2.63倍へと拡大する。表の9地点すべてでrecのスループットが高かった。したがって、長いコードや会話履歴を入力する際にrecを選ぶとllama.cppより速く生成できるが、文脈自体を長くするほど同じ量の出力を待つ時間は長くなる。
アップグレード方法
実行条件はM4 Pro・M5 Pro・M5 Max搭載Mac、48GB以上のユニファイドメモリ、約30GBの空きディスク容量だ。piとOpenCodeを実行するにはNode.js 22とnpmも必要となる。
インストールはスクリプト1行で行える。
curl -fsSL https://raw.githubusercontent.com/recursive-oss/rec/main/install.sh | bashインストールスクリプトはバイナリのチェックサムとサイズを検証し、Apple Siliconでなければ停止する。
インストール後、プロジェクトディレクトリでrec launch piを実行すると、初回にモデルとハーネスをダウンロードし、サーバーの起動と接続まで自動で進む。OpenCodeはrec launch opencodeで同様に接続する。同社はモデル性能が最も高い組み合わせとしてpiハーネスを推奨する。同社の文書にある、piがOpenCodeより約1.5倍速いという非公式報告は、コーディングワークフロー全体の推定であり、作業・ハードウェア・設定によって変わる。
管理では、rec doctorでハードウェアの確認、rec pullでモデルの事前ダウンロード、rec stopでサーバーの終了、rec updateで新リリースへの更新ができる。
接続方法:別のクライアントはrec serveでサーバーを起動してからOpenAI互換APIに接続する。デフォルトのアドレスはhttp://127.0.0.1:11500/v1、モデルIDはflint、キーはrec auth tokenの出力値だ。
以前の正式リリースがない初版だ。ただし、事前に知っておくべき制約がある。
対応チップ・メモリ要件を満たさない場合はモデルをダウンロードしない。エンジンは一度に1つの生成しか処理せず、重複するリクエストにはHTTP 429を返す場合がある。NVIDIA RTX Sparkへの対応はまだ準備中だ。
誰にとって重要か
対応Macでローカルのコーディングモデルを使う開発者にとって、recはモデル管理とサーバー起動、ハーネス設定をまとめて代行する。piとOpenCodeは同梱の実行設定を使うため、ハーネスを別途インストールする必要はない。エディター拡張や独自アプリを接続する場合は、OpenAI互換のローカルAPIを使えばよい。
長い文脈ではrecの相対的な優位性が高まるが、両エンジンの絶対的な生成速度はともに低下する。