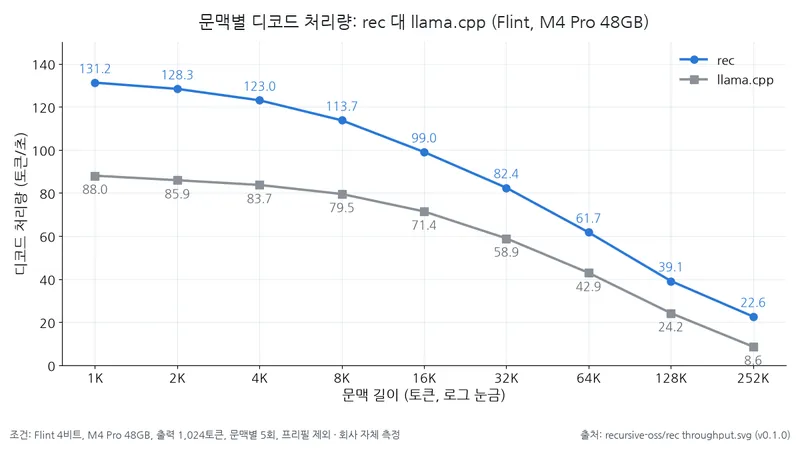
Flint는 맥에서 직접 실행하는 로컬 코딩용 언어 모델이다. Recursive는 지원 맥에서 이 모델을 더 빠르고 간편하게 쓰도록 전용 추론 엔진 rec의 첫 정식 버전 v0.1.0을 2026년 10월 21일 공개했다. 명령 한 줄로 모델을 내려받고 서버를 띄운 뒤 코딩 도구를 연결하는 실행 환경인 하네스까지 붙인다. 회사 자체 측정에서는 같은 M4 Pro 48GB 환경의 Flint 4비트 가중치와 1K~252K 토큰 문맥 구간에서 디코드 처리량이 llama.cpp보다 1.4~2.6배 높았다.
핵심 변경 3가지
회사는 Metal 메가커널로 디코드 경로를 통째로 융합했다고 설명했다. 발표문에 따르면 M4·M5 칩에서는 한 토큰을 만들어 내는 전체 연산 과정을 하나의 Metal 메가커널로 묶는다.
발표문이 설명한 양자화는 토큰마다 읽어야 하는 가중치의 메모리 부담을 줄이는 접근이다. Flint는 전체 39.8B 가운데 토큰당 약 2.5B만 활성화하므로, 출력 레이어가 토큰마다 읽는 가중치에서 차지하는 비중이 크다고 회사는 설명했다. 이 레이어까지 4비트로 줄인 뒤 16비트 모델을 교사로 삼는 오프라인 증류로 정확도를 회복했으며, 최종 NVFP4 모델의 성능 비교 시험 점수는 16비트 모델과 0.7점 이내 차이라고 밝혔다. 발표문은 이 수치를 자신의 NVFP4 체크포인트에 대한 결과로 밝히며, rec의 처리량 측정에서 애플 실리콘으로 측정한 4비트 가중치까지 적용된다고는 말하지 않는다.
명령줄에서 쓰는 인터페이스인 CLI를 처음 공개했다. 모델 관리와 서버 기동, 코딩 하네스 연결을 자동화한다.
OpenAI 호환 Chat Completions API를 제공한다. Cline이나 VS Code Chat 같은 다른 클라이언트도 로컬 서버에 연결할 수 있다.
모델 사양
속도 옆에 모델 성능 지표도 함께 공개됐다. 공식 모델 카드에 따르면 도구를 활용해 작업을 수행하는 에이전틱 평가를 각각 5회 이상 실행해 한 번의 시도에서 통과하는 비율인 pass@1의 평균을 보고했다. Flint는 도구를 써 코딩 작업을 수행하는 능력을 보는 Terminal-Bench 2.1에서 54.9%, 코딩 에이전트의 문제 해결 능력을 보는 SWE-bench Pro v2와 SWE-bench Verified에서 각각 89.7%, 74.2%를 기록했다.
회사는 토큰마다 일부 파라미터만 활성화하는 50B 미만 MoE 모델 가운데 에이전틱 코딩 평가에서 선두라고 주장했다.
아래 사양도 공식 모델 카드 기준이다.
표: Flint 모델 사양
조건: Recursive 공식 모델 카드 기준(사양·회사 자체 평가 점수)
단위: 파라미터는 B, 문맥·어휘는 토큰
| 항목 | 값 |
|---|---|
| 총 파라미터 | 39.8B |
| 활성 파라미터(토큰당) | 약 2.5B |
| 문맥 설정 | 262,144 |
문맥 설정은 프롬프트와 생성 출력을 합친 수치다.
문맥별 처리량
회사는 입력마다 모든 파라미터를 쓰는 25~40B 밀집 모델과 비슷한 점수를 내면서 5배 이상 빠르다는 비교도 함께 냈다.
아래 표는 공식 저장소의 측정 조건과 처리량 SVG를 바탕으로 정리했다.
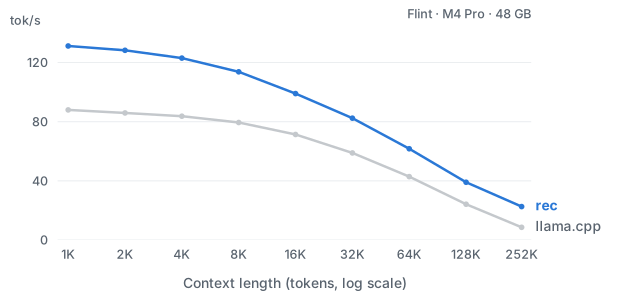
표: 문맥별 디코드 처리량과 rec의 llama.cpp 대비 배수
조건: Flint 4비트 가중치, Apple M4 Pro 48GB, 1K~252K 토큰 프롬프트, 출력 1,024토큰, 문맥별 5회 반복, 프롬프트 처리 구간을 뺀 디코드 생성 속도. 중간 값은 저장소 차트(throughput.svg) 좌표 역산값, 배수는 두 처리량의 몫, 양 끝값은 차트 설명 문구 명시.
단위: 토큰/초, 배
| 문맥 | rec (토큰/초) | llama.cpp (토큰/초) | 배수 |
|---|---|---|---|
| 1K | 131.2 | 88.0 | 1.49 |
| 2K | 128.3 | 85.9 | 1.49 |
| 4K | 123.0 | 83.7 | 1.47 |
| 8K | 113.7 | 79.5 | 1.43 |
| 16K | 99.0 | 71.4 | 1.39 |
| 32K | 82.4 | 58.9 | 1.4 |
| 64K | 61.7 | 42.9 | 1.44 |
| 128K | 39.1 | 24.2 | 1.61 |
| 252K | 22.6 | 8.6 | 2.63 |
두 엔진의 절대 처리량 차이는 1K 43.2토큰/초에서 252K 14.0토큰/초로 줄지만, 상대 배수는 1K 1.49배에서 16K 1.39배까지 낮아졌다가 252K 2.63배로 커진다. 표에 오른 9개 지점 모두 rec의 처리량이 더 높았다. 따라서 긴 코드나 대화 이력을 넣을 때 rec을 선택하면 llama.cpp보다 빠르게 생성하지만, 문맥 자체를 늘릴수록 같은 분량의 출력을 기다리는 시간은 길어진다.
업그레이드 방법
실행 조건은 M4 Pro·M5 Pro·M5 Max 맥, 통합 메모리 48GB 이상, 여유 디스크 약 30GB다. pi와 OpenCode를 실행하려면 Node.js 22와 npm도 필요하다.
설치는 스크립트 한 줄이다.
curl -fsSL https://raw.githubusercontent.com/recursive-oss/rec/main/install.sh | bash설치 스크립트는 바이너리의 체크섬과 크기를 검증하고 Apple Silicon이 아니면 중단한다.
설치 후 프로젝트 디렉터리에서 rec launch pi를 실행하면 첫 실행 때 모델과 하네스를 내려받고 서버 기동과 연결까지 자동으로 이어진다. OpenCode는 rec launch opencode로 같은 방식으로 연결한다. 회사는 모델 성능이 가장 좋은 조합으로 pi 하네스를 권장한다. 회사 문서의 pi가 OpenCode보다 약 1.5배 빠르다는 비공식 보고는 전체 코딩 워크플로에 대한 추정으로, 작업·하드웨어·설정에 따라 달라진다.
관리는 rec doctor로 하드웨어 점검, rec pull로 모델 사전 다운로드, rec stop으로 서버 종료, rec update로 새 릴리스 업데이트를 할 수 있다.
연결 방법: 다른 클라이언트는 rec serve로 서버를 띄운 뒤 OpenAI 호환 API에 붙인다. 기본 주소는 http://127.0.0.1:11500/v1, 모델 ID는 flint, 키는 rec auth token의 출력값이다.
이전 정식 릴리스가 없는 첫 버전이다. 대신 미리 알아둘 제약이 있다.
지원 칩·메모리 요건을 충족하지 못하면 모델을 내려받지 않으며, 엔진은 한 번에 하나의 생성만 처리해 겹치는 요청에 HTTP 429를 반환할 수 있고, NVIDIA RTX Spark 지원은 아직 준비 중이다.
누구에게 중요한가
지원 맥에서 로컬 코딩 모델을 쓰는 개발자에게 rec은 모델 관리와 서버 기동, 하네스 설정을 한 번에 대신한다. pi와 OpenCode는 함께 제공되는 실행 설정을 쓰므로 하네스를 별도로 설치할 필요가 없다. 편집기 확장이나 자체 앱을 붙이려는 쪽이라면 OpenAI 호환 로컬 API를 쓰면 된다.
긴 문맥에서는 rec의 상대 우위가 커지지만, 두 엔진의 절대 생성 속도는 함께 낮아진다.