PXA v3.1 于韩国时间 10 月 11 日(UTC 10 月 10 日)发布。核心是 Overdrive 预设,这是面向 Flash-Next 模型的速度设置,在 Tesla P100 上调校,据称在 V100 和双卡配置上也更快。
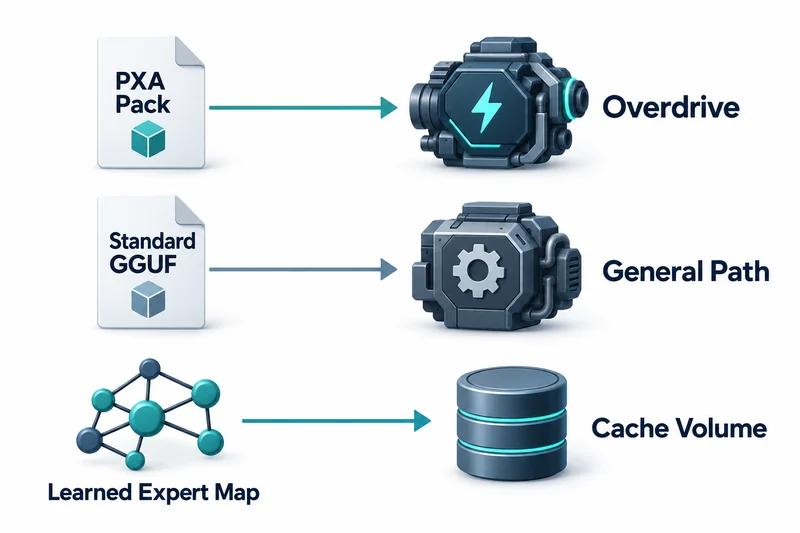
v3.1 使用与 v3 相同的模型文件。不过 Overdrive 预设需要随包附带的 PXQN 库。
文件兼容不等于速度优化
README 把 PXA 介绍为面向 Tesla P100、Tesla V100、GTX 1080 Ti 等 Pascal 和 Volta 显卡的语言模型服务器。其 GPU 代码针对 P100(sm_60)、1080 Ti 和 P40(sm_61)以及 V100(sm_70),使用这些显卡实际具备的指令。
Q4_K_M、Q8_0 等普通 GGUF 量化也能在同一服务器上加载运行。但 GPU 代码、规划器和速度表都是围绕 PXA 自有的 PXQ 和 PXQN 文件构建的。
在使用中学习的专家映射
混合专家(MoE)模型随附路由映射,服务器还能根据你的使用情况学习第二份映射。学到的映射在会话结束后保存,只有在测得比自带映射更快时才会使用,重启后依然保留。
发布说明称,学到的映射在散文解码上比自带映射快约 12%,在代码解码上快约 18%。在单块 P100 上开启 Overdrive 后,散文解码约 30.3 tok/s,代码为 34.9 tok/s。
这些数字是项目自己在 v3.1 发布版构建中、于会话同一位置测得的,并非独立基准测试。
Docker 用户需要把缓存目录挂载为命名卷,删除容器后学到的映射才能保留。发布说明给出的挂载参数如下。
-v pxa-cache:/work/.cache/pxa学习状态混入版本比较的问题
只要学到的映射还在,重启服务器也不会回到相同的起点。如果一次运行用学到的映射、另一次用自带映射,可执行文件的差异就会与适应效果混在一起。
比较版本时,可以记录映射状态,或者把初始状态测试与适应后的测试分开。
注意事项:各组件许可证不同
仓库的许可证映射把根目录的推理引擎划为 MIT,把用于 vLLM 的 PXQ4 量化插件划为 Apache-2.0。文档写明两者兼容,但并非同一许可证。
发布说明称,赞助者可以在 PXA Control 中更新和回滚受许可约束的库。本文没有审查该库的使用条款。
发布说明还指出,在多 CPU 插槽的机器上以容器运行带专家缓存的 Flash-Next,需要 SYS_NICE 权限。
P100 和 V100 用户的检查顺序
已经在用 P100 或 V100 的话,比较自然的顺序是先确认所需模型有没有 PXA 包,以及所需的库是否符合部署要求。
之后把实际的散文请求和代码请求分开比较,不同任务就不会混成一个代表速度。
专用格式与可移植性之间的取舍
在多个引擎之间切换时,普通 GGUF 更方便;要评估 PXA 的优化,PXA 包才是合适的途径。两者都不能证明新包在所有任务上都保持质量。
PXA 3.1 的 Overdrive 速度,来自 PXA 包、随附库和保留的专家映射同时到位的部署配置。