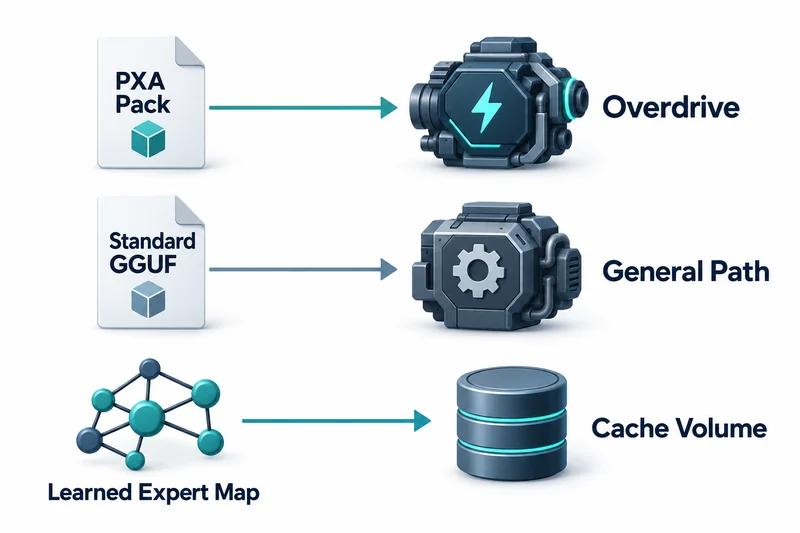
PXA v3.1이 한국 시간 10월 11일(UTC 10월 10일)에 공개됐다. 핵심은 Flash-Next 모델용 속도 설정인 Overdrive 프리셋으로, Tesla P100에서 조정했고 V100과 두 카드 구성에서도 더 빠르다고 한다.
v3.1은 v3와 같은 모델 파일을 쓴다. 다만 Overdrive 프리셋에는 패키지에 동봉된 PXQN 라이브러리가 필요하다.
파일 호환성과 속도 최적화는 다르다
README는 PXA를 Tesla P100, Tesla V100, GTX 1080 Ti 같은 Pascal·Volta 카드용 언어 모델 서버로 소개한다. GPU 코드는 P100(sm_60), 1080 Ti·P40(sm_61), V100(sm_70)을 겨냥해 이 카드들에 실제로 있는 명령어를 쓴다.
Q4_K_M, Q8_0 같은 일반 GGUF 양자화도 같은 서버에서 불러와 실행된다. 그러나 GPU 코드, 플래너, 속도 표는 PXA 자체 형식인 PXQ·PXQN 파일을 중심으로 만들어졌다.
사용하면서 학습하는 전문가 맵
전문가 혼합(MoE) 모델은 기본 라우팅 맵과 함께 배포되고, 서버는 사용 기록으로 두 번째 맵을 학습할 수 있다. 학습한 맵은 세션 뒤 저장되며 기본 맵보다 빠르다고 측정될 때만 쓰이고, 재시작 후에도 유지된다.
릴리스 노트는 학습한 맵이 기본 맵보다 산문 디코드에서 약 12%, 코드 디코드에서 약 18% 빨랐다고 밝힌다. Overdrive를 켠 P100 한 장에서는 산문 약 30.3 tok/s, 코드 34.9 tok/s였다.
이 수치는 v3.1 릴리스 빌드에서 세션의 같은 지점에 잰 프로젝트 자체 측정이다. 독립 벤치마크는 아니다.
Docker 사용자는 캐시 폴더를 이름 있는 볼륨으로 마운트해야 학습한 맵이 컨테이너 삭제 뒤에도 남는다. 릴리스 노트가 제시한 마운트 인자는 다음과 같다.
-v pxa-cache:/work/.cache/pxa학습 상태가 버전 비교에 섞이는 문제
학습한 맵이 남아 있으면 서버를 재시작해도 같은 출발점으로 돌아가지 않는다. 한쪽은 학습한 맵, 다른 쪽은 기본 맵으로 돌리면 실행 파일 차이와 적응 효과가 섞인다.
버전을 비교할 때는 맵 상태를 기록하거나, 초기 상태 시험과 적응 후 시험을 따로 나누는 방법이 있다.
주의할 점: 구성 요소마다 다른 라이선스
저장소의 라이선스 맵은 루트의 추론 엔진을 MIT, vLLM용 PXQ4 양자화 플러그인을 Apache-2.0으로 구분한다. 둘은 호환되지만 같은 라이선스는 아니라고 문서는 적는다.
릴리스 노트는 후원자가 PXA Control에서 라이선스가 적용되는 라이브러리를 업데이트·되돌리기 할 수 있다고 설명한다. 이 기사는 해당 라이브러리의 이용 조건을 감사하지 않았다.
여러 CPU 소켓이 있는 기계에서 전문가 캐시와 함께 Flash-Next를 컨테이너로 돌리려면 SYS_NICE 권한이 필요하다고 릴리스 노트는 밝힌다.
P100·V100 사용자가 확인할 순서
이미 P100이나 V100을 쓰고 있다면 원하는 모델의 PXA 팩이 있는지, 필요한 라이브러리가 배포 요건에 맞는지부터 확인하는 순서가 자연스럽다.
그다음 실제 산문 요청과 코드 요청을 따로 비교하면, 서로 다른 작업이 하나의 대표 속도로 섞이지 않는다.
특화 형식과 이식성 사이의 선택
여러 엔진을 오가는 환경에서는 일반 GGUF가 편하고, PXA의 최적화를 평가하려면 PXA 팩이 맞는 경로다. 어느 쪽도 새 팩이 모든 작업의 품질을 보존한다는 증거는 아니다.
PXA 3.1의 Overdrive 속도는 PXA 팩, 동봉 라이브러리, 보존된 전문가 맵이 함께 갖춰진 배포 구성의 결과다.