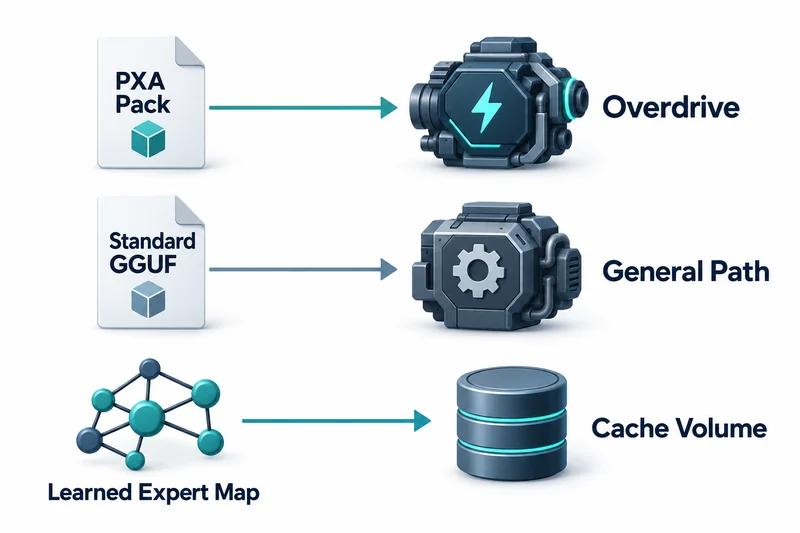
PXA v3.1が韓国時間10月11日(UTC 10月10日)に公開された。目玉はFlash-Nextモデル向けの速度設定であるOverdriveプリセットで、Tesla P100で調整し、V100や2枚構成でも速くなるという。
v3.1はv3と同じモデルファイルを使う。ただしOverdriveプリセットには、パッケージに同梱されたPXQNライブラリが必要だ。
ファイルの互換性と速度の最適化は別物
READMEはPXAを、Tesla P100、Tesla V100、GTX 1080 TiなどPascal・Volta世代のカード向けの言語モデルサーバーと紹介している。GPUコードはP100(sm_60)、1080 Ti・P40(sm_61)、V100(sm_70)を対象に、これらのカードが実際に持つ命令を使う。
Q4_K_MやQ8_0など通常のGGUF量子化も同じサーバーで読み込んで動く。ただしGPUコード、プランナー、速度表は、PXA独自のPXQ・PXQNファイルを中心に作られている。
使いながら学習するエキスパートマップ
混合エキスパート(MoE)モデルにはルーティングマップが同梱され、サーバーは利用状況から2つ目のマップを学習できる。学習したマップはセッション後に保存され、同梱マップより速いと測定されたときだけ使われ、再起動後も残る。
リリースノートによると、学習したマップは同梱マップより散文のデコードで約12%、コードのデコードで約18%速かった。Overdriveを有効にしたP100 1枚では、散文で約30.3 tok/s、コードで34.9 tok/sだった。
これらはv3.1のリリースビルドで、セッションの同じ時点に測ったプロジェクト自身の数値だ。独立したベンチマークではない。
Dockerの利用者は、キャッシュフォルダーを名前付きボリュームとしてマウントしないと、コンテナを削除したときに学習したマップが残らない。リリースノートが示すマウント引数は次のとおりだ。
-v pxa-cache:/work/.cache/pxa学習状態がバージョン比較に混ざる問題
学習したマップが残っていると、サーバーを再起動しても同じ出発点には戻らない。一方は学習したマップ、もう一方は同梱マップで動かすと、実行ファイルの差と適応の効果が混ざる。
バージョンを比べるときは、マップの状態を記録するか、初期状態のテストと適応後のテストを分ける方法がある。
注意点:構成要素ごとに異なるライセンス
リポジトリのライセンスマップは、ルートの推論エンジンをMIT、vLLM向けのPXQ4量子化プラグインをApache-2.0と区別している。両者は互換性があるが同じライセンスではない、と文書は記す。
リリースノートは、サポーターがPXA Controlからライセンス付きライブラリを更新・ロールバックできると説明している。この記事はそのライブラリの利用条件を監査していない。
リリースノートはまた、CPUソケットが複数ある機械でエキスパートキャッシュ付きのFlash-Nextをコンテナで動かすにはSYS_NICE権限が必要だとしている。
P100・V100の利用者が確かめる順序
すでにP100やV100を使っているなら、目的のモデルにPXAパックがあるか、必要なライブラリが配布の要件に合うかをまず確かめるのが自然な順序だ。
そのうえで実際の散文リクエストとコードリクエストを別々に比べれば、異なる作業が1つの代表速度に混ざらない。
特化形式と移植性のあいだの選択
複数のエンジンを行き来する環境では通常のGGUFが便利で、PXAの最適化を評価するならPXAパックが適した経路だ。どちらも、新しいパックがすべての作業で品質を保つ証拠にはならない。
PXA 3.1のOverdriveの速度は、PXAパック、同梱ライブラリ、保持されたエキスパートマップがそろった配布構成から生まれる結果だ。