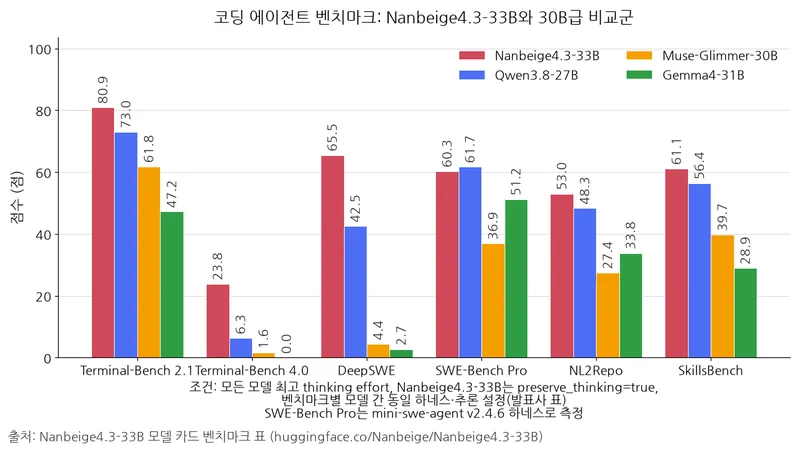
Nanbeige LLM Lab이 Hugging Face에 Nanbeige4.3-33B 가중치를 공개했다. 모델 API의 createdAt 값은 이 저장소의 생성 시각을 2026년 10월 24일로 기록한다. 이 생성 타임스탬프는 저장소가 만들어진 시점을 가리킬 뿐, 가중치가 처음 공개된 시점을 알려주지는 않는다. 최대 524,288토큰(512K) 컨텍스트를 지원해, 코드 에이전트와 사내 업무 자동화를 직접 돌릴 팀에 선택지가 하나 늘었다. 모델 카드는 20개 벤치마크 중 17개를 비교군 최고 점수로 표시했으며, 발표사는 30B급 오픈 가중치 모델 가운데 에이전트 성능이 앞선다고 밝혔다.
성능: 코드 에이전트 벤치마크에서 비교군을 앞섬
코딩 에이전트 벤치마크 8종 중 7종에서 비교군 최고점이었다. 표의 첫 두 시험에서는 각각 17.5점과 23.0점 앞섰지만, 세 번째 시험에서는 1.4점 뒤져 코딩 작업의 종류에 따라 우위가 달라졌다.
표: 대표 코딩 에이전트 성능
조건: 발표사 모델 카드 기준. 모든 모델은 최고 추론 강도로 평가했으며, 시험별로 모델 간 동일 하네스·추론 설정을 사용했다. Nanbeige4.3-33B는 preserve_thinking=true로 평가했다. 이 표에서 mini-swe-agent v2.4.6 조건은 원문에 명시된 Terminal-Bench 4.0과 DeepSWE에만 적용했다.
| 벤치마크 | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 4.0 | 23.8 | 6.3 |
| DeepSWE | 65.5 | 42.5 |
| SWE-Bench Pro | 60.3 | 61.7 |
단위: 점수(높을수록 좋음)
업무 자동화 쪽 9종에서도 8종이 비교군 최고점이었다. 공개 과제 600개 평가뿐 아니라 35개 직업을 다룬 평가에서도 대부분의 직업에서 비교 기준 모델을 앞섰다.
표: 업무 자동화 대표 결과
조건: 발표사 모델 카드의 평가. Automation Bench v1.0.6은 공개 과제 600개, JobBench는 Claude Code 하네스에 검색 도구를 장착해 35개 직업을 평가했다. YC-bench는 매 모델 호출 직전 사용자 대화의 최근 10턴만 과거 문맥으로 유지했다.
단위: 점수, YC-bench만 달러($)
| 벤치마크 | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Automation Bench v1.0.6 | 54.2 | 38.3 |
| JobBench | 44.8 | 34.5 |
| YC-bench | $1,025,437 | $641,290 |
추론 평가에서는 GPQA Diamond가 89.5점으로 Gemma4-31B의 91.3점보다 낮았고, AIME 2026은 95.2점으로 Qwen3.8-27B의 94.5점을 앞섰다. 업무 자동화의 폭넓은 우위와 달리 추론은 평가에 따라 비교 우위가 갈렸다.
직접 배포
가중치는 Apache-2.0이며, 카드의 실행 예시는 직접 호스팅을 전제로 한다. vLLM과 SGLang 예시는 텐서 병렬 4, GPU 네 개를 하나의 모델로 묶는 설정이다. GitHub의 Nanbeige 조직은 llama.cpp, sglang, vllm, ollama 포크, 기존 코드를 복사해 별도로 개발한 판본을 공개하고 있다.
어디에 쓰나: 33B 교사 모델에서 소형 모델로
직전 소형 모델 Nanbeige4.2-3B의 컨텍스트는 256K였지만 이번 33B 모델은 512K를 지원한다. 발표사는 Nanbeige4.3-33B를 소형 모델 학습을 이끄는 교사 모델로 설계했다고 밝혔다. 에이전트 동작을 증류해 소형 모델로 옮기는 계획의 토대이며, Nanbeige4.3-3B가 다음 타깃으로 언급돼 있다.
베이스 모델, 추가 학습 전 기본 모델인 Nanbeige4.3-33B-Base도 공개됐다. 베이스 모델 카드에 따르면 이 베이스 모델은 MMLU-Pro 66.9, GPQA 62.0으로 Gemma4-31B-Base의 59.3, 41.5를 앞선다.
써 보려면
모델 카드의 채팅 템플릿이 스위치를 세 개 준다. enable_thinking은 기본값으로 켜져 있고, preserve_thinking은 이전 응답의 추론을 대화 기록에 유지하는 옵션이다. 일반 대화·질의응답에서는 끄고, 다단계 도구 사용·사무 작업·코드 에이전트에서는 켤 것을 권장한다. 도구 호출 포맷은 xml을 권장하고 json도 지원한다. 기본 시스템 프롬프트, 모델에 기본 지시를 주는 입력 문구가 중국어라, 시스템 메시지를 직접 넣어 언어를 정하는 편이 낫다.
권장 추론 설정은 도구 작업에서 temperature 1.0·top_p 0.95·최대 신규 토큰 65,536, 추론·대화에서 0.6·0.95·262,144다. 입력과 대화 기록을 다루는 최대 컨텍스트 524,288토큰과 달리, 최대 신규 토큰은 새로 생성할 출력의 한도다. 도구 작업의 권장 출력 한도는 추론·대화의 4분의 1이다.
vllm serve Nanbeige/Nanbeige4.3-33B \
  --tensor-parallel-size 4 \
  --enable-auto-tool-choice \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder
한계
발표사 평가에서 개정 루브릭, 평가 항목과 채점 기준표로 채점한 GDPval은 Qwen3.8-27B가 앞섰고, Terminal-Bench 4.0은 절대 점수가 낮다.
이번 공개는 소형 에이전트 증류를 위한 교사 모델 전략이며, 도입 판단의 초점은 일반 추론 순위보다 다단계 도구·코딩 작업 적합성에 있다.