Nanbeige LLM LabはHugging FaceでNanbeige4.3-33Bのウェイトを公開した。モデルAPIのcreatedAtが示すリポジトリの作成日時は2026年10月24日だ。この作成タイムスタンプはリポジトリの作成時点を示すだけで、ウェイトが初めて公開された時点を証明するものではない。最大524,288トークン(512K)のコンテキストに対応し、コードエージェントや社内業務の自動化を自ら運用するチームに選択肢が1つ増えた。モデルカードは20のベンチマーク中17を比較対象の最高スコアとし、発表元は30B級のオープンウェイトモデルの中でエージェント性能が優れると述べた。
性能:コードエージェントのベンチマークで比較対象を上回る
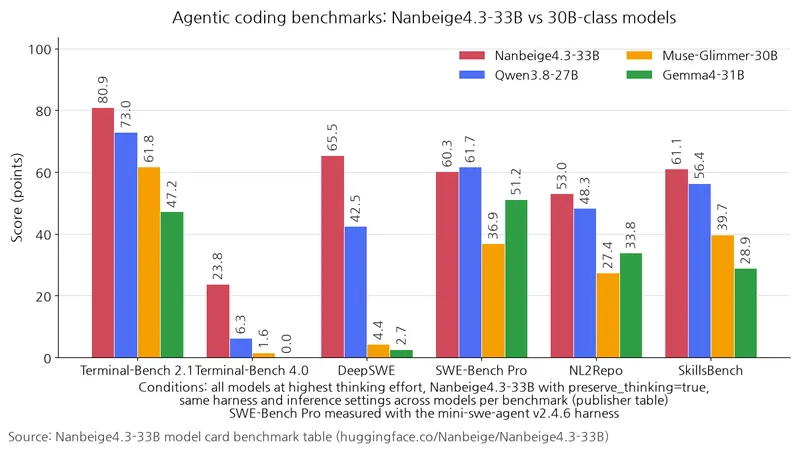
コーディングエージェントのベンチマーク8種中7種で、比較対象の最高スコアだった。表の最初の2試験ではそれぞれ17.5点と23.0点上回ったが、3番目の試験では1.4点下回り、コーディング作業の種類によって優位性が異なった。
表:代表的なコーディングエージェント性能
条件:発表元のモデルカードに基づく。全モデルを最高の推論強度で評価し、試験ごとにモデル間で同一のハーネス・推論設定を使用した。Nanbeige4.3-33Bはpreserve_thinking=trueで評価した。この表のmini-swe-agent v2.4.6の条件は、原文に明記されたTerminal-Bench 4.0とDeepSWEにのみ適用した。
| ベンチマーク | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 4.0 | 23.8 | 6.3 |
| DeepSWE | 65.5 | 42.5 |
| SWE-Bench Pro | 60.3 | 61.7 |
単位:スコア(高いほど良い)
業務自動化の9種でも8種が比較対象の最高スコアだった。公開タスク600件の評価だけでなく、35の職業を扱った評価でも、ほとんどの職業で比較基準モデルを上回った。
表:業務自動化の代表的な結果
条件:発表元のモデルカードによる評価。Automation Bench v1.0.6は公開タスク600件、JobBenchはClaude Codeハーネスに検索ツールを組み込み、35の職業を評価した。YC-benchは各モデル呼び出しの直前に、ユーザーとの対話の直近10ターンだけを過去の文脈として保持した。
単位:スコア、YC-benchのみドル($)
| ベンチマーク | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Automation Bench v1.0.6 | 54.2 | 38.3 |
| JobBench | 44.8 | 34.5 |
| YC-bench | $1,025,437 | $641,290 |
推論評価では、GPQA Diamondが89.5点でGemma4-31Bの91.3点を下回り、AIME 2026は95.2点でQwen3.8-27Bの94.5点を上回った。業務自動化での幅広い優位性とは異なり、推論では評価によって優劣が分かれた。
自前でのデプロイ
ウェイトのライセンスはApache-2.0で、カードの実行例はセルフホスティングを前提とする。vLLMとSGLangの例はテンソル並列4で、GPU4台を1つのモデルにまとめる設定だ。GitHubのNanbeige組織は、llama.cpp、sglang、vllm、ollamaのフォーク、つまり既存コードをコピーして別途開発した版を公開している。
用途:33B教師モデルから小型モデルへ
直前の小型モデルNanbeige4.2-3Bのコンテキストは256Kだったが、今回の33Bモデルは512Kに対応する。発表元は、Nanbeige4.3-33Bを小型モデルの学習を導く教師モデルとして設計したと述べた。エージェントの動作を蒸留して小型モデルに移す計画の土台であり、Nanbeige4.3-3Bが次の対象として挙げられている。
追加学習前の基本モデルであるベースモデル、Nanbeige4.3-33B-Baseも公開された。ベースモデルカードによると、このベースモデルはMMLU-Pro 66.9、GPQA 62.0で、Gemma4-31B-Baseの59.3、41.5を上回る。
試すには
モデルカードのチャットテンプレートには3つのスイッチがある。enable_thinkingはデフォルトで有効で、preserve_thinkingは過去の応答の推論を対話履歴に保持するオプションだ。一般的な対話・質疑応答では無効にし、多段階のツール利用・事務作業・コードエージェントでは有効にすることを推奨する。ツール呼び出し形式はxmlを推奨し、jsonにも対応する。モデルに基本指示を与える入力文であるデフォルトのシステムプロンプトが中国語のため、システムメッセージを自ら設定して言語を指定するほうがよい。
推奨推論設定は、ツール作業でtemperature 1.0・top_p 0.95・最大新規トークン65,536、推論・対話では0.6・0.95・262,144だ。入力と対話履歴を扱う最大コンテキスト524,288トークンとは異なり、最大新規トークンは新たに生成する出力の上限だ。ツール作業の推奨出力上限は、推論・対話の4分の1である。
vllm serve Nanbeige/Nanbeige4.3-33B \
  --tensor-parallel-size 4 \
  --enable-auto-tool-choice \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder
限界
発表元の評価で、評価項目と採点基準を示す改訂版ルーブリックを用いて採点したGDPvalではQwen3.8-27Bが上回り、Terminal-Bench 4.0は絶対スコアが低い。
今回の公開は、小型エージェントへの蒸留に向けた教師モデル戦略であり、導入判断の焦点は、一般的な推論の順位よりも多段階のツール利用・コーディング作業への適性にある。