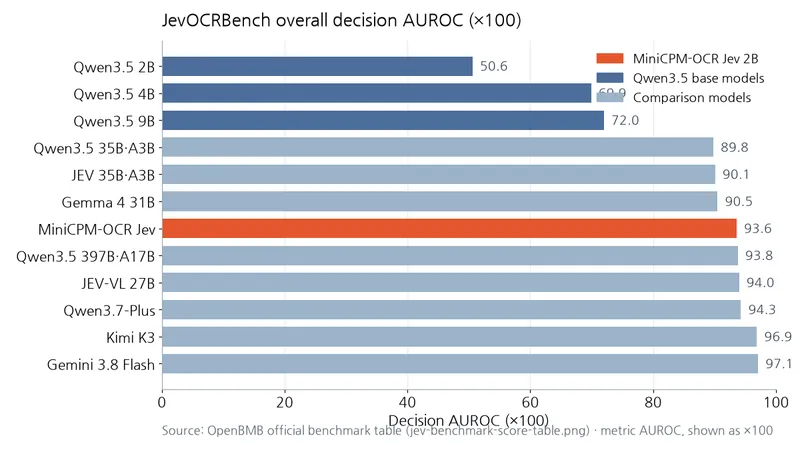
OpenBMB 于 2026 年 10 月 27 日发布了用于判定现有 OCR 结果的 2B 模型 MiniCPM-OCR Jev。它针对文本、公式和表格区域,为候选识别结果的正确性给出 0~1 的分数,用于缩小人工审核范围或从多个候选中选出一个。
结果
据 OpenBMB 的模型指南,MiniCPM-OCR Jev 在 JevOCRBench 上衡量正误区分能力的 AUROC 的 100 倍值为 93.6。这种做法是在现有 OCR 后接入小型 2B 模型,辅助审核与候选重选。下方两表将官方 PNG 中的公布值分为 Jev 系列与通用模型列出。
另一份官方 SVG 将 Jev 系列标为“Noul”设置(无详细说明),通用模型则使用判定标准指令,因此比较系列间分差时也需考虑评估设置。SVG 中 MiniCPM 一行的数值为 93.5·94.5·93.1·91.0,与 PNG 不同,下表仅采用 PNG 数值。
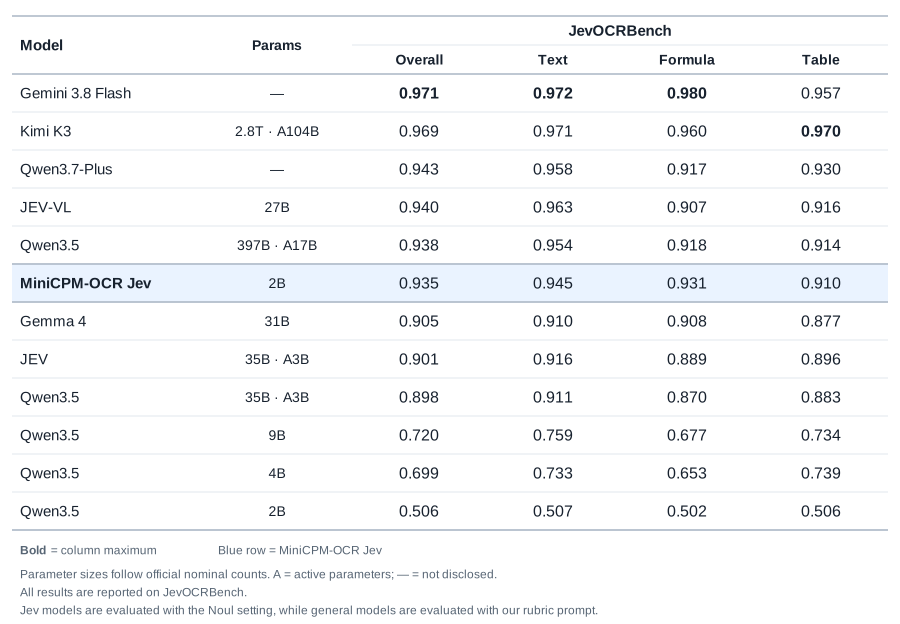
参数标记中,B 表示 10 亿,A 表示实际激活的参数量。
表:JevOCRBench 整体及各类别判定性能 — Jev 系列
条件:JevOCRBench 2,267 条,OpenBMB 官方 PNG 公布值
单位:AUROC 的 100 倍值
| 模型 | 参数量 | 整体 | 文本 | 公式 | 表格 |
|---|---|---|---|---|---|
| JEV 35B·A3B | 35B·A3B | 90.1 | 91.6 | 88.9 | 89.6 |
| MiniCPM-OCR Jev | 2B | 93.6 | 94.6 | 93.1 | 91.1 |
| JEV-VL 27B | 27B | 94.0 | 96.3 | 90.7 | 91.6 |
表:JevOCRBench 整体及各类别判定性能 — 通用模型
条件:JevOCRBench 2,267 条,OpenBMB 官方 PNG 公布值
单位:AUROC 的 100 倍值
| 模型 | 参数量 | 整体 | 文本 | 公式 | 表格 |
|---|---|---|---|---|---|
| Qwen3.5 2B | 2B | 50.6 | 50.7 | 50.2 | 50.6 |
| Qwen3.5 4B | 4B | 69.9 | 73.3 | 65.3 | 73.9 |
| Qwen3.5 9B | 9B | 72.0 | 75.9 | 67.7 | 73.4 |
| Qwen3.5 35B·A3B | 35B·A3B | 89.8 | 91.1 | 87.0 | 88.3 |
| Gemma 4 31B | 31B | 90.5 | 91.0 | 90.8 | 87.7 |
| Qwen3.5 397B·A17B | 397B·A17B | 93.8 | 95.4 | 91.8 | 91.4 |
| Qwen3.7-Plus | 未公开 | 94.3 | 95.8 | 91.7 | 93.0 |
| Kimi K3 | 2.8T·A104B | 96.9 | 97.1 | 96.0 | 97.0 |
| Gemini 3.8 Flash | 未公开 | 97.1 | 97.2 | 98.0 | 95.7 |
在公布值中,MiniCPM-OCR Jev 超过了 JEV-35B-A3B 的 90.1,比 Qwen3.5-397B-A17B 的 93.8 低 0.2 分。额外训练前的基础模型 Qwen3.5-2B 为 50.6。分类别看,MiniCPM-OCR Jev 在文本上最高,在表格上最低。
测量方法
评估使用 OpenBMB 构建的 JevOCRBench 数据集。其中有中英文数据 2,267 条,文本占 47.7%、公式占 24.7%、表格占 27.6%,每条记录包含原始区域图像、候选文本、候选渲染图像和人工正误标注。错误候选取自顶尖 OCR 模型的实际错误输出,并由人工标注。评分输入固定为原始区域图像 → 候选文本 → 候选文本渲染图像这三项,指标为衡量正误区分能力的 AUROC。
OpenBMB 的解析器交叉评估 表明,即使更换将 OCR 结果结构化的解析器,判定性能也没有明显波动。实验对从 JevOCRBench 随机抽取的同一组 200 个样本分别运行四种解析器,再由人工标注正误。
表:各解析器的判定性能
条件:从 JevOCRBench 随机抽取的同一组 200 个样本,四种解析器独立运行,OpenBMB 自行评估
单位:AUROC 的 100 倍值
| 候选解析器 | MiniCPM-OCR 1.0 | GLM-OCR | PaddleOCR-VL-1.6 | Xiaomi-OCR-0 |
|---|---|---|---|---|
| AUROC 的 100 倍值 | 92.7 | 91.9 | 93.4 | 93.1 |
四种解析器的结果差距在 1.5 分以内。
为何存在这些差异
MiniCPM-OCR Jev 基于 Qwen3.5-2B 训练,保留了将图像转换为特征的视觉编码器,以及负责语言处理的核心神经网络——语言骨干网络,同时将 lm_head 替换为仅区分正确与错误的二分类头。
评分流程分为预检查 → 候选文本渲染 → 模型计算这 3 个阶段,预检查会验证公式块的 LaTeX 语法。其方式是将候选渲染为图像,与原始区域图像并排比较。OpenBMB 部署文档 说明,渲染阶段将候选文本绘制成图像,使模型能够观察布局。
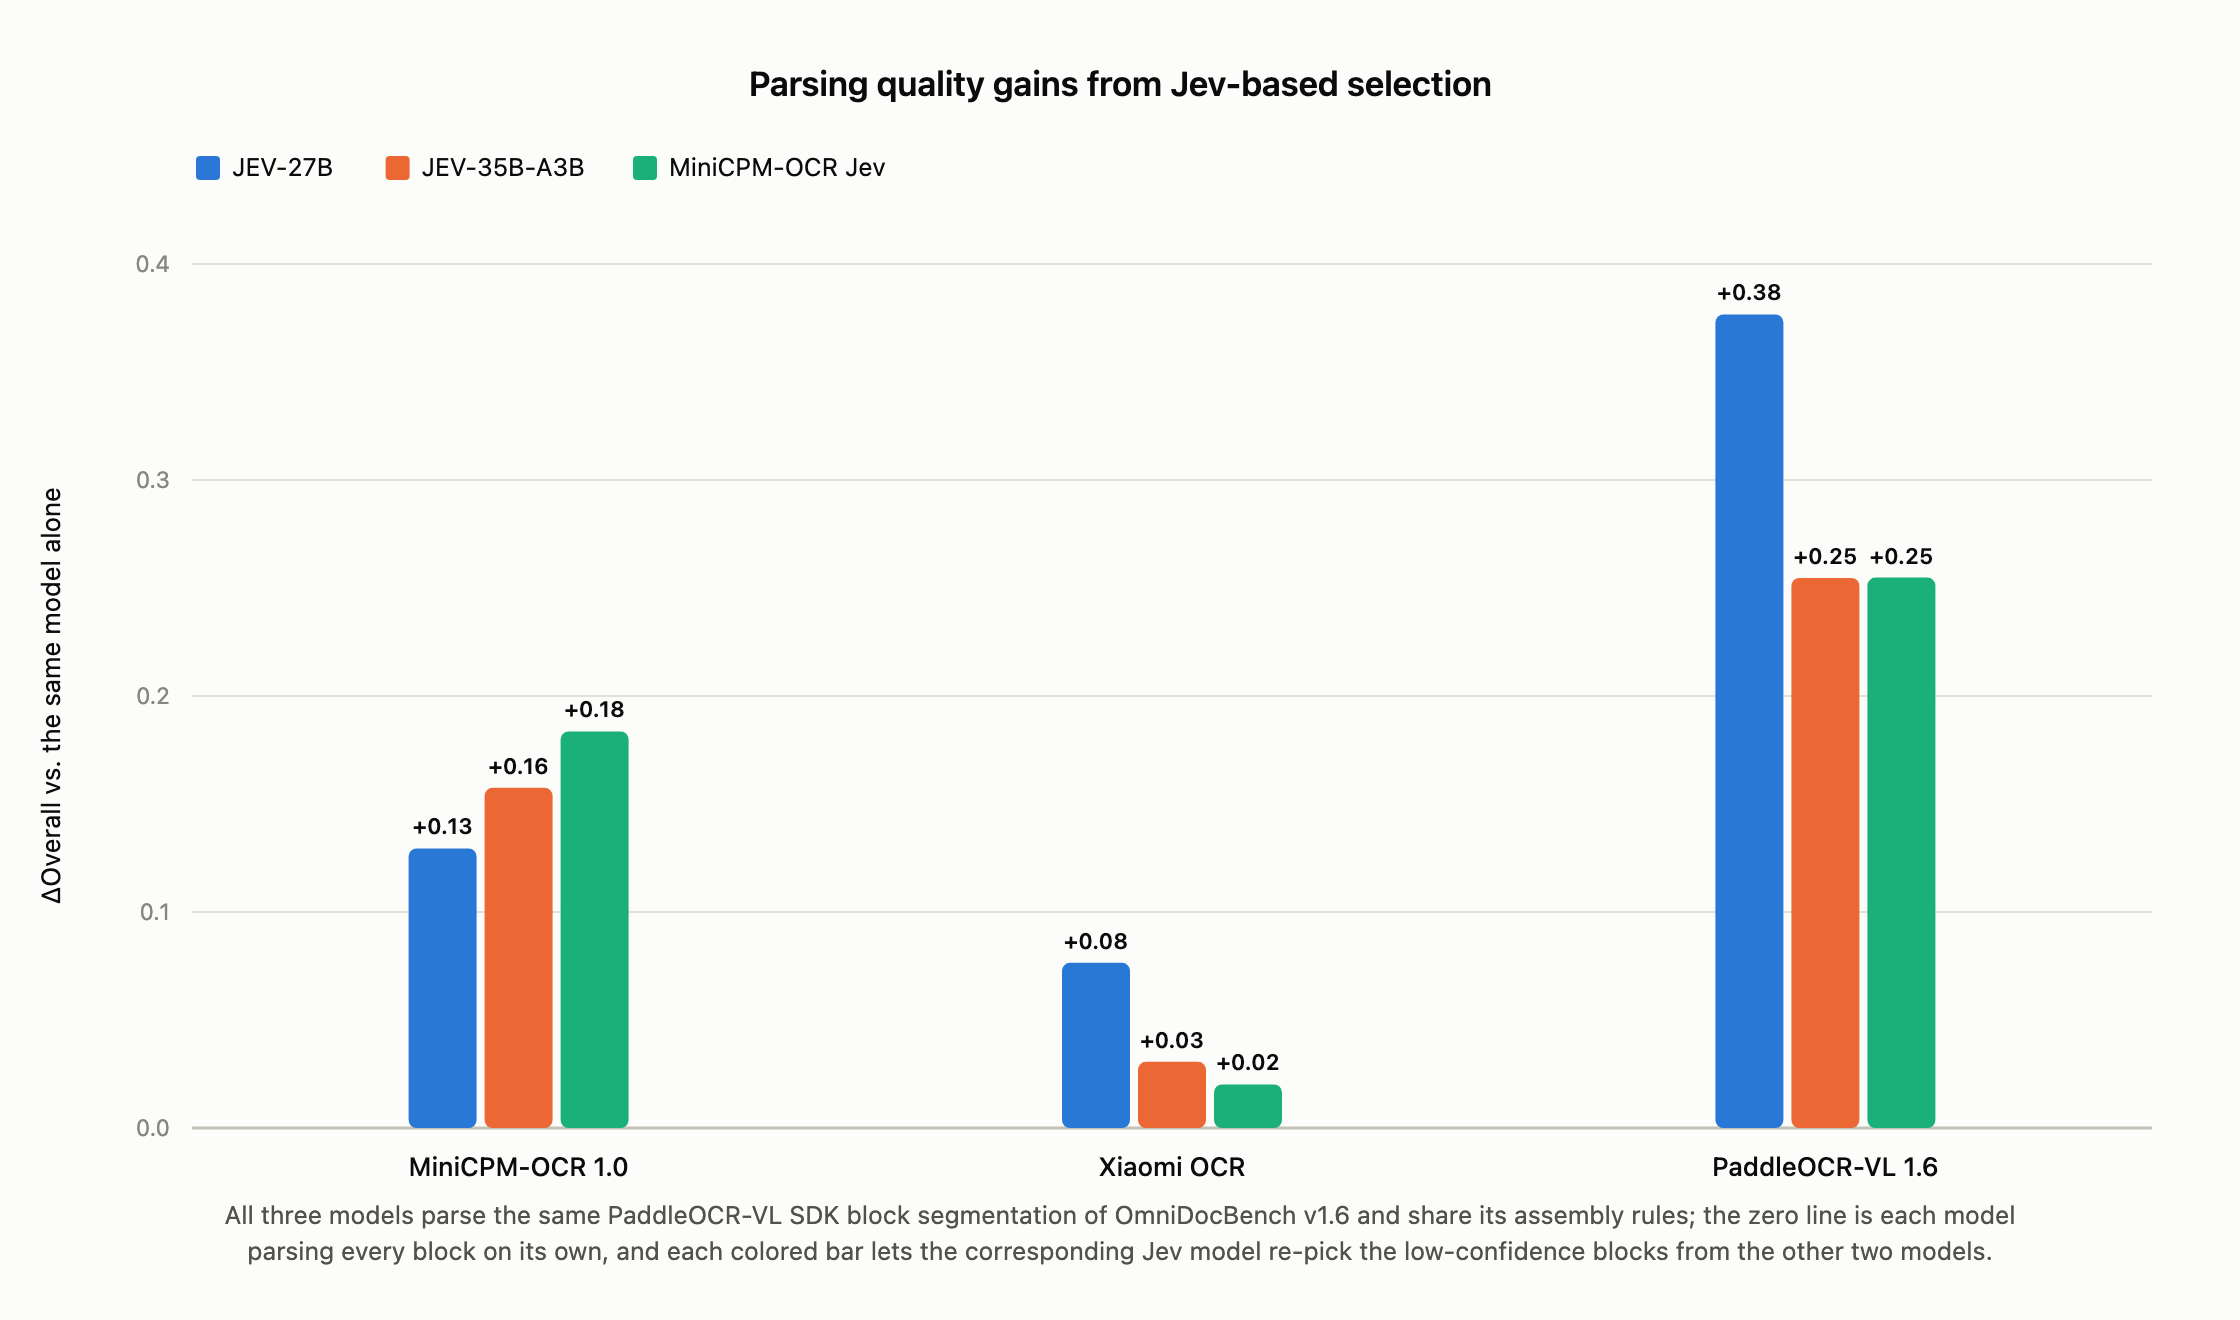
据 OpenBMB 公布的数据,采用相同方式划分文档区域并重选候选后,解析质量优于各解析器单独处理的结果。MiniCPM-OCR Jev 对 MiniCPM-OCR 1.0、Xiaomi OCR、PaddleOCR-VL 1.6 的提升分别为 0.18 分、0.02 分和 0.25 分。这 +0.02~+0.25 分是文档解析总分的提升量,而非判定 AUROC。即使接入同一个判定模型,各解析器的收益也不一致。
表:Jev 候选重选带来的解析质量提升
条件:三种解析器共用 OmniDocBench v1.6 的 PaddleOCR-VL SDK 分块与组装规则,以各解析器单独处理为基线,从另外两个模型的候选中为低置信度块重新选择结果,见 OpenBMB 官方图
单位:提升分数
| 解析器组 | JEV-27B | JEV-35B-A3B | MiniCPM-OCR Jev |
|---|---|---|---|
| MiniCPM-OCR 1.0 | 0.13 | 0.16 | 0.18 |
| Xiaomi OCR | 0.08 | 0.03 | 0.02 |
| PaddleOCR-VL 1.6 | 0.38 | 0.25 | 0.25 |
选择标准
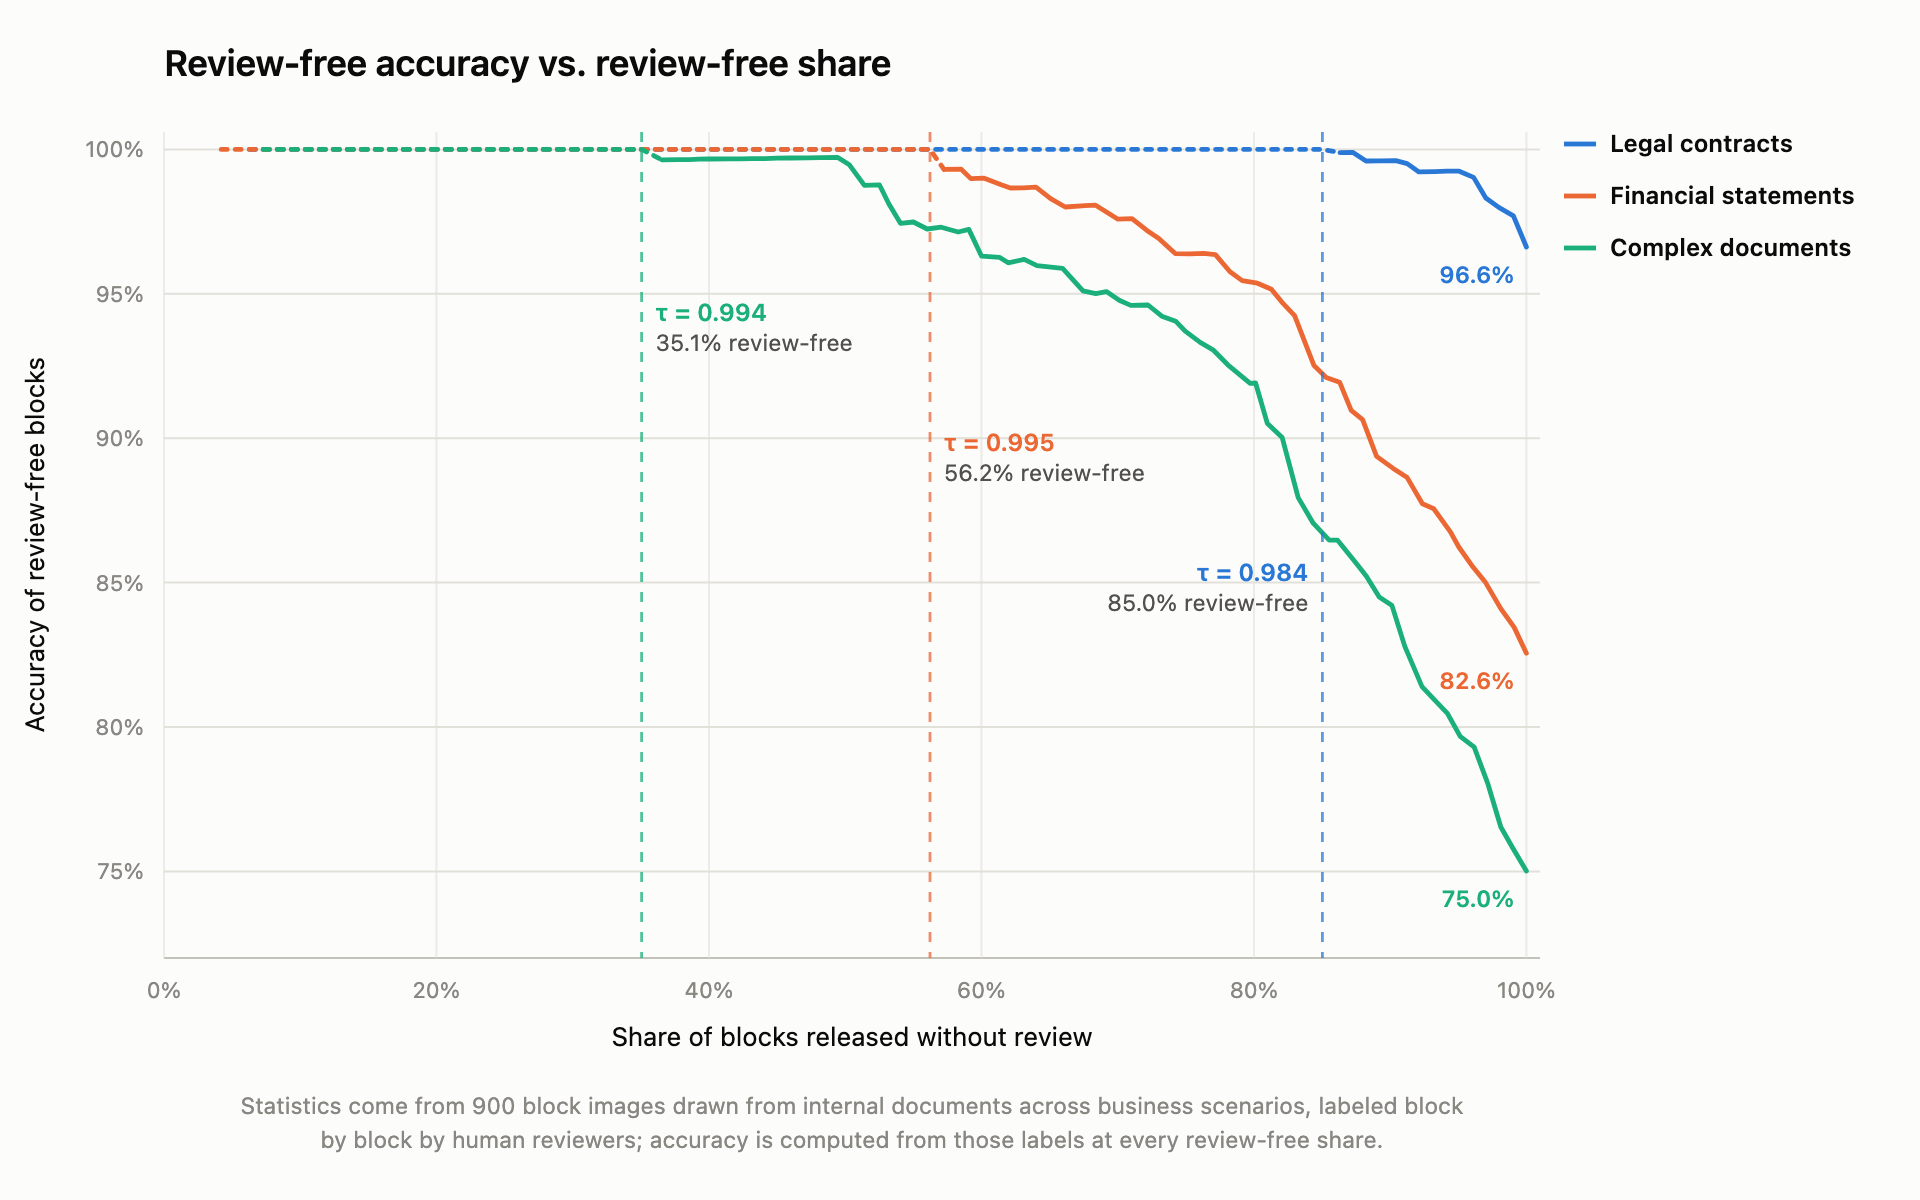
自动通过的阈值应基于自身数据的人工标注,同时检查通过比例与准确率后确定。官方示例图 对内部文档中抽取的 900 张块图像进行人工标注,计算不同免审核通过比例下的准确率。图中法律合同在阈值 0.984 时的免审核通过比例为 85.0%,财务报表在 0.995 时为 56.2%,混合文档在 0.994 时为 35.1%。
若要自行运行,根据官方 Docker/SDK 本地部署指南,需要显存至少 12GB 的 NVIDIA GPU 和 535 及以上版本的驱动。磁盘空间方面,模型计算环境约需 5~9GB,渲染环境约需 1.5GB,权重约需 2.5GB。
若计划将分数绝对值与公开数值直接比较,应使用 Docker 镜像。据 OpenBMB 部署文档,Docker 镜像的渲染与云端 API 相同,而自行安装的 SDK 渲染器虽保持分数排序,绝对值却可能略有差异。
查看响应时,先确认 verdict(判定状态)是否为 scored,并将 0.0 和 -1.0 视为评分失败时的固定值。
category 必须与实际块类型一致。
以下是将部署文档中的单次评分请求改写为 Python 的示例,适用于本地服务已运行且 block.png 为对应文本区域图像的情况。
import base64
from pathlib import Path
import requests

response = requests.post("http://127.0.0.1:8030/v1/rm/score", json={
    "input_form": "ternary",
    "items": [{"case_id": "blk-001", "category": "text",
               "image": base64.b64encode(Path("block.png").read_bytes()).decode(),
               "ocr_text": "the OCR text to be scored"}]
})
response.raise_for_status()
result = response.json()["results"][0]
if result["verdict"] == "scored":
    print(result["prob_yes"])
else:
    print("Scoring failed:", result["verdict"])
部署完成后,将 3 个示例的分数与基准分数比较,确认差值是否在 0.02 以内即可。
候选重选的最终质量取决于现有候选的范围与准确性。
权重与代码以 Apache License 2.0 公开,并提供原始权重和量化权重。部署支持云端 API、Docker 和 SDK。
小型判定模型可以作为辅助审核和重选现有候选的环节,而不是重新执行 OCR。