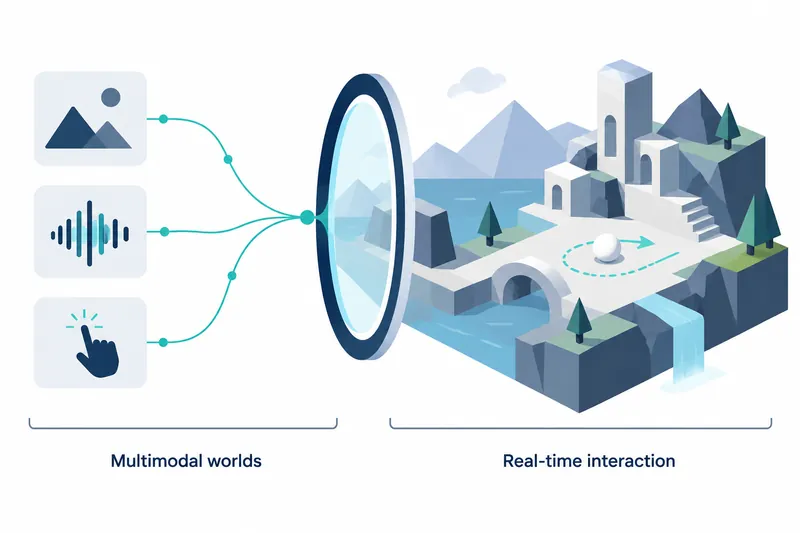
谷歌 DeepMind 推出了世界模拟模型 Genie 4,能够实时延续生成可供用户移动探索、通过文本改变的场景。它在同一个世界中生成声音和对话,让创作者与开发者探索场景,或将创意转化为可交互的模拟进行测试。目前,该模型处于面向可信测试者的研究预览阶段。
1. 同时生成场景、声音与对话的世界
Genie 4 不仅生成画面,还会与场景同步生成环境音和人物话语。它会添加林间风声或海边波涛等符合地点的声音,角色则会回应用户输入或世界中的事件,继续对话。谷歌 DeepMind 将其介绍为原生支持实时声音生成的世界模型。
用户可通过标准键盘控制移动和摄像机,并用文本指示场景变化。用户可以改变天气,或让新的人物与物体出现,模型则会调整场景进程,使场景在两次输入之间持续发展。公开的提示词示例如下。
Prompt: A macro close up of a maple seed falling from the tree into the grass据谷歌 DeepMind 介绍,Gemini Omni 以现实世界的外观和行为作为模拟基准,其他 Gemini 模型则提供推理能力,维持场景的一致性与连续性。公司强调的功能包括实时操控、逼真的物理效果与人物动作、声音与对话,以及多阶段事件模拟。
2. 实时操控物理效果与人物动作
公司表示,模型能够处理空气动力学这一研究空气流动与力的领域,以及碰撞等物理情境,并呈现人物对环境作出反应时的自然动作。用户可以在观察场景的同时移动摄像机,或添加人物和物体。公开示例包括 1980 年代日本拥挤的火车站,以及从树上飘落的枫树种子。
处理复杂目标时,Gemini 模型会作为操控智能体参与,即代为执行目标的软件。据公司介绍,Gemini 3.8 Flash 会观察正在生成的场景,将目标拆分为多个步骤,再查看传入画面,确认各步骤的进展。当用户介入或世界发生变化时,它也会实时修改计划。
在机器人相关实验中,Gemini 4 Argon 会将用户的任务指令拆分为多个步骤,再以文本描述传递给 Genie 4。谷歌 DeepMind 展示了 Apptronik 的 Apollo 人形机器人下西洋跳棋的模拟案例。这与构建练习环境的方向相契合,让机器人和智能体在应用于现实之前演练多种情境。
3. 加快创作与开发的早期试验
可信测试者包括创作、新闻、教育、游戏和工程领域的参与者。电影制作人可以改变场景的机位、照明、台词与动作,进行多种尝试;摄影记者则在测试将纪实照片扩展为环境模拟的方式。游戏开发者可在编写作为游戏运行基础程序的引擎代码之前,将创意制作成可探索的原型;企业合作伙伴则在考察其用于情境生成的可能性。
这种方式的优势是减少场景创建与修改的反复,将创意转化为可体验的模拟。但模拟时间变长,或多次复杂修改提示词时,视觉细节和物体的持续存在可能发生变化。复杂物理交互、实时音频准确性、可读文字、空间准确性,即位置和距离表达的精度,以及长期一致性,即场景随时间保持稳定的程度,仍在研究中。
4. 从可信测试者开始的预览
谷歌 DeepMind 已向可信测试者开放 Genie 4 研究预览版,计划在扩大至消费者和开发者之前收集反馈。公司表示,下一批开放对象是 Project Genie 的 Google AI Ultra 订阅用户,以及 Gemini API 和 Google AI Studio 的早期访问合作伙伴。Project Genie 也设有候补名单。
公司表示,已提前开展内部安全评估,并采用符合安全政策的防护措施。所有生成的视频和音频都会加入 SynthID 水印,这是一种帮助识别 AI 生成内容、确认内容来源的标记。公司提出的未来方向是混合世界模型,将语言模型与代码的逻辑推理同像素级模拟的感官表达结合起来。
Genie 4 的核心价值在于让画面、声音与交互能够一并测试,而提升长时间模拟的一致性是下一项课题。