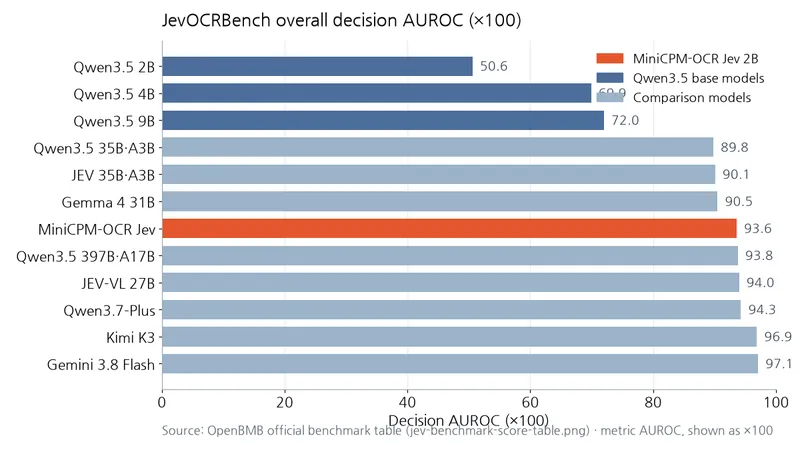
OpenBMBは2026年10月27日、既存のOCR結果を判定する2BモデルMiniCPM-OCR Jevを公開した。テキスト・数式・表の領域ごとに候補の認識結果が正しいかを0~1で採点する。人が確認する領域を絞り込んだり、複数候補から一つを選んだりするために使う。
結果
OpenBMBのモデルガイドによると、MiniCPM-OCR JevはJevOCRBenchで正誤を区別する能力を示すAUROCの100倍値で93.6を記録した。小型の2Bモデルを既存OCRの後段に加え、確認と候補再選択を支援する方式だ。以下の二つの表は、公式PNGの発表値をJev系と一般モデルに分けて転記した。
別の公式SVGでは、Jev系は「Noul」設定(詳細説明なし)、一般モデルは判定基準の指示文を使用すると区別している。そのため、系列間のスコア差には評価設定も考慮すべきだ。SVGのMiniCPM行は93.5・94.5・93.1・91.0とPNGとは異なり、以下の表にはPNGの数値のみを転記した。
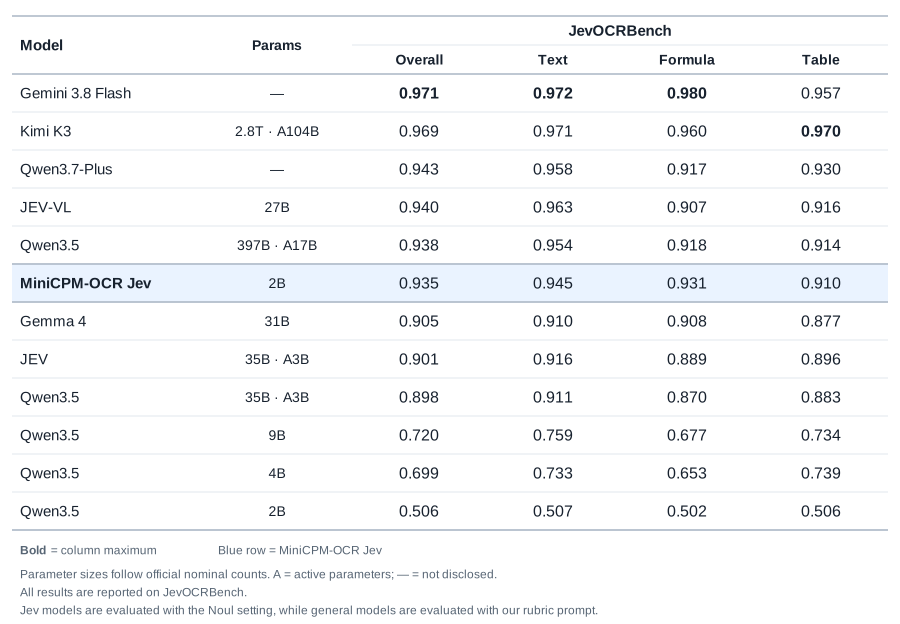
パラメーター表記では、Bは10億単位、Aは実際に有効化されるパラメーター数を意味する。
表:JevOCRBenchの全体・カテゴリー別判定性能 — Jev系
条件:JevOCRBench 2,267件、OpenBMB公式PNGの発表値
単位:AUROCの100倍値
| モデル | パラメーター | 全体 | テキスト | 数式 | 表 |
|---|---|---|---|---|---|
| JEV 35B·A3B | 35B·A3B | 90.1 | 91.6 | 88.9 | 89.6 |
| MiniCPM-OCR Jev | 2B | 93.6 | 94.6 | 93.1 | 91.1 |
| JEV-VL 27B | 27B | 94.0 | 96.3 | 90.7 | 91.6 |
表:JevOCRBenchの全体・カテゴリー別判定性能 — 一般モデル
条件:JevOCRBench 2,267件、OpenBMB公式PNGの発表値
単位:AUROCの100倍値
| モデル | パラメーター | 全体 | テキスト | 数式 | 表 |
|---|---|---|---|---|---|
| Qwen3.5 2B | 2B | 50.6 | 50.7 | 50.2 | 50.6 |
| Qwen3.5 4B | 4B | 69.9 | 73.3 | 65.3 | 73.9 |
| Qwen3.5 9B | 9B | 72.0 | 75.9 | 67.7 | 73.4 |
| Qwen3.5 35B·A3B | 35B·A3B | 89.8 | 91.1 | 87.0 | 88.3 |
| Gemma 4 31B | 31B | 90.5 | 91.0 | 90.8 | 87.7 |
| Qwen3.5 397B·A17B | 397B·A17B | 93.8 | 95.4 | 91.8 | 91.4 |
| Qwen3.7-Plus | 非公開 | 94.3 | 95.8 | 91.7 | 93.0 |
| Kimi K3 | 2.8T·A104B | 96.9 | 97.1 | 96.0 | 97.0 |
| Gemini 3.8 Flash | 非公開 | 97.1 | 97.2 | 98.0 | 95.7 |
発表値ではMiniCPM-OCR JevはJEV-35B-A3Bの90.1を上回り、Qwen3.5-397B-A17Bの93.8には0.2点及ばなかった。追加学習前のベースモデルQwen3.5-2Bは50.6だった。カテゴリー別では、MiniCPM-OCR Jevはテキストで最も高く、表で最も低かった。
測定方法
評価はOpenBMBが作成したJevOCRBenchデータセットで行われた。中国語と英語の2,267件は、テキスト47.7%、数式24.7%、表27.6%で構成される。各レコードには元の領域画像、候補テキスト、候補を描画した画像、人手による正誤ラベルが含まれる。誤答候補は最上位クラスのOCRモデルの実際の誤出力から抽出し、人手でラベルを付けた。採点入力は、元の領域画像 → 候補テキスト → 候補テキストを描画した画像の三つに固定され、指標は正答と誤答を区別する能力であるAUROCだ。
OpenBMBのパーサー横断評価では、OCR結果を構造化するツールであるパーサーを変えても判定性能は大きく変動しなかった。JevOCRBenchから無作為に抽出した同じ200サンプルに四つのパーサーをそれぞれ適用し、人手で正誤ラベルを付けた実験だ。
表:パーサー別判定性能
条件:JevOCRBenchから無作為に抽出した同じ200サンプル、四つのパーサーを独立実行、OpenBMBによる自社評価
単位:AUROCの100倍値
| 候補パーサー | MiniCPM-OCR 1.0 | GLM-OCR | PaddleOCR-VL-1.6 | Xiaomi-OCR-0 |
|---|---|---|---|---|
| AUROCの100倍値 | 92.7 | 91.9 | 93.4 | 93.1 |
四つのパーサーの結果の差は1.5点の幅に収まった。
なぜこのような差が生じるのか
MiniCPM-OCR JevはQwen3.5-2Bを基に学習した。画像を特徴量に変換するビジョンエンコーダーと、言語処理を担う中核のニューラルネットワークである言語バックボーンは残し、lm_headを正答と誤答だけを区別する二値分類ヘッドに置き換えた。
採点手順は事前検査 → 候補テキストのレンダリング → モデル計算の3段階で、事前検査では数式ブロックのLaTeX構文を検証する。候補を画像として描き、元の領域画像と並べて比較する方式だ。OpenBMBのデプロイ文書は、レンダリング段階で候補テキストを画像化し、モデルがレイアウトを見られるようにすると説明している。
OpenBMBの発表では、同じ方法で文書領域を分割して候補を選び直すと、各パーサーの単独処理結果より解析品質が向上した。MiniCPM-OCR Jevによる改善幅は、MiniCPM-OCR 1.0で0.18点、Xiaomi OCRで0.02点、PaddleOCR-VL 1.6で0.25点と異なった。この+0.02~+0.25点は判定AUROCではなく、文書解析の総合スコアの改善量だ。同じ判定モデルを追加しても、パーサーごとの効果は一様ではなかった。
表:Jevによる候補再選択での解析品質の改善
条件:三つのパーサーでOmniDocBench v1.6のPaddleOCR-VL SDKのブロック分割・組み立て規則を共有。各パーサーの単独処理をベースラインとし、他の二つのモデルの候補から低信頼ブロックを再選択した結果。OpenBMB公式図。
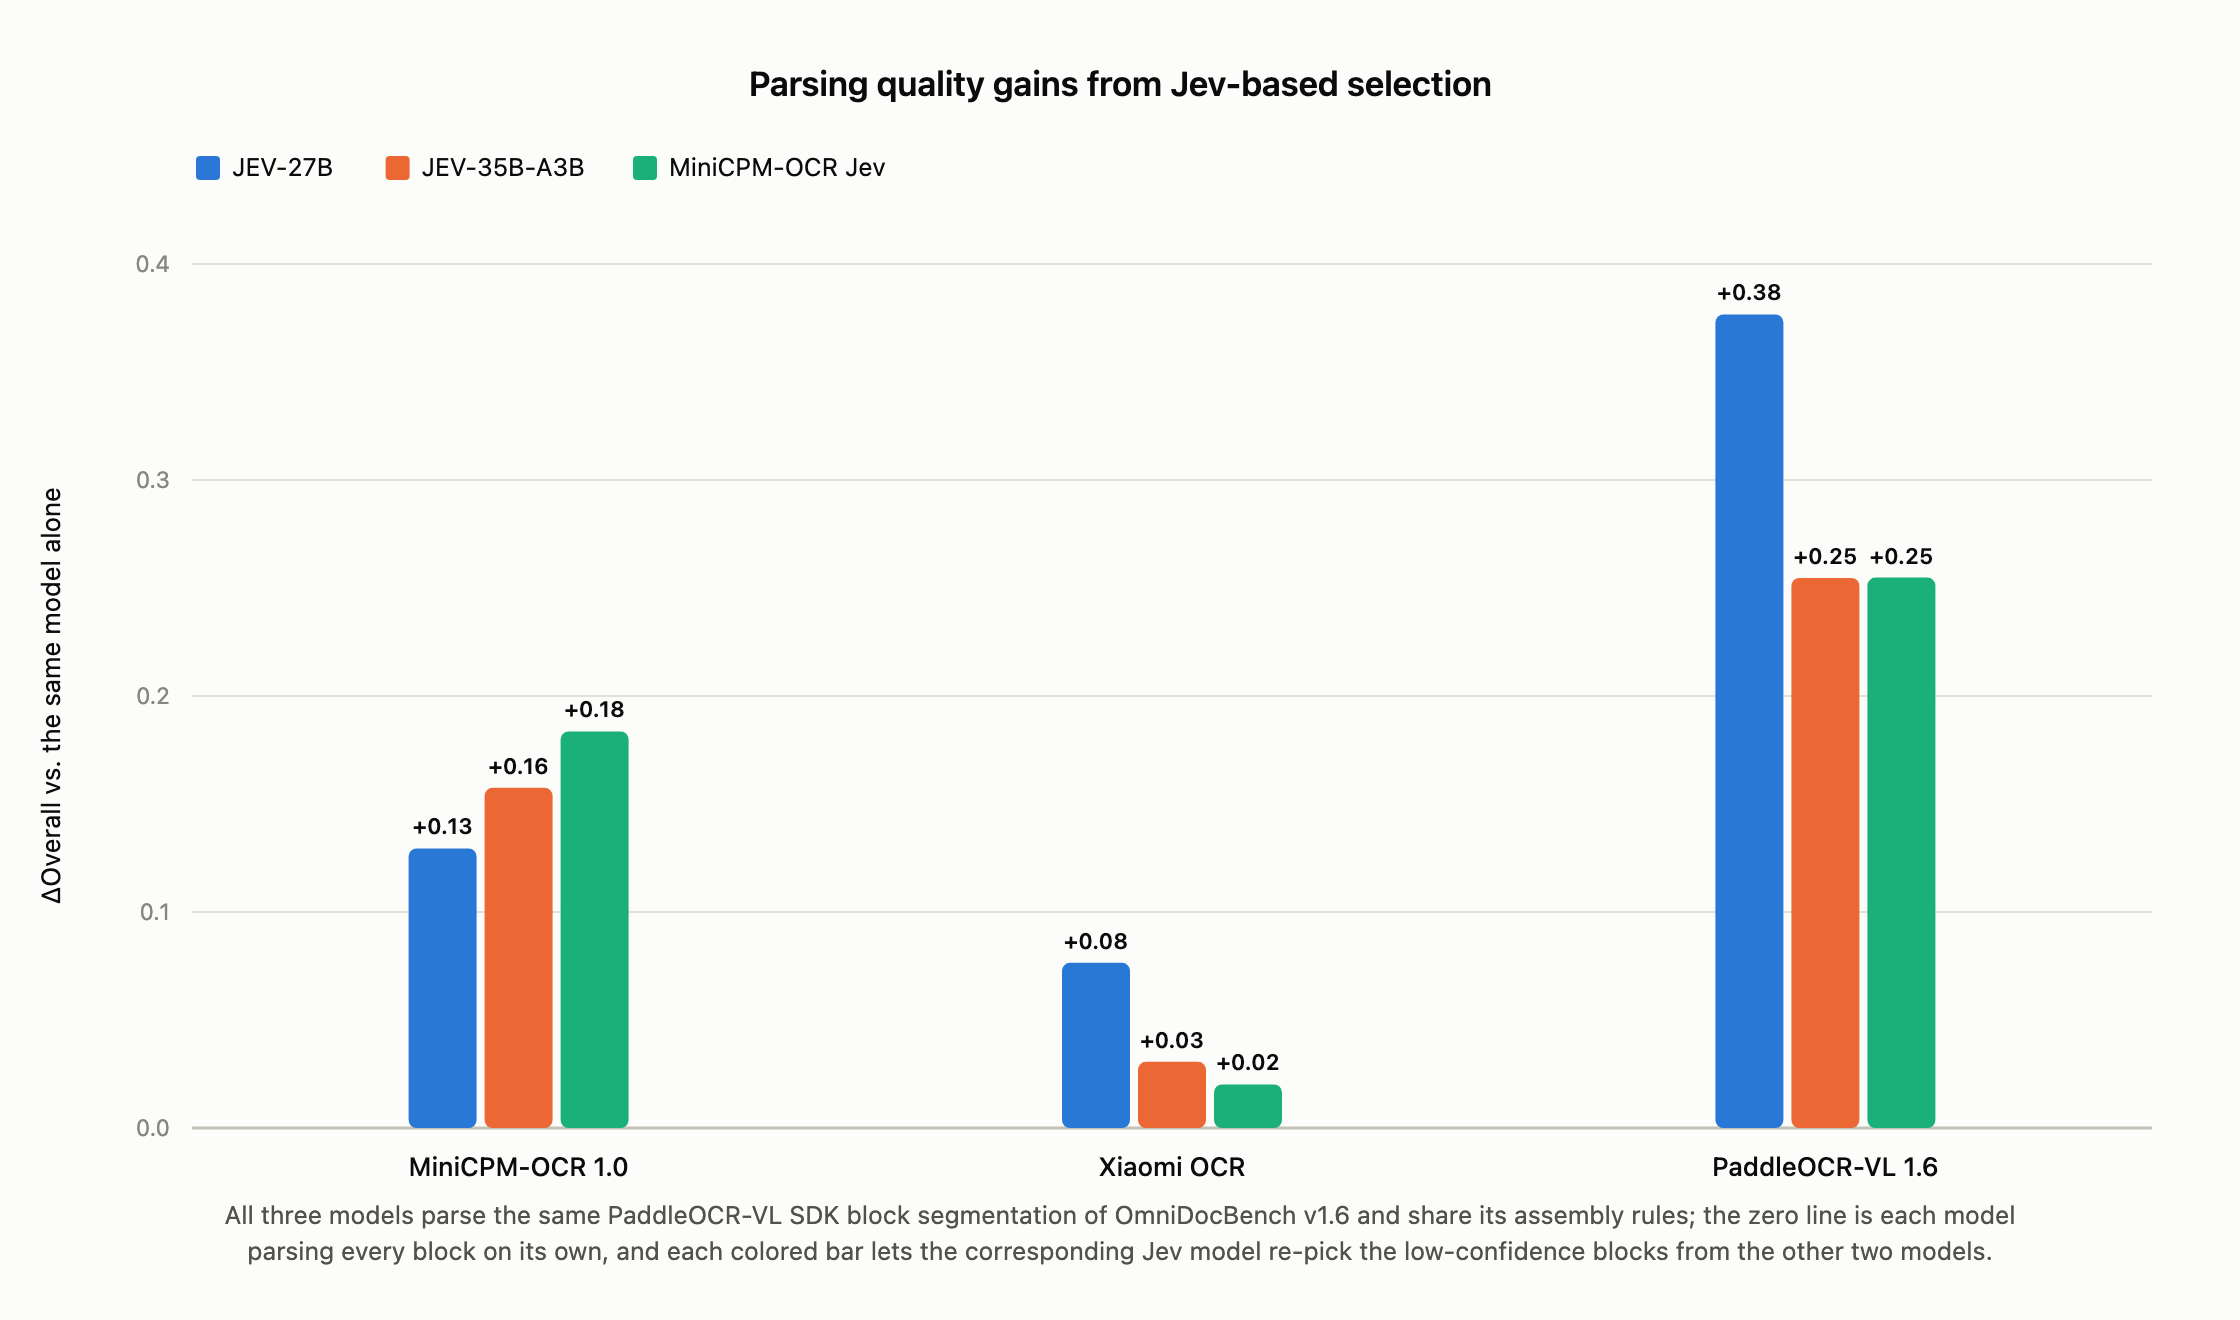
単位:改善点数
| パーサーグループ | JEV-27B | JEV-35B-A3B | MiniCPM-OCR Jev |
|---|---|---|---|
| MiniCPM-OCR 1.0 | 0.13 | 0.16 | 0.18 |
| Xiaomi OCR | 0.08 | 0.03 | 0.02 |
| PaddleOCR-VL 1.6 | 0.38 | 0.25 | 0.25 |
選ぶ際の基準
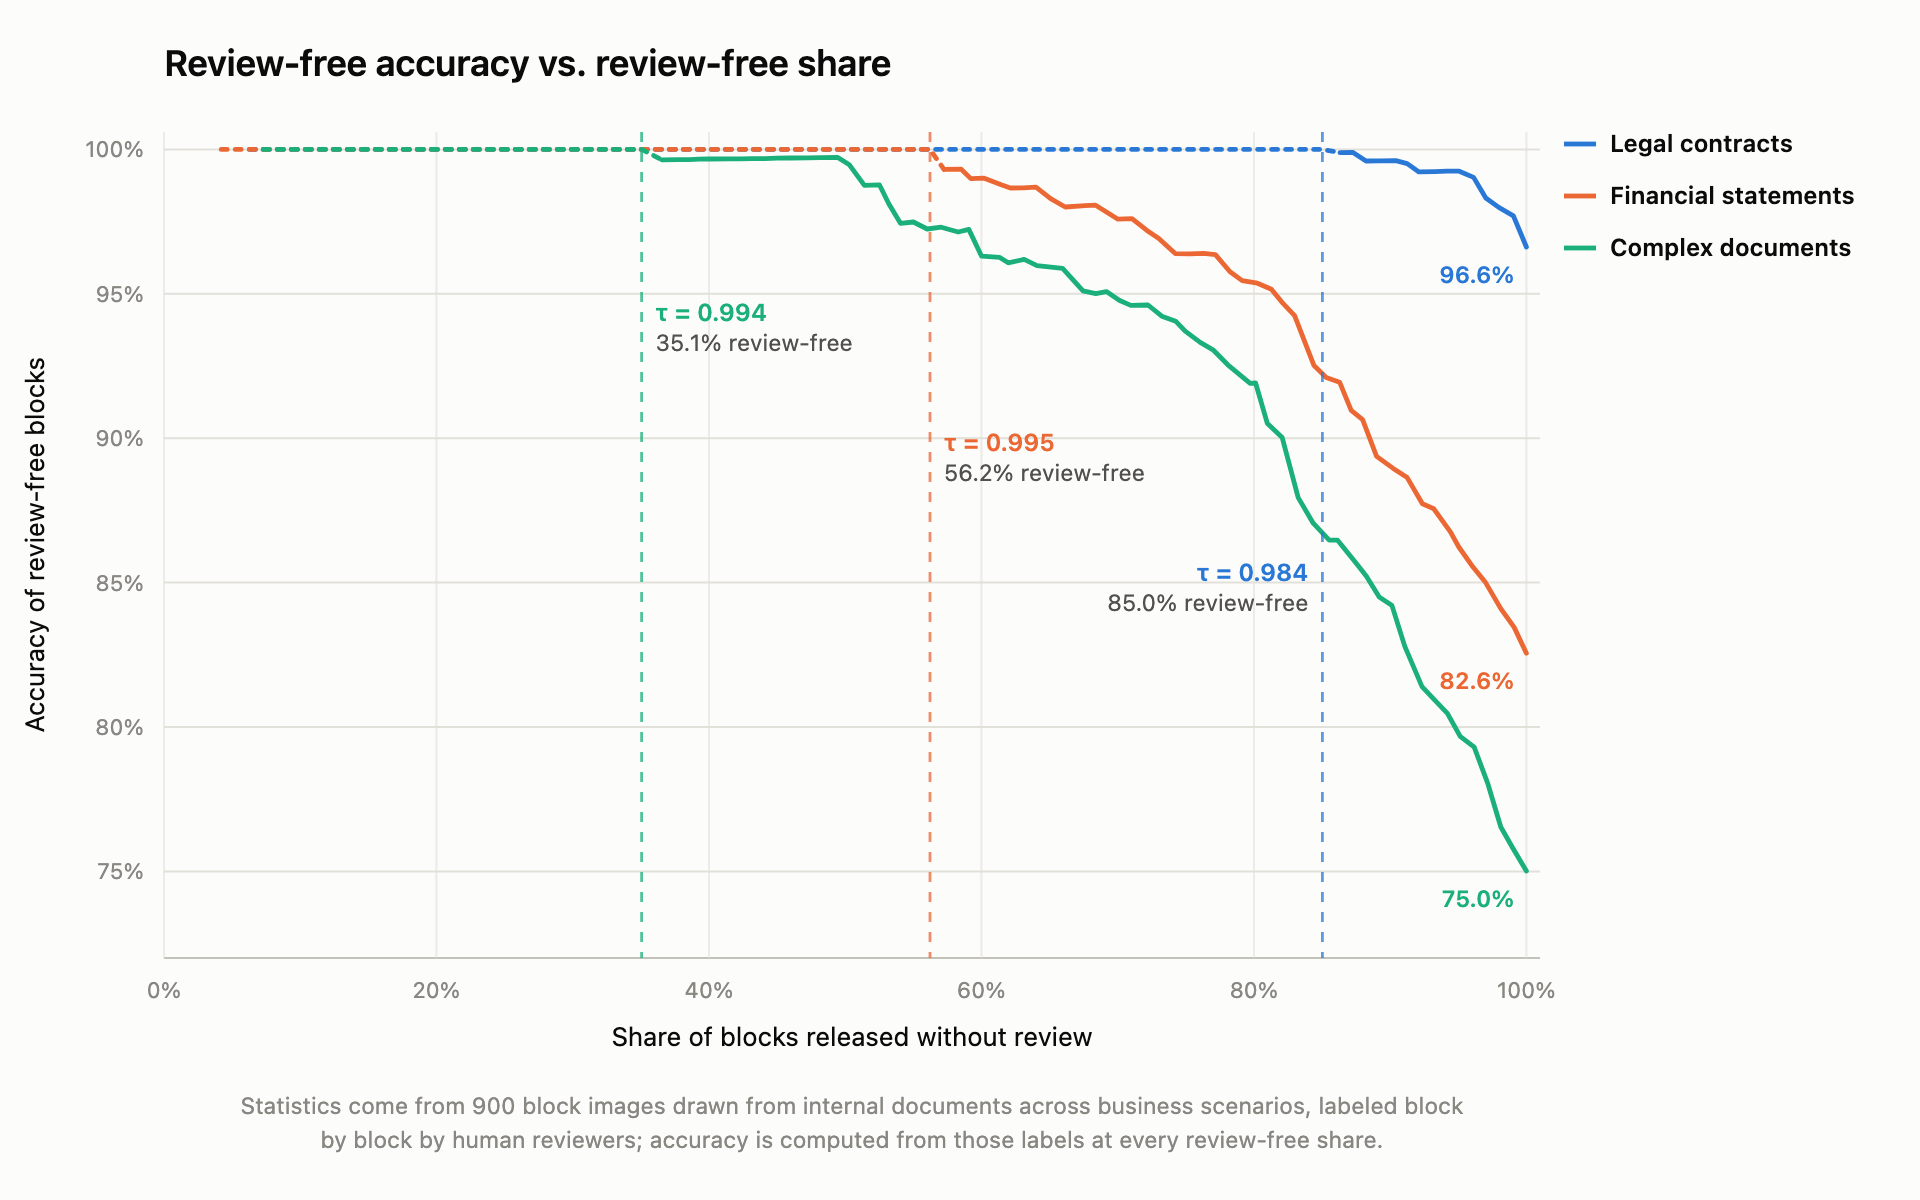
自動通過の基準となるしきい値は、自社データの人手ラベルに基づき、通過率と精度を併せて確認して決める。公式の例示図では、社内文書から抽出した900枚のブロック画像に人手でラベルを付け、確認なしで通過させる割合ごとの精度を計算した。図に示された確認なしの通過率は、法律契約書がしきい値0.984で85.0%、財務諸表が0.995で56.2%、複合文書が0.994で35.1%だった。
自分で起動するには、公式Docker/SDKローカルデプロイガイドに従い、VRAM 12GB以上のNVIDIA GPUと535以上のドライバーが必要だ。ディスク容量はモデル計算環境に約5~9GB、レンダリング環境に約1.5GB、重みに約2.5GBが必要となる。
スコアの絶対値を公開値と直接比較する予定なら、Dockerイメージを使う。OpenBMBのデプロイ文書によれば、DockerイメージのレンダリングはクラウドAPIと同じだ。独自にインストールしたSDKのレンダラーでは、スコア順位は維持されるが絶対値は少し異なる可能性がある。
レスポンスでは、まずverdict、つまり判定状態がscoredかを確認し、0.0と-1.0は採点失敗時の固定値として扱う。
categoryは実際のブロックの種類に合わせる必要がある。
以下はデプロイ文書の単一採点リクエストをPythonに置き換えた例だ。ローカルサービスが稼働しており、block.pngが対象テキスト領域の画像である場合に使う。
import base64
from pathlib import Path
import requests

response = requests.post("http://127.0.0.1:8030/v1/rm/score", json={
    "input_form": "ternary",
    "items": [{"case_id": "blk-001", "category": "text",
               "image": base64.b64encode(Path("block.png").read_bytes()).decode(),
               "ocr_text": "the OCR text to be scored"}]
})
response.raise_for_status()
result = response.json()["results"][0]
if result["verdict"] == "scored":
    print(result["prob_yes"])
else:
    print("Scoring failed:", result["verdict"])
デプロイ後は、例の3件のスコアを基準スコアと比較し、差が0.02以内かを確認すればよい。
候補再選択の最終的な品質は、すでに生成された候補の範囲と精度に左右される。
重みとコードはApache License 2.0で公開されており、元の重みと量子化済みの重みが提供される。デプロイはクラウドAPIとDocker・SDKに対応する。
小型の判定モデルはOCRをやり直す代わりに、既存候補の確認と再選択を支援する段階になり得る。