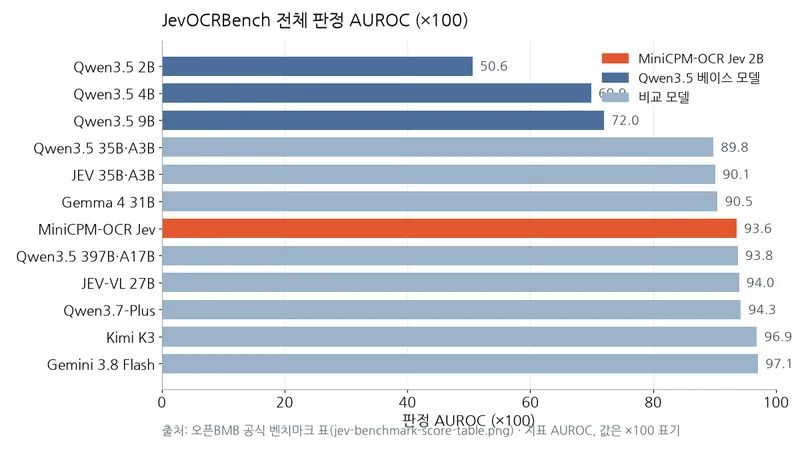
오픈BMB가 2026년 10월 27일 기존 OCR 결과를 판정하는 2B 모델 MiniCPM-OCR Jev를 공개했다. 텍스트·수식·표 영역마다 후보 인식 결과가 맞는지 0~1 점수로 매겨, 사람이 검수할 영역을 좁히거나 여러 후보 중 하나를 고르는 데 쓴다.
결과
오픈BMB 모델 가이드에 따르면 MiniCPM-OCR Jev는 JevOCRBench에서 정오답 구분 능력인 AUROC의 100배값 93.6을 기록했다. 작은 2B 모델을 기존 OCR 뒤에 붙여 검수와 후보 재선택을 돕는 방식이다. 아래 두 표는 공식 PNG의 발표값을 Jev 계열과 일반 모델로 나눠 옮겼다.
별도 공식 SVG는 Jev 계열을 ‘Noul’ 설정(세부 설명 없음), 일반 모델을 판정 기준 지시문 사용으로 구분하므로 계열 간 점수차에는 평가 설정도 고려해야 한다. SVG의 MiniCPM 행은 93.5·94.5·93.1·91.0으로 PNG와 다르며, 아래 표는 PNG 수치만 옮겼다.
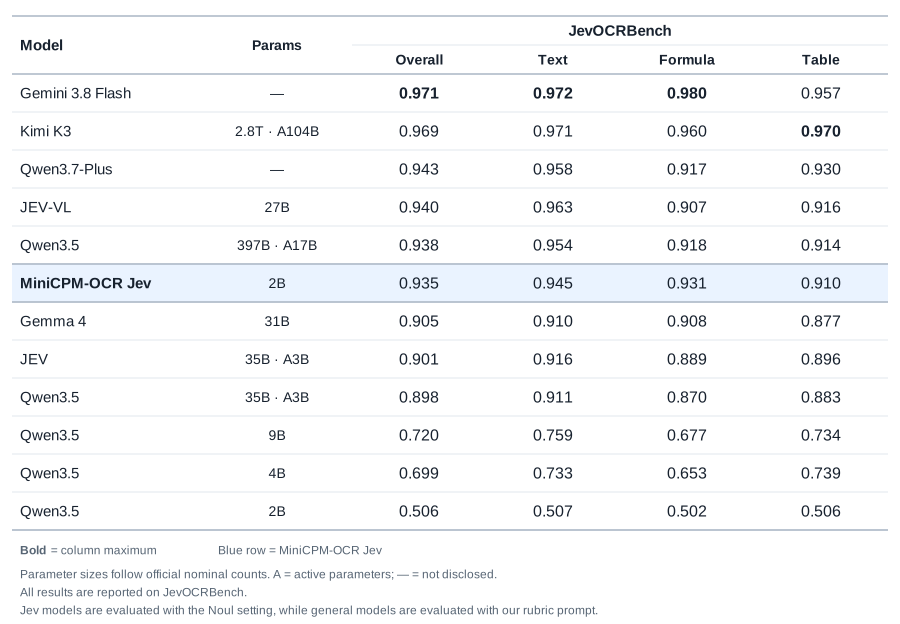
파라미터 표기에서 B는 10억 단위, A는 실제 활성화 파라미터 수를 뜻한다.
표: JevOCRBench 전체·카테고리별 판정 성능 — Jev 계열
조건: JevOCRBench 2,267건, 오픈BMB 공식 PNG 발표값
단위: AUROC 100배값
| 모델 | 파라미터 | 전체 | 텍스트 | 수식 | 표 |
|---|---|---|---|---|---|
| JEV 35B·A3B | 35B·A3B | 90.1 | 91.6 | 88.9 | 89.6 |
| MiniCPM-OCR Jev | 2B | 93.6 | 94.6 | 93.1 | 91.1 |
| JEV-VL 27B | 27B | 94.0 | 96.3 | 90.7 | 91.6 |
표: JevOCRBench 전체·카테고리별 판정 성능 — 일반 모델
조건: JevOCRBench 2,267건, 오픈BMB 공식 PNG 발표값
단위: AUROC 100배값
| 모델 | 파라미터 | 전체 | 텍스트 | 수식 | 표 |
|---|---|---|---|---|---|
| Qwen3.5 2B | 2B | 50.6 | 50.7 | 50.2 | 50.6 |
| Qwen3.5 4B | 4B | 69.9 | 73.3 | 65.3 | 73.9 |
| Qwen3.5 9B | 9B | 72.0 | 75.9 | 67.7 | 73.4 |
| Qwen3.5 35B·A3B | 35B·A3B | 89.8 | 91.1 | 87.0 | 88.3 |
| Gemma 4 31B | 31B | 90.5 | 91.0 | 90.8 | 87.7 |
| Qwen3.5 397B·A17B | 397B·A17B | 93.8 | 95.4 | 91.8 | 91.4 |
| Qwen3.7-Plus | 미공개 | 94.3 | 95.8 | 91.7 | 93.0 |
| Kimi K3 | 2.8T·A104B | 96.9 | 97.1 | 96.0 | 97.0 |
| Gemini 3.8 Flash | 미공개 | 97.1 | 97.2 | 98.0 | 95.7 |
발표값에서 MiniCPM-OCR Jev는 JEV-35B-A3B의 90.1을 넘고, Qwen3.5-397B-A17B의 93.8에는 0.2점 뒤처졌다. 추가 학습 전 기본 모델인 Qwen3.5-2B는 50.6이었다. 카테고리별로 보면 MiniCPM-OCR Jev는 텍스트에서 가장 높고 표에서 가장 낮았다.
측정 방법
평가는 오픈BMB가 만든 JevOCRBench 데이터셋에서 이뤄졌다. 중영문 2,267건이 텍스트 47.7%, 수식 24.7%, 표 27.6% 구성이고, 각 레코드에는 원본 영역 이미지와 후보 텍스트, 후보를 그린 이미지와 사람이 매긴 정오답 표시가 들어 있다. 오답 후보는 최정상급 OCR 모델의 실제 오류 출력에서 뽑아 사람이 라벨링했다. 채점 입력은 원본 영역 이미지 → 후보 텍스트 → 후보 텍스트를 그린 이미지 세 가지로 고정돼 있으며, 지표는 정답과 오답을 나누는 능력인 AUROC다.
오픈BMB의 파서 교차 평가에서는 OCR 결과를 구조화하는 도구인 파서를 바꿔도 판정 성능이 크게 흔들리지 않았다. JevOCRBench에서 무작위로 뽑은 같은 200개 샘플에 네 파서를 각각 돌리고 사람이 정오답을 라벨링한 실험이다.
표: 파서별 판정 성능
조건: JevOCRBench에서 무작위 추출한 동일 200개 샘플, 네 파서 독립 실행, 오픈BMB 자체 평가
단위: AUROC 100배값
| 후보 파서 | MiniCPM-OCR 1.0 | GLM-OCR | PaddleOCR-VL-1.6 | Xiaomi-OCR-0 |
|---|---|---|---|---|
| AUROC 100배값 | 92.7 | 91.9 | 93.4 | 93.1 |
네 파서 결과의 차이는 1.5점 폭 안에 들어왔다.
왜 이런 차이가 나나
MiniCPM-OCR Jev는 Qwen3.5-2B에서 학습했고, 이미지를 특징값으로 바꾸는 비전 인코더와 언어 처리를 맡는 핵심 신경망인 언어 백본은 남긴 채 lm_head를 정답과 오답 두 가지만 가르는 이진 분류 헤드로 바꿨다.
채점 절차는 사전 검사 → 후보 텍스트 렌더링 → 모델 계산의 3단계로, 사전 검사에서 수식 블록은 LaTeX 문법을 검증한다. 후보를 이미지로 그려 원본 영역 이미지와 나란히 비교하는 방식이다. 오픈BMB 배포 문서는 렌더 단계가 후보 텍스트를 이미지로 그려 모델이 레이아웃을 보게 한다고 설명한다.
오픈BMB 발표 기준으로 같은 방식으로 문서 영역을 나누고 후보를 다시 골랐을 때, 각 파서의 단독 처리 결과보다 파싱 품질이 개선됐다. MiniCPM-OCR Jev의 개선 폭은 MiniCPM-OCR 1.0에서 0.18점, Xiaomi OCR에서 0.02점, PaddleOCR-VL 1.6에서 0.25점으로 달랐다. 이 +0.02~+0.25점은 판정 AUROC가 아니라 문서 파싱 전체 점수의 개선량이다. 같은 판정 모델을 붙여도 파서별 이득은 균일하지 않았다.
표: Jev 후보 재선택에 따른 파싱 품질 개선
조건: 세 파서는 OmniDocBench v1.6의 PaddleOCR-VL SDK 블록 분할과 조립 규칙을 공유했다. 각 파서 단독 처리를 기준선으로 삼아 다른 두 모델의 후보에서 저신뢰 블록을 재선택한 결과는 오픈BMB 공식 그림에 제시됐다.
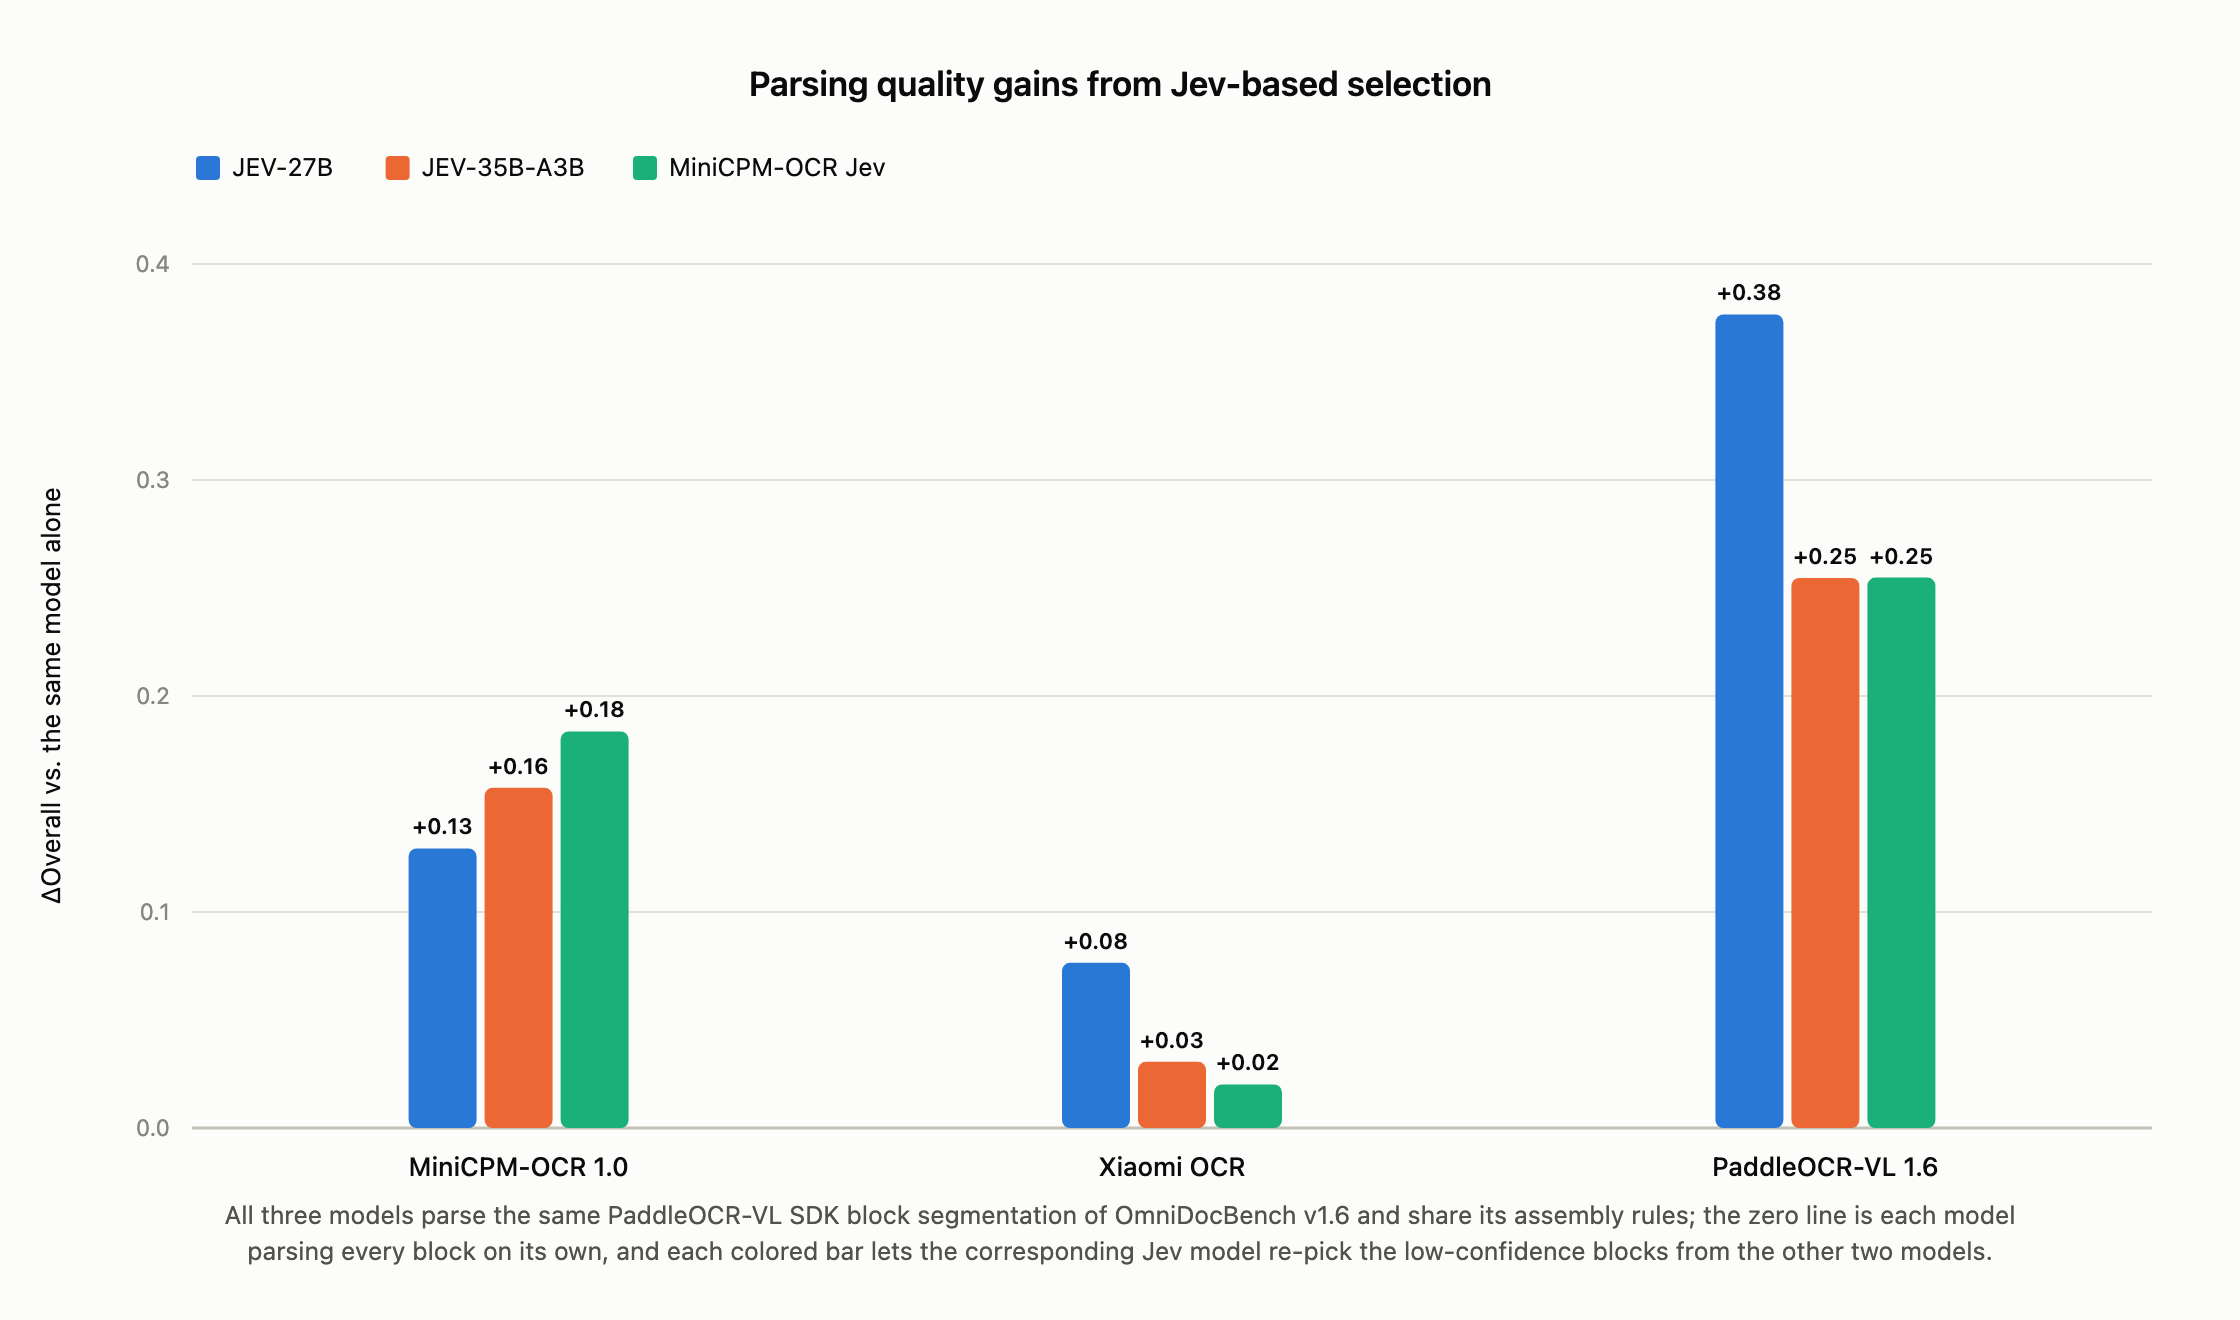
단위: 점 개선
| 파서 그룹 | JEV-27B | JEV-35B-A3B | MiniCPM-OCR Jev |
|---|---|---|---|
| MiniCPM-OCR 1.0 | 0.13 | 0.16 | 0.18 |
| Xiaomi OCR | 0.08 | 0.03 | 0.02 |
| PaddleOCR-VL 1.6 | 0.38 | 0.25 | 0.25 |
고를 때 기준
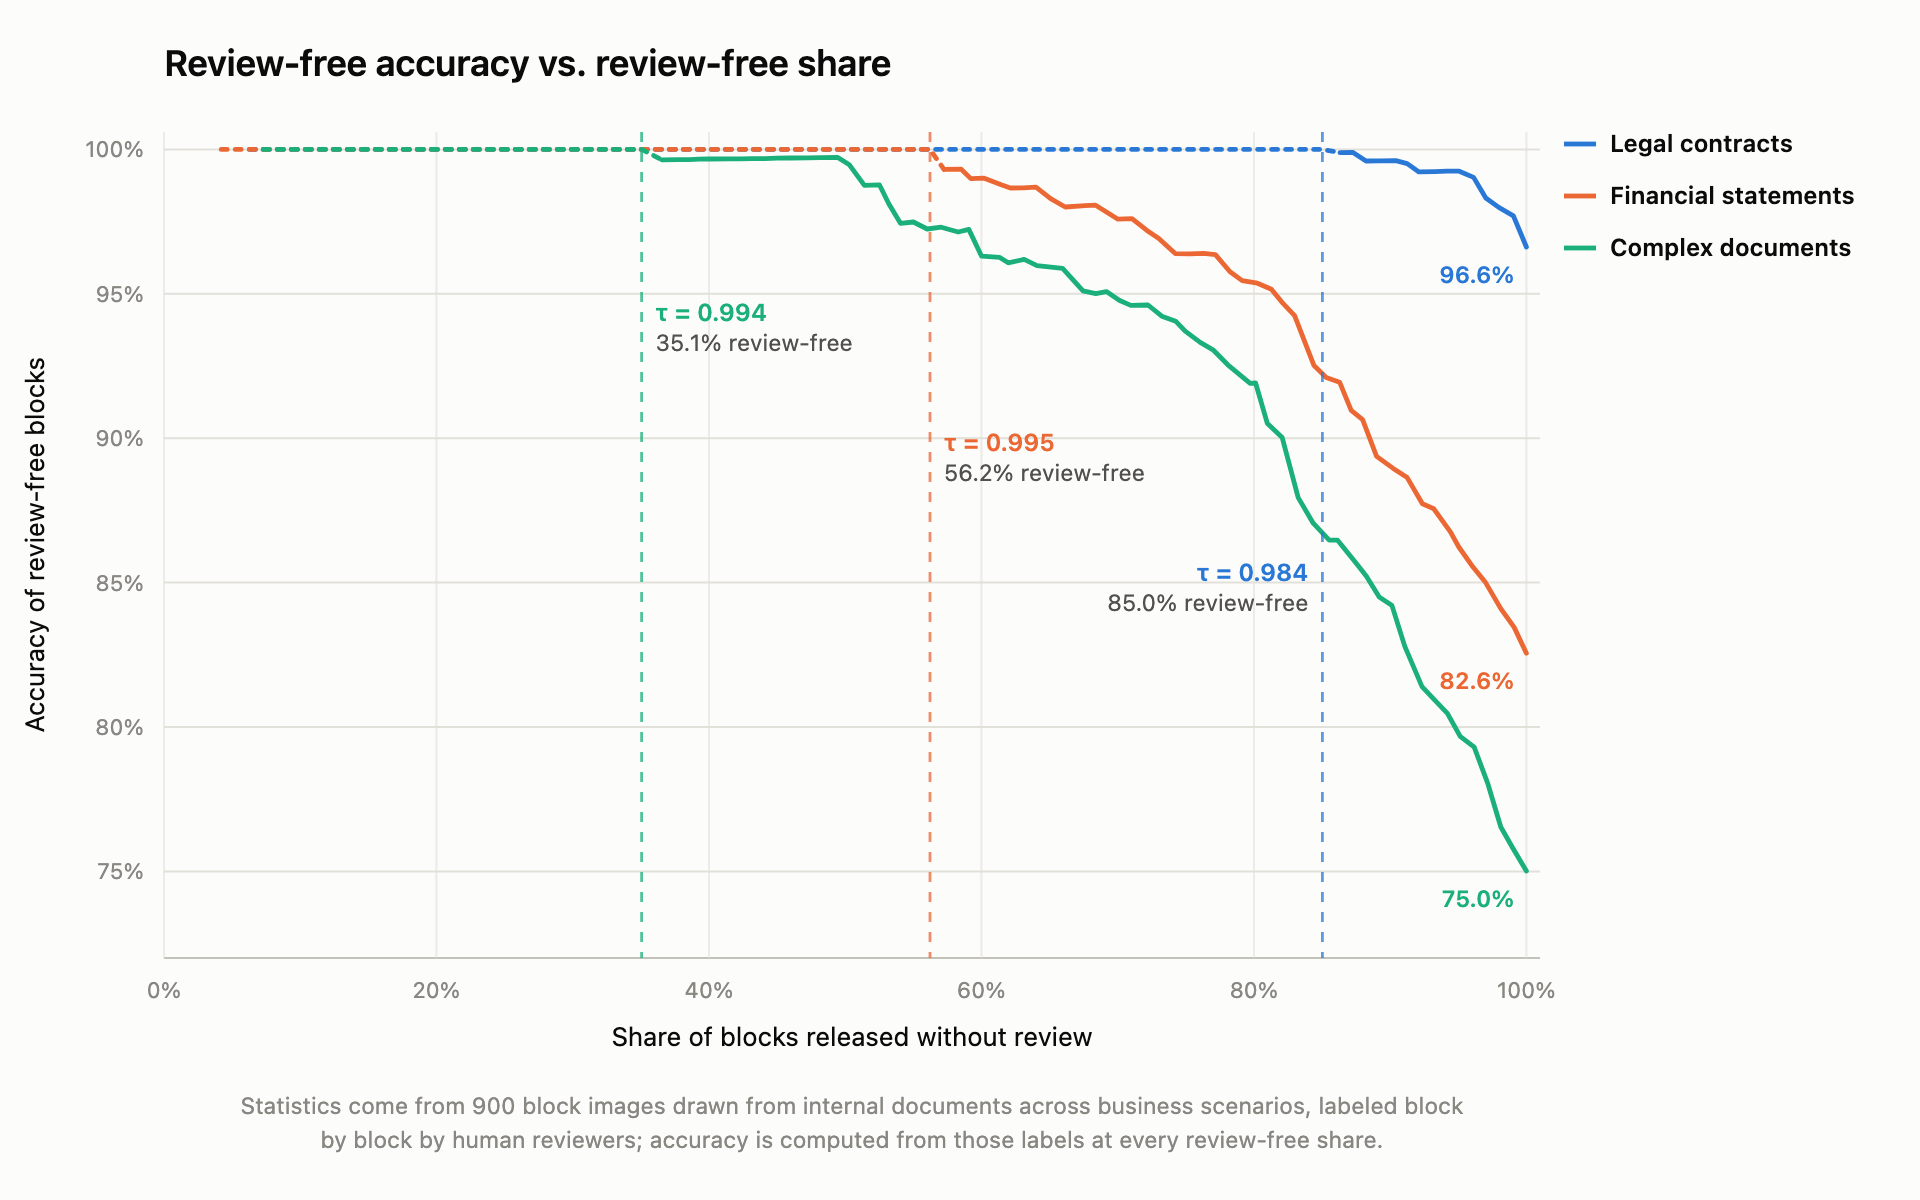
자동 통과 기준선인 임계값은 자기 데이터의 사람 라벨을 바탕으로 통과 비율과 정확도를 함께 확인해 정한다. 공식 예시 그림은 사내 문서에서 뽑은 900개 블록 이미지에 사람 라벨을 붙여 리뷰 없이 통과시키는 비율별 정확도를 계산했다. 그림에 표시된 무검수 통과 비율은 법률 계약서가 임계값 0.984에서 85.0%, 재무제표가 0.995에서 56.2%, 복합 문서가 0.994에서 35.1%였다.
직접 띄워 보려면 공식 Docker/SDK 로컬 배포 가이드 기준으로 NVIDIA GPU 12GB 이상 VRAM과 드라이버 535 이상이 필요하다. 디스크는 모델 계산 환경 약 5~9GB와 렌더 환경 약 1.5GB, 가중치 약 2.5GB가 필요하다.
점수 절대값을 공개 수치와 직접 비교할 계획이면 Docker 이미지를 쓴다. 오픈BMB 배포 문서에 따르면 Docker 이미지의 렌더는 클라우드 API와 같고, 자체 설치 SDK 렌더러는 점수 순위가 유지되지만 절대값은 조금 달라질 수 있다.
응답에서는 verdict, 즉 판정 상태가 scored인지 먼저 보고 0.0과 -1.0은 채점 실패 때의 고정값으로 읽는다.
category는 실제 블록 종류와 맞춰야 한다.
다음은 배포 문서의 단일 채점 요청을 Python으로 옮긴 예다. 로컬 서비스가 실행 중이고, block.png가 해당 텍스트 영역 이미지일 때 사용한다.
import base64
from pathlib import Path
import requests

response = requests.post("http://127.0.0.1:8030/v1/rm/score", json={
    "input_form": "ternary",
    "items": [{"case_id": "blk-001", "category": "text",
               "image": base64.b64encode(Path("block.png").read_bytes()).decode(),
               "ocr_text": "the OCR text to be scored"}]
})
response.raise_for_status()
result = response.json()["results"][0]
if result["verdict"] == "scored":
    print(result["prob_yes"])
else:
    print("Scoring failed:", result["verdict"])
배포를 마친 뒤에는 예제 3건의 점수를 기준 스코어와 비교해 0.02 이내 차이인지 확인하면 된다.
후보 재선택의 최종 품질은 이미 만들어진 후보의 범위와 정확도에 달려 있다.
가중치와 코드는 Apache License 2.0으로 공개됐으며, 원본과 양자화 가중치를 제공한다. 배포는 클라우드 API와 Docker·SDK를 지원한다.
작은 판정 모델은 OCR을 다시 수행하는 대신, 기존 후보의 검수와 재선택을 돕는 단계가 될 수 있다.