继9月30日的发布报道后,10月14日查看的Ling-3.1-flash模型卡标注MIT许可,并给出SGLang与vLLM部署示例。参数总量为560B,每Token激活25B。
100万与262,144 Token的差异
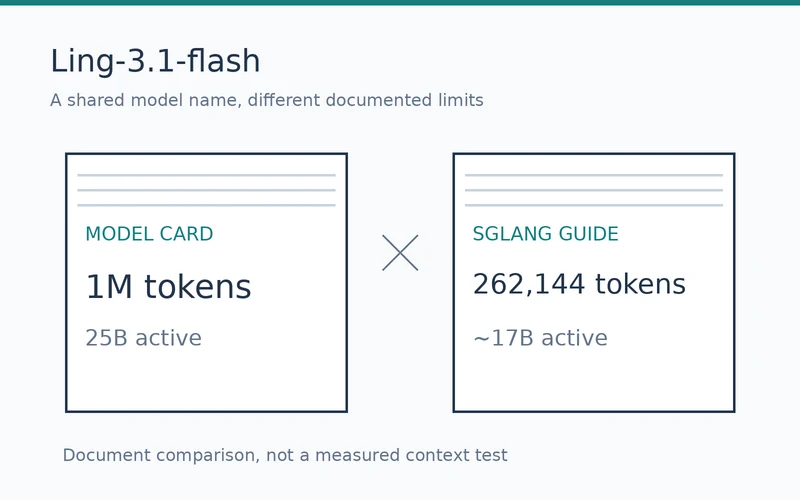
模型卡写100万Token上下文,SGLang部署指南则列出262,144 Token。激活参数也分别写25B和约17B。现有文档不足以确认差异来自统计方法还是错误记载。
模型架构与SGLang部署配置
模型组合63层KDA和9层Gated MLA,每个Token从512个路由专家中选择8个。SGLang介绍了适配该架构的FP8部署镜像及NEXTN附加Token预测。
处理长文档时,实际服务器配置的限制比100万Token的宣传值更重要。官方示例采用8张H200或4张GB300,仅凭激活25B不能推断内存需求很低。
Artificial Analysis同时显示智能指数41分和“权重未公开”标签,与标注MIT并提供部署示例的模型卡不一致。评估得分与权重公开状态需要分别核对。
自托管时应核对选定检查点与服务器实际配置的上下文限制。模型卡写100万Token不代表这一长度已经运行验证。
Ling-3.1-flash的实际部署范围取决于检查点与服务器配置是否一致,而非仅由模型卡标称值决定。