9월 30일 발표 보도 이후, 10월 14일 확인한 Ling-3.1-flash 모델 카드에는 MIT 라이선스와 SGLang·vLLM 실행 예제가 실렸다. 전체 규모는 560B, 토큰당 활성 파라미터는 25B로 적혀 있다.
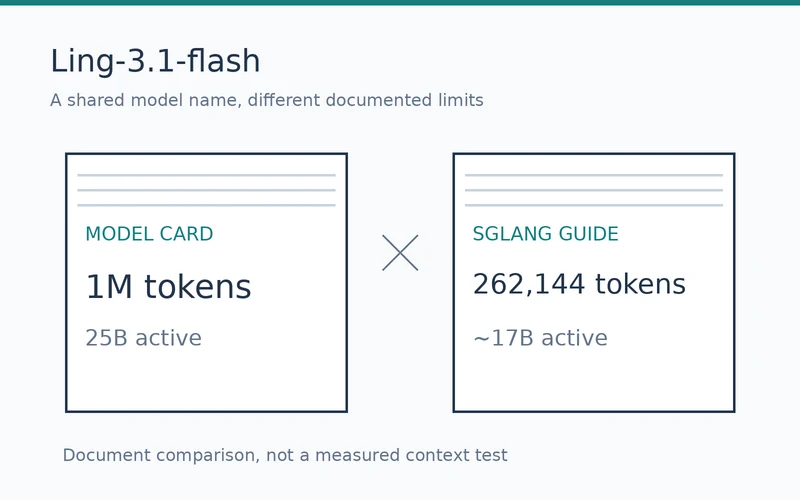
100만 토큰과 262,144토큰의 차이
모델 카드는 문맥 길이를 100만 토큰으로 적지만 SGLang 배포 안내는 262,144토큰을 제시한다. 활성 파라미터도 각각 25B와 약 17B로 다르다. 공개 자료만으로 집계 기준 차이인지 표기 오류인지 확정하기 어렵다.
모델 구조와 SGLang 실행 설정
모델은 63개 KDA 층과 9개 Gated MLA 층을 섞고, 토큰 처리 때 512개 분기 전문가 중 8개를 선택한다. SGLang은 이 구조에 맞춘 FP8 실행 이미지와 NEXTN 추가 토큰 예측 기능을 안내한다.
긴 문서를 처리할 때는 모델 카드의 100만 토큰보다 실제 서버에 적용한 한도가 중요하다. 공식 예시도 H200 8장이나 GB300 4장을 사용하므로 활성 25B만 보고 메모리 요구량을 판단하기 어렵다.
Artificial Analysis는 지능 지수 41점과 '가중치 미공개' 분류를 함께 표시한다. 이는 MIT 라이선스와 실행 예제를 제공하는 모델 카드의 현재 내용과 다르다. 평가 점수와 공개 상태는 따로 확인할 정보다.
자가호스팅에서는 사용할 체크포인트와 서버의 문맥 설정을 함께 확인할 수 있다. 모델 카드의 100만 토큰 표기만으로 그 길이의 실행이 검증된 것은 아니다.
Ling-3.1-flash의 실제 배포 가능 범위는 모델 카드보다 체크포인트와 서버 설정의 일치 여부가 결정한다.