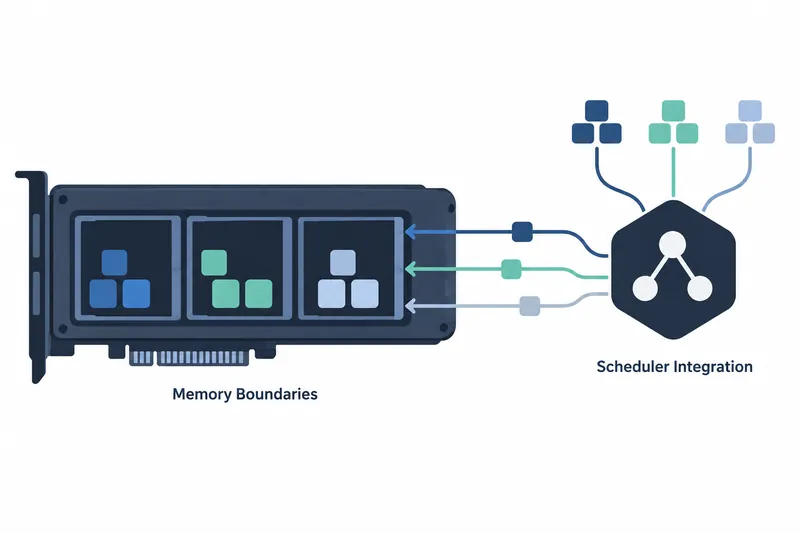
NVIDIA가 CUDA 13.4에서 GPU를 나눠 쓰는 작업마다 메모리 한도를 강제하는 기능을 공개했다. GPU 일부만 필요한 작업을 운영하는 개발·인프라 팀은 쿠버네티스에서 작업별 몫을 배정하고 실제 사용 한도까지 적용할 수 있다.
1. CUDA 13.4가 메모리 몫을 강제한다
GPU 공유에는 하드웨어 격리 인스턴스로 나누는 MIG, 프로세스가 GPU를 번갈아 쓰는 time-slicing, 별도 주소 공간에서 동시에 실행하는 MPS 방식이 있다. NVIDIA는 CUDA 13.4의 메모리 경계 강제를 통해 공유 작업이 설정된 한도만큼의 메모리만 보도록 한다. 한도를 생략해 요청량으로 고정한 경우, 요청보다 큰 할당은 작은 GPU에서처럼 실패한다.
작업은 고정된 메모리 크기를 요청하거나, 보장 최소값과 여유 메모리가 있을 때 늘어날 수 있는 최대값을 함께 설정할 수 있다. 연산 방식은 기본 time-slicing 또는 MPS의 sm-sharing을 선택한다. time-slicing은 작업별로 GPU 사용 차례를 나누고, sm-sharing은 스트리밍 멀티프로세서를 나눠 작업을 함께 실행한다.
2. 노드 설정을 자동 관리하는 구성 요소를 더한다
쿠버네티스에서 메모리 경계를 적용하려면 스케줄러의 작업 배치와 GPU 노드의 설정이 연결돼야 한다. 노드에서는 프로세스가 시작되기 전에 컨테이너별 메모리 한도와 연산 모드를 적용해야 한다.
이를 맡는 gpu-fractioning은 노드 설정을 자동 관리하는 오픈소스 쿠버네티스 오퍼레이터다. KAI Scheduler 조직이 공개했으며, 노드마다 MPS를 설정·실행하고 각 작업의 메모리 한도와 연산 모드를 적용한다.
드라이버와 컨테이너 실행 환경을 설정하는 NVIDIA GPU Operator와 함께 동작한다. 사용량도 GPU 전체가 아닌 작업별 몫으로 측정하므로, 운영팀은 각 작업이 메모리와 연산 자원을 얼마나 쓰는지 살필 수 있다.
3. 스케줄러가 배정한 몫을 컨테이너에 전달한다
스케줄러는 여유 메모리가 충분한 GPU를 고른 뒤 컨테이너별 Pod 어노테이션에 배정 정보를 기록한다. 어노테이션은 메모리 할당, 연산 모드, GPU 장치를 전달하는 설정 메모 역할을 한다. 오퍼레이터가 이를 읽어 노드에 적용하므로, 이 정보를 작성할 수 있는 쿠버네티스 스케줄러라면 연동할 수 있다.
개발자는 메모리를 절대 크기나 GPU 비율로 요청한다. 요청량은 보장받는 최소 몫이고, 별도의 한도를 지정하면 여유 메모리가 있을 때 그 한도까지 늘려 쓸 수 있다. 한도는 선택 사항이며 생략하면 요청한 크기로 제한된다.
4. KAI Scheduler는 설치 설정으로 연동을 켠다
KAI Scheduler는 gpu-fractioning과 연동된 첫 스케줄러다. 버전 0.18.0부터 새 GPU 공유 모드를 제공한다.
이 모드인 NvFractions는 GPU별 몫을 정하고 어노테이션으로 오퍼레이터에 전달한다. 기존 공유 모드도 유지되며, 관리자는 클러스터별로 사용할 모드를 선택한다. 설치할 때 다음 설정을 주면 gpu-fractioning도 의존성으로 설치된다.
helm upgrade -i kai-scheduler oci://ghcr.io/kai-scheduler/kai-scheduler/kai-scheduler \
  -n kai-scheduler --create-namespace \
  --set global.nvFractions.set=true
5. 시간 분할과 동시 실행의 절충
time-slicing은 작업들이 GPU 전체를 번갈아 쓰며, 한 작업의 오류가 다른 작업에 번지지 않도록 분리한다. sm-sharing은 연산 장치를 작업들에 필요에 따라 배분해 동시에 실행한다. NVIDIA의 동작 설명에 따르면 공유 작업 수가 n이고 모두 바쁠 때 두 방식 모두 작업당 대략 1/n의 연산 몫을 얻으며, 남는 자원은 다른 작업이 활용한다.
동시 실행에서는 작업들이 오류의 영향을 함께 받는 영역을 공유하므로, 서로 신뢰할 수 있는 작업끼리 묶는 것이 권장된다. 한 GPU에는 한 번에 한 연산 모드만 적용되며, KAI Scheduler는 이를 GPU별로 추적해 같은 노드의 서로 다른 GPU에 두 모드를 배치할 수 있다.
이익은 GPU 일부만 필요한 작업을 함께 배치하고 각 몫의 사용량을 살필 수 있다는 점이다. 대신 운영팀은 노드의 오퍼레이터와 MPS를 관리하고, 스케줄러가 배정 정보를 올바르게 전달하도록 구성해야 한다. 공유로 남는 자원을 활용하는 대신 배치와 노드 설정을 함께 관리하는 일이 더해진다.
CUDA의 메모리 경계 강제와 스케줄러 연동은 GPU 공유를 단순한 동시 사용에서 작업별 자원 몫 관리로 확장한다.