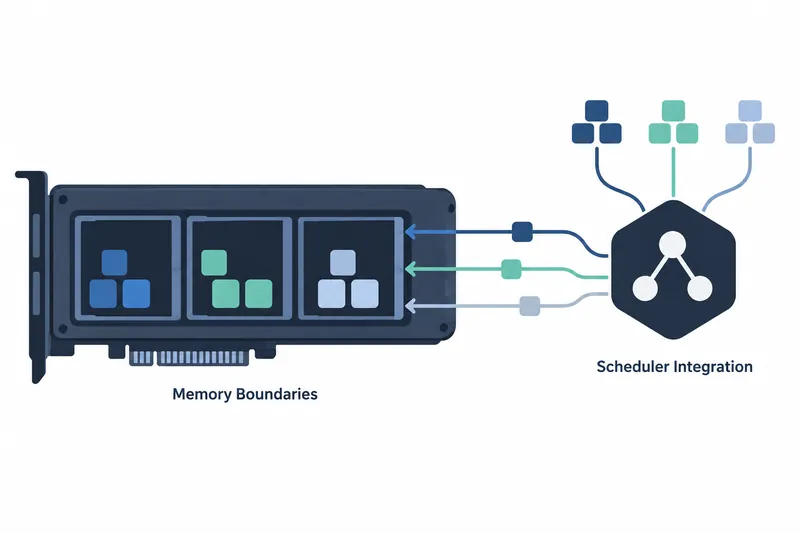
NVIDIA 在 CUDA 13.4 中推出了对共享 GPU 的各项任务强制实施内存上限的功能。运行仅需部分 GPU 资源的任务时,开发与基础设施团队可在 Kubernetes 中为各任务分配份额,并落实实际使用上限。
1. CUDA 13.4 强制实施内存份额限制
GPU 共享方式包括划分硬件隔离实例的 MIG、让进程轮流使用 GPU 的 time-slicing,以及在独立地址空间中并发执行的 MPS。NVIDIA 通过 CUDA 13.4 的强制内存边界,让共享任务只能看到设定额度内的内存。如果省略上限,使其固定为请求量,超过请求量的分配就会像在较小的 GPU 上一样失败。
任务可以请求固定大小的内存,也可以同时设置有保障的最小值,以及在有空闲内存时可扩展到的最大值。计算方式可选择默认的 time-slicing 或 MPS 的 sm-sharing。time-slicing 让各任务轮流使用 GPU,sm-sharing 则划分流式多处理器,让任务同时运行。
2. 新增自动管理节点配置的组件
要在 Kubernetes 中落实内存边界,必须将调度器的任务放置与 GPU 节点配置连接起来。节点需要在进程启动前,应用各容器的内存上限和计算模式。
承担这一职责的 gpu-fractioning 是一个自动管理节点配置的开源 Kubernetes Operator。它由 KAI Scheduler 组织发布,可在每个节点上配置并运行 MPS,并应用各任务的内存上限和计算模式。
它与负责配置驱动程序和容器运行环境的 NVIDIA GPU Operator 协同工作。使用量也按各任务的份额而非整个 GPU 来计量,因此运维团队可以查看每项任务使用了多少内存和计算资源。
3. 将调度器分配的份额传递给容器
调度器选择空闲内存充足的 GPU 后,将分配信息写入各容器对应的 Pod 注解。注解充当配置备注,传递内存分配、计算模式和 GPU 设备信息。Operator 读取这些信息并应用到节点上,因此任何能写入这些信息的 Kubernetes 调度器都可以与之集成。
开发者可以按绝对大小或 GPU 占比请求内存。请求量是有保障的最小份额,另行指定上限后,在有空闲内存时可扩展使用至该上限。上限为可选项,省略时使用量将被限制在请求大小。
4. KAI Scheduler 通过安装配置启用集成
KAI Scheduler 是首个与 gpu-fractioning 集成的调度器。它从版本 0.18.0 起提供新的 GPU 共享模式。
这一名为 NvFractions 的模式为每个 GPU 确定份额,并通过注解传递给 Operator。原有共享模式仍然保留,管理员可为每个集群选择使用的模式。安装时提供以下配置,gpu-fractioning 也会作为依赖项安装。
helm upgrade -i kai-scheduler oci://ghcr.io/kai-scheduler/kai-scheduler/kai-scheduler \
  -n kai-scheduler --create-namespace \
  --set global.nvFractions.set=true
5. 时间分片与并发执行的权衡
time-slicing 让任务轮流使用整个 GPU,并进行隔离,避免一项任务的故障波及其他任务。sm-sharing 则按需向任务分配计算单元,让它们并发执行。根据 NVIDIA 的运行机制说明,当共享任务数为 n 且全部繁忙时,两种方式下每项任务都可获得约 1/n 的计算份额,空闲资源则由其他任务利用。
并发执行时,任务共享同一故障影响域,因此建议将彼此可信的任务放在一起。一个 GPU 同一时间只能应用一种计算模式,KAI Scheduler 会按 GPU 跟踪模式,因此可在同一节点的不同 GPU 上部署这两种模式。
好处在于,可以将仅需部分 GPU 资源的任务放在一起,并查看各份额的使用量。相应地,运维团队需要管理节点上的 Operator 和 MPS,并配置调度器以正确传递分配信息。在通过共享利用空闲资源的同时,也增加了统筹管理任务放置与节点配置的工作。
CUDA 的强制内存边界与调度器集成,让 GPU 共享从简单的同时使用扩展为按任务管理资源份额。