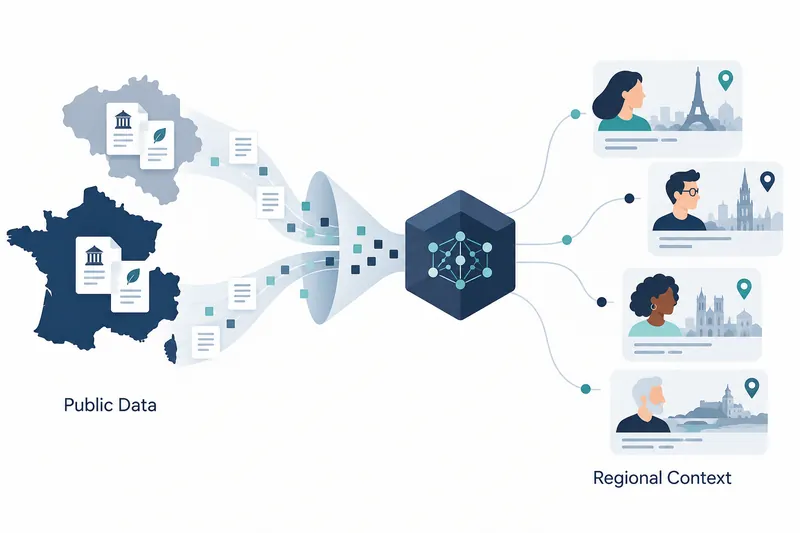
NVIDIA가 프랑스와 벨기에의 인구 통계·지역 맥락을 반영한 가상 주민 데이터와 이를 모델에 추가 학습시키는 절차를 공개했다. 현지 서비스 개발자는 주민 설정과 공식 절차 문서를 함께 써서, 지역별 규칙과 말투를 담은 대화로 공개 모델을 조정할 수 있다.
1. 주민 페르소나, 가상의 주민 역할 설정이 지역별 질문과 답을 구체화한다
NVIDIA는 프랑스 인공지능 스타트업 Pleias와 Nemotron-Personas-France를 만들었고, 벨기에 데이터셋은 Pleias 및 KU Leuven과 함께 개발했다. 회사는 두 자료를 12개국 지역 기반 페르소나 데이터 프로그램의 일부로 소개했다.
페르소나는 실제 사람이 아닌 가상의 주민이다. 프랑스 데이터의 인물은 인구 통계에 맞춘 나이와 자치단체, 직업, 가구 정보를 갖고 일과 생활을 묘사하는 프로필도 제공한다. 이 설정으로 사용자의 질문 표현이 달라지고, 지역별로 맞는 답도 달라질 수 있다.
블로그는 프랑스령 기아나의 여권 인지대가 43유로이고 본토 프랑스는 86유로라는 예를 들었다. 지역 인구 정보를 대화의 배경으로 연결해 언어뿐 아니라 실제 절차의 차이를 학습 데이터에 담는 방식이다.
벨기에 페르소나는 네덜란드어·프랑스어·독일어·영어를 아우른다. 다른 지역으로 적용 범위를 바꿀 때는 주민 데이터와 행동 기준, 검수 담당자를 교체하고 같은 절차를 활용하도록 안내한다.
2. 데이터 생성부터 모델 비교까지 이어지는 절차
워크플로, 작업을 순서대로 잇는 절차는 목표 행동과 평가 기준을 정하는 데서 시작한다. 예를 들어 답변 대상, 과업, 언어와 어조, 사용할 공식 정보, 안전 규칙, 답변 구조를 계약처럼 정하고 생성과 검수에 공통으로 적용한다. 튜토리얼은 선택 사항인 평가용 고정 세트로 흔한 질문과 예외·위험 상황을 포함한 100~300개의 사람이 작성한 질문 또는 개인을 알아볼 수 없게 처리한 비식별 운영 패턴을 제안한다.
이후 지역과 직업에 걸쳐 페르소나 2,000개를 뽑아 고객 질문과 답을 생성한다. 주민 설정은 질문의 표현을 다양하게 만드는 데 쓰고, 답변의 사실은 함께 제공한 공식 절차 문서에서 가져온다. 생성 답변은 별도 채점 모델로 검사하며, 여덟 건을 먼저 확인한 뒤 전체 생성을 진행한다.
데이터 감사, 오류와 정보 노출을 살피는 단계는 형식 오류와 남은 추론 문장, 페르소나 이름 노출 가능성을 걸러낸다. 나머지는 같은 페르소나가 학습·검증 양쪽에 섞이지 않도록 90대 10으로 나눠 평가에 쓸 데이터가 학습에 섞이는 일을 막는다.
예시 모델은 Nemotron 3.5 Lightning이다. LoRA, 적은 조정 변수만 학습하는 방식으로 별도의 작은 조정 가중치인 어댑터를 학습한 뒤 원래 모델에 합쳐 답변을 제공한다. 마지막에는 고정 질문을 원래 모델과 조정 모델에 똑같이 보내 답을 나란히 읽는다. NVIDIA는 에이전트보다 사람이 직접 평가하는 방식을 권한다.
git clone https://github.com/NVIDIA-NeMo/Nemotron.git
cd Nemotron
git checkout v0.2.0
uv sync --extra data-sdg --extra evaluator
uv run nemotron steps --help
주의: 확인한 저장소 상태에는 블로그가 안내한 예제 폴더가 없었다
블로그는 튜토리얼을 따라가려면 `use-case-examples/french-public-service-assistant/` 폴더를 쓰라고 안내하며, 그 아래에 설정 파일과 스크립트, sources와 eval 파일이 있다고 설명한다. 그러나 자료를 수집한 시점의 저장소 트리(main, sha 1c3e781)에는 그 폴더가 없었고, 태그 `v0.2.0`에도 없었다.
그 예제의 README를 받아온 결과는 `404: Not Found`였다. 즉 위 절차는 블로그에 문서화된 워크플로이지, 실행해 확인한 예제가 아니다. 같은 과정을 재현하려면 먼저 해당 폴더가 존재하는지 확인해야 한다.
3. 사례 평가에서 확인할 변화
회사 발표 기준, 프랑스 여권 질문에 대한 예시 답변에서 원래 모델은 공식 문서에 없는 우편 신청을 안내했다. 조정 모델의 예시 답변은 건강상 이동이 어려운 경우 담당자의 자택 방문을 요청하고 발급된 지 3개월 미만인 의료 증명서를 내도록 안내했다. 지역 적응의 평가 초점이 유창한 문장보다 올바른 신청 경로에 있다는 사례다.
평가 계획은 과업 정확성, 프랑스어 품질, 지역 적합성, 안전성, 견고성, 일반 지시 수행의 유지 등 여섯 영역을 둔다. 지역 표현이 적절한지와 페르소나 정보가 답에 새지 않았는지도 살핀다.
Pleias는 파트너사의 척추 케어 어시스턴트 Lamina에 프랑스·벨기에를 포함한 페르소나 자료를 활용한다. 소수의 실제 환자 사례에서 다양한 프로필의 학습 대화를 만들고 환자 유형별로 시험하는 용도다.
4. 필요한 자원과 데이터 관리의 맞교환
예시 환경은 Python 3.11~3.13과 GPU 컨테이너 실행 환경, Nemotron 저장소 접근을 전제로 한다. 하드웨어는 DGX Station GB300 한 대 또는 DGX Spark 한 대를 기준으로 제시하지만, 다른 NVIDIA GPU 시스템에도 조정할 수 있다고 안내한다. DGX Spark나 호스팅 API를 쓰면 생성량을 500~1,000건부터 시작하라는 권고도 포함됐다.
지역별 답변을 더 일관되게 만들고 드문 사례를 모델이 인공적으로 만든 합성 대화로 보완하는 대신, 생성·채점 API 비용과 GPU 자원, 사람의 검수 시간이 필요하다. 공식 절차와 행동 기준을 관리하고 재평가하는 일도 워크플로에 포함된다. NVIDIA는 페르소나 기반 데이터가 공정성이나 적절한 대표성을 보장하지 않는다고 밝혔다.
지역 맞춤형 후학습, 사전 학습된 모델을 추가 조정하는 과정의 핵심은 페르소나로 질문의 폭을 넓히되, 답의 근거는 공식 절차와 사람의 검수로 붙잡는 데 있다.